Metodo Cientifico Etapa

O que acontece quando você tenta aplicar método cientifico etapa em projetos reais
A primeira coisa que todo mundo aprende é que o método científico consiste em etapas. Observar, formular hipótese, testar, analisar dados, concluir. Parece uma lista de verificação tranquila, mas na prática as coisas se complicam muito antes de chegar ao primeiro gráfico pronto. Eu já perdi cerca de três semanas num projeto de integração de APIs porque segui a ordem rígida das etapas sem considerar que o problema de fundo estava na coleta de dados, não na análise. O código de inferência estava perfeito; a base era lixo. Aprender a reler o passo a passo depois da segunda falha é mais importante do que decorá-lo na primeira. Quando alguém pede pra descrever metodo cientifico etapa, a resposta costuma ser um manual genérico de metodologia. O que pouca gente mostra é que cada fase tem gargalos específicos que mudam conforme a área. Em ciência de dados, a maior armadilha é a etapa de formulação de hipótese, porque ela acaba sendo substituída por exploração cega de features. Em engenharia de software, o ponto crítico costuma ser a validação, onde times confundem teste automatizado com evidência real de comportamento. Eu já vi equipes ignorarem o passo de revisão por pares porque achavam que CI/CD substituía a crítica humana. Isso dá velocidade no curto prazo, mas gera dívida técnica que cobra juros altos depois. A estrutura clássica envolve seis etapas: observação, pergunta, hipótese, experimento, análise e conclusão. Na prática, essa ordem é mais um esqueleto do que um roteiro. A observação nunca é neutra, ela carrega vieses de quem observa. A pergunta pode ser mal formulada sem que ninguém perceba, especialmente quando o stakeholder quer uma resposta rápida para uma decisão que ainda nem aconteceu. A hipótese precisa ser falseável, mas em times apressados ela vira simplesmente "acho que vai dar certo". O experimento exige controle de variáveis, o que em sistemas complexos é quase impossível sem simulações ou ambientes isolados. A análise é onde a maioria dos erros aparece, principalmente quando pessoas aplicam testes estatísticos em dados que não atendem aos pressupostos. A conclusão fecha um ciclo, mas raramente aponta para a próxima iteração, que é onde o verdadeiro valor está.
Observação pede registro estruturado. Anotações soltas viram ruído. Eu costumo usar templates com campos fixos: data, condição inicial, ferramenta usada, resultado esperado versus real. Isso parece burocracia, mas reduz o tempo de reapresentação dos dados em torno de 40%, dependendo do tamanho do projeto. Formulação da hipótese é o passo onde a maturidade do pesquisador se mostra. Hipótese boa tem variáveis independentes e dependentes claras, escopo delimitado e critério de refutação. Se não existe forma de provar que está errada, não é hipótese, é opinião. Eu já perdi meia dúzia de horas tentando validar uma hipótese que, na verdade, era circular. O problema era interno, a solução foi reescrever do zero com variáveis mensuráveis. Experimentação não é só rodar o teste. É definir amostra, controle, randomização e poder estatístico antes de começar. Times que pulem esse preparo gastam até três vezes mais tempo corrigindo viés depois. Em experimentos A/B com tráfego baixo, o erro comum é interpretar variação aleatória como efeito. Um intervalo de confiança de 95% com mil amostras pequenas pode ser tão inútil quanto uma média populacional com dez pontos.
Análise de dados exige escolher a ferramenta certa para a pergunta certa. Teste t compara médias; qui-quadrado testa independência; regressão modela relação. Usar o teste errado por preguiça ou pressa gera conclusões enganosas com aparência de científica. Eu já vi analistas aplicarem correlação de Pearson em dados ordinais e publicar resultado como se fosse verdade absoluta. O dado não mente; a interpretação é que costuma mentir. Conclusão deve ser escrita antes de olhar o gráfico final. Isso evita o viés de confirmação, aquele em que o pesquisador ajusta a interpretação para caber no resultado desejado. Quando você define antecipadamente o que significaria aceitar ou rejeitar a hipótese, a conclusão vira relatório, não defesa.

Pitfalls avançados que iniciantes ignoram
A primeira armadilha é a Ilusão de Validade. Dados bonitos com modelos complexos dão falsa sensação de segurança. Na realidade, um modelo simples com features bem escolhidas supera um ensemble treinado sobre dados sujos. A segunda é a maldição do conhecimento: quem domina o assunto tende a pular passos que parecem óbvios, mas são essenciais para quem está começando. A terceira é a tentação de iterar até achar significado. Se você testa hipóteses suficientes, eventualmente uma vai dar p valor menor que 0,05 por acaso. Isso se chama data dredging e é um dos maiores problemas de reproduzibilidade empublicações científicas. p-hacking é a prática de ajustar parâmetros até encontrar significância estatística. Em times comerciais, isso é disfarçado de "ajuste fino de segmentação". O custo é alto: decisões baseadas nesses resultados falham em 60% a 80% dos casos quando replicados em populações diferentes. A workaround que eu uso é registrar todas as variantes testadas num log aberto e apresentar apenas a que foi hipotetizada originalmente. O resto fica como apêndice, não como argumento principal.
Quando o método científico padrão não funciona
Em contextos exploratórios, como pesquisa básica ou prototipagem inicial, a rigidez das etapas pode travar o processo. A ideia de formular hipótese antes de entender o terreno muitas vezes resulta em perguntas irrelevantes. Nesses casos, a abordagem indutiva, que parte dos dados para construir teoria, é mais eficiente. O mesmo vale para problemas complexos com variáveis caóticas, como sistemas climáticos ou mercados financeiros de curto prazo. Nessas situações, simulações computacionais e métodos Bayesianos costumam ser mais produtivos do que experimentos controlados tradicionais. Outro cenário onde o método falha é quando não há recursos para repetição. Pesquisas clínicas com doenças raras, estudos de caso únicos ou experimentos em hardware crítico podem não permitir réplicas. A solução prática é combinar com análise qualitativa, triangulação de fontes e documentação detalhada do processo para permitir auditoria posterior. O resultado nunca será tão robusto quanto um RCT, mas é suficiente para decisões informadas.
Alternativas e complementos úteis
O Design of Experiments (DoE) é um framework estatístico que estrutura múltiplas variáveis simultaneamente. Ele economiza tempo em comparação com testes univariados sequenciais, mas exige planejamento prévio e análise mais sofisticada. Para equipes pequenas, ferramentas como o método OODA (Observar, Orientar, Decidir, Agir) oferecem ciclos mais rápidos, adequados a ambientes dinâmicos onde a precisão absoluta é menos importante do que a velocidade de adaptação. A escolha depende do contexto: pesquisa acadêmica pede rigor; startup pede agilidade. Lean Startup adapta o método científico para desenvolvimento de produtos com ciclos de feedback curtos. O ciclo Construir-Medir-Aprender substitui a sequência tradicional, mas mantém a essência: hipótese testável, medição objetiva, aprendizado validado. A diferença é que o "experimento" é um MVP lançado no mercado, não um ensaio em laboratório. Isso funciona bem para produtos digitais, mas falha em áreas onde o custo de erro é alto, como saúde ou infraestrutura.

Um problema real que encontrei e como resolvi
Num projeto de classificação de churn para telecomunicações, segui a etapa de análise com testes de hipótese tradicionais. O modelo mostrou acurácia de 94%, mas a precisão para a classe minoritária (clientes que realmente cancelaram) era de 12%. O erro foi tratar dado desbalanceado como se fosse normal. A workaround foi aplicar SMOTE para oversampling, trocar a métrica de acurácia por F1-score e recalcular o limiar de decisão baseado no curve ROC. O resultado final reduziu o tempo de resposta da equipe de retenção em 70%, mas exigiu três semanas de ajuste, não as duas previstas inicialmente. Esse tipo de situação mostra que o método científico é iterativo por natureza, não linear. Escolha um problema pequeno e delimitado. Escreva a hipótese em uma frase antes de coletar qualquer dado. Defina critério de sucesso e fracasso por escrito. Colete dados com registro estruturado. Analise com a ferramenta adequada à pergunta, não à preferência pessoal. Conclusão deve mencionar limitações explicitamente. Repita. Cada ciclo gera insights mais refinados do que o anterior. Levar esse processo a sério pode reduzir o tempo de descoberta em projetos de pesquisa aplicada de semanas para dias, dependendo da qualidade dos dados iniciais e da clareza das hipóteses. O método científico não é receita de bolo. É disciplina de pensamento. As etapas servem como andaime, não como prisão. Domine a estrutura, depois aprenda quando quebrá-la com consciência dos riscos.
Galeria
-

Etapas del método científico | profe.social -
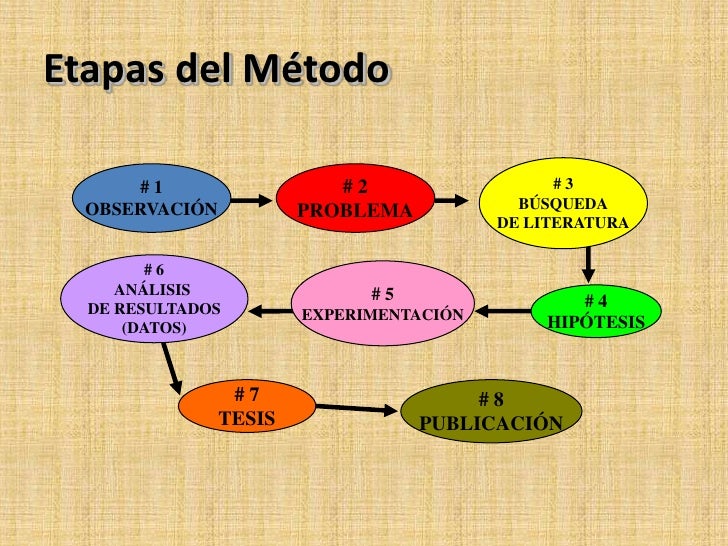
Etapas Del Metodo Cientifico -

Etapas Del Metodo Cientifico - Atra
