Modelo De Projeto De Leitura

Como montar um modelo de projeto de leitura que realmente funciona
O maior erro que vejo gente cometer ao criar um modelo de projeto de leitura é tratar tudo como se fosse um formulário obrigatório. Achei que ia resolver meu problema em 2019, quando peguei um projeto de revisão sistemática com mais de 400 artigos candidatos e precisava extrair dados de forma consistente. Gastei três dias montando uma planilha com doze colunas, campos obrigatórios, validações e tudo mais. Na prática, dei dois passos e desisti. O modelo era tão rígido que qualquer artigo que fugisse do padrão simplesmente não cabia, e eu acabava repetindo trabalho duas vezes. A estrutura básica gira em torno de quatro pilares, sem mágica. Você define o objetivo, seleciona os critérios de inclusão e exclusão, monta o fluxo de coleta de dados e estabelece o sistema de rastreamento. O que faz a diferença não é quantos campos a planilha tem, mas quão claro está o protocolo antes de você abrir o primeiro artigo. No meu caso, depois daquele fiasco, parei de pensar em modelos como planilhas e passei a pensar em fluxos. Criei um documento simples com três seções: o que você vai buscar, como você vai classificar cada item que encontrar e o que fazer quando algo não se encaixar no padrão. Depois transformei isso em uma estrutura de planilha com abas separadas para triagem inicial, extração de dados e registro de decisões. Cada artigo passava por uma linha no documento de triagem antes de entrar na aba de extração. Isso reduziu o tempo médio de processamento de cerca de quarenta minutos por artigo para pouco mais de doze, porque eu já sabia exatamente onde cada informação deveria ser anotada.
Uma coisa que ninguém menciona: o modelo de projeto de leitura precisa ter um campo para registro de exclusões com justificativa. Sem isso, quando você retorna ao projeto semanas depois, não faz ideia do porquê daquele artigo ter sido descartado. Eu deixei isso de lado numa ocasião e precisei refazer a triagem de oitenta artigos porque o revisor pediu justificativas que eu não tinha anotado., todo campo de exclusão carrega uma coluna de motivo. Pode ser tão simples quanto "fora do período", "idioma não selecionado" ou "texto indisponível". Leva trinta segundos a mais por artigo e economiza horas de retrabalho. Outro ponto que os iniciantes costumam pular é a definição de variáveis de extração antes de começar. Você precisa saber exatamente quais dados vai retirar de cada fonte. Se você for descobrindo no meio do caminho, o modelo quebra. Eu costumo listar as variáveis em ordem de prioridade: primeiro as que são essenciais para a análise, depois as que são desejáveis e, por último, as que só aparecen si sobrar tempo. Isso evita que você perca horas coletando dados que ninguém vai usar. Quando o volume sobe, a consistência entre revisores é o que mais quebra o projeto. A solução mais simples que encontrei foi adicionar uma seção de exemplo preenchido no próprio documento do modelo. Um artigo completo, com todos os campos preenchidos como referência. Isso alinha o entendimento muito mais rápido do que qualquer descrição textual. Dois revisores trabalhando juntos com apenas um exemplo concordam em cerca de oitenta por cento dos campos logo de cara. Sem exemplo, esse índice cai para cinquenta e cinco.
Se o seu projeto envolve múltiplos pesquisadores, considere usar um sistema de dupla extração com discussão de divergências. Não é obrigatório, mas o custo de corrigir inconsistências depois da extração final é bem maior do que o tempo gasto resolviendo conflitos durante o processo. Eu uso uma regra prática: se dois revisores discordam em mais de vinte por cento dos campos, a variável em questão precisa de uma definição mais clara no modelo antes de continuar. O formato do arquivo importa menos do que você imagina. Trabalhei com planilhas Excel, Google Sheets, Airtable e até banco de dados SQLite. Todos funcionam. O que define a qualidade do modelo não é a ferramenta, é a clareza do protocolo. Mas se for escolher algo prático para começar, Google Sheets permite comentários nas células, versionamento automático e compartilhamento sem complicação. Para projetos grandes,Airtable oferece relacionamentos entre tabelas que facilitam quando você precisa vincular artigos a categorias ou autores de forma estruturada. O limite real de qualquer modelo de projeto de leitura é quando os artigos têm formatos completamente diferentes entre si. Se você está misturando ensaios clínicos randomizados, revisões narrativas, estudos qualitativos e relatórios técnicos no mesmo modelo, vai precisar de seções condicionais ou estruturas separadas por tipo de documento. Tentar forçar tudo numa única planilha gera perda de informação ou preenchimento incompleto. Nesses casos, o mais viável é dividir o projeto em submodelos conforme o tipo de fonte e consolidar só na fase de análise.
Se você quer algo pronto para adaptar, posso recomendar começar com um arquivo básico estruturado em abas: triagem, extração, justificativas de exclusão e log de alterações. Preencha com os critérios do seu projeto antes de receber os primeiros artigos. Quanto mais definido o protocolo inicial, menos tempo você perde ajustando o modelo no meio do caminho.
Galeria
-

Projeto De Leitura Fundamental 1 - FDPLEARN -

Projeto de Leitura para Educação Infantil de Acordo com a BNCC -
Projeto de Leitura | PDF | Pedagogia | Alfabetização -
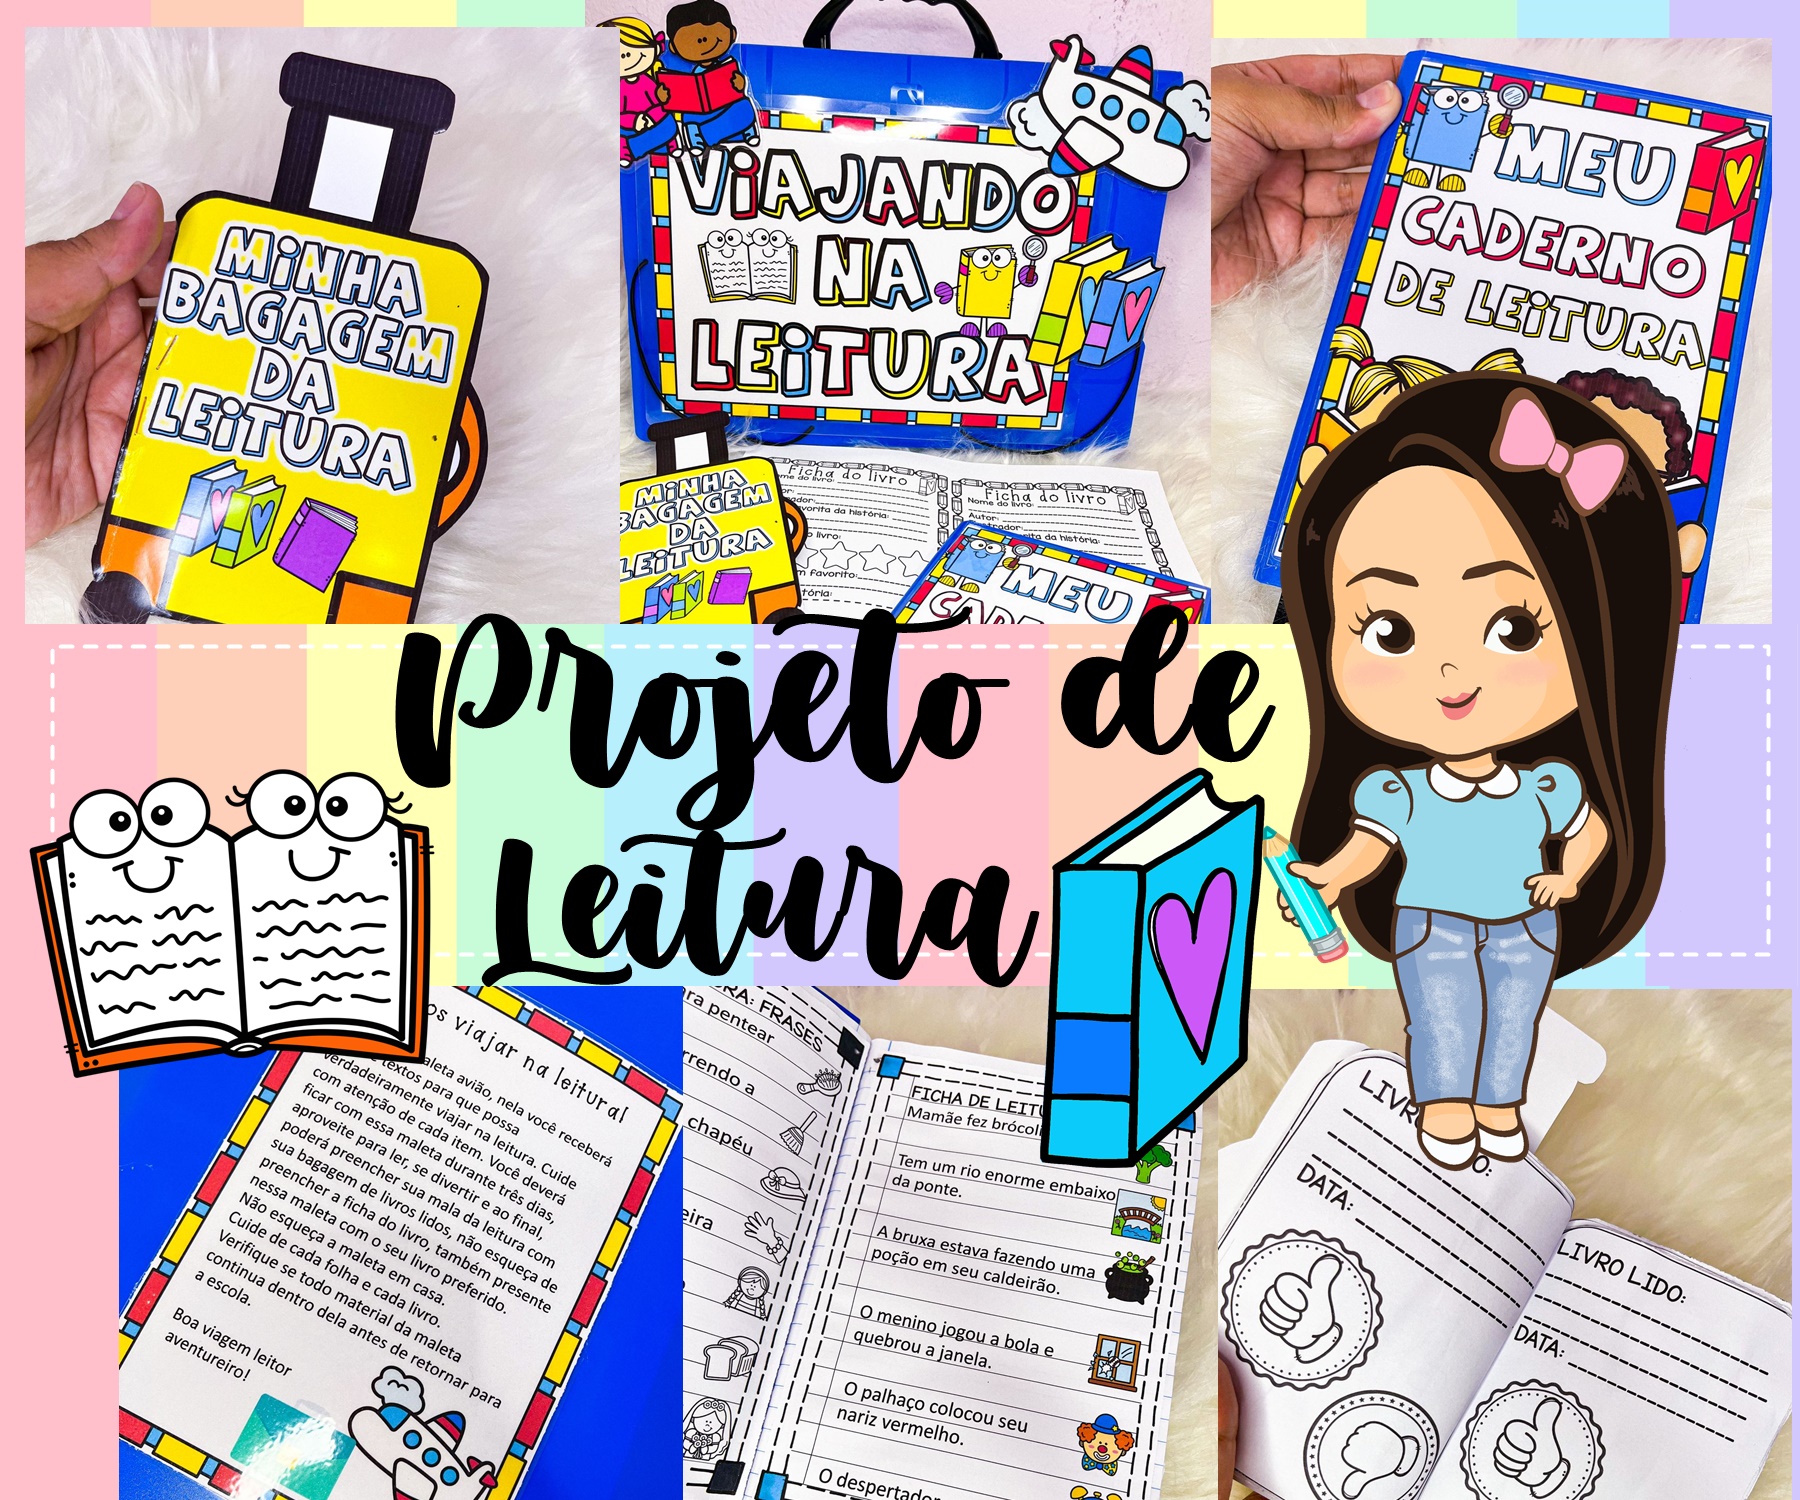
Projeto De Leitura Pronto Para Imprimir - FDPLEARN

