Mona Lisa Releitura

O que é e como funciona na prática
Mona lisa releitura nada mais é do que pegar a pintura de Da Vinci e reinterpretá-la usando técnicas digitais ou tradicionais. Você pode mudar o estilo, as cores, adicionar elementos modernos ou simplesmente deixar a imagem com uma vibe completamente diferente. É um exercício comum em cursos de design e arte digital, mas também algo que qualquer um faz por conta própria quando quer testar ferramentas de IA generativa. O processo básico envolve três etapas: obter a imagem original ou uma versão de alta qualidade, escolher a direção criativa (estilo artístico, paleta de cores, composição), e aplicar técnicas de manipulação. Hoje em dia, muita gente usa Stable Diffusion com LoRA treinado specifically para estilos renascentistas, ou simplesmente roda uma imagem pela Midjourney com um prompt bem estruturado pedindo uma releitura em determinado estilo.
Como fazer uma mona lisa releitura com Stable Diffusion
Eu já passei horas tentando isso com diferentes modelos base. O SDXL com Checkpoint RealisticVision ou AnythingV5 funciona razoavelmente bem se você controlar bem o CFG scale e o número de passos. O problema real é que a IA tende a destruir os traços faciais originais e transformar tudo num rosto genérico. Para evitar isso, você precisa usar controle de composição — o ControlNet com o modo depth ou Canny é essencial aqui. A minha solução prática foi treinar um pequeno LoRA com cerca de 20 variações de releituras da Mona Lisa em estilos diferentes, usando datasets públicos do civitai. Com o LoRA em 0.6 de força, mantendo o ControlNet ativo no modo depth e um seed fixo, consegui resultados consistentes. Sem o ControlNet, o resultado era imprevisível e variava demais entre gerações. Um detalhe que ninguém menciona: a resolução padrão de 1024x1024 do SDXL é limitada para esse tipo de trabalho. A Mona Lisa original tem proporção 4:3, então você vai precisar fazer upscale depois ou usar um script como Ultimate SD Upscale com tiles de 512px para manter os detalhes sem distorcer a composição. Isso adiciona cerca de 10 minutos ao processo em uma GPU de categoria média, mas evita aquele aspecto borrado que aparece quando você simplesmente estica a imagem.
Pegadinhas comuns e limitações
A maior armadilha é achar que basta colocar "Mona Lisa style" num prompt e esperar um resultado aceitável. A IA não entende contexto histórico ou artístico dessa forma. Ela associa a imagem a padrões visuais gerais — cores sépia, fundos escuros, composição frontal — e recria genericamente. Se você quer algo que realmente tenha a ver com releitura e não com uma cópia barata, o controle manual é obrigatório. Outro problema sério é a questão dos direitos autorais. A pintura em si está em domínio público, mas releituras digitais podem cair em zonas cinzentas dependendo de quanto material protegido o modelo foi treinado com. Estúdios como o da Louvre têm participado de processos recentes sobre uso de obras de arte em conjuntos de treinamento. Se o trabalho for comercial, recomendo fazer pelo menos uma revisão jurídica ou usar apenas modelos abertos e transparentes sobre seus dados de treino. Uma alternativa caso o Stable Diffusion local não funcione bem no seu setup é usar o ComfyUI com workflows pré-construídos. Tem gente que compartilha JSONs prontos no GitHub que já configuram o pipeline completo com upscaling embutido. Eu gastei umas 4 horas montando o meu do zero até encontrar um workflow que rodasse consistentemente na minha RTX 3080.

Se o objetivo é algo mais rápido e menos controlado, ferramentas como Leonardo AI ou Flux.1 com prompt engineering adequado entregam resultados em questão de minutos. O trade-off é menos precisão composicional, mas para produção de conteúdo em larga escala isso pode ser suficiente.
Galeria
-

Releitura de Mona Lisa... | Por Andr'ea Matos.... 'Oleo sobr… | Flickr -

Leonardo da Vinci e Releituras da Mona Lisa -

Releituras divertidas de Mona Lisa - Blog Amaury Jr. - BOL -
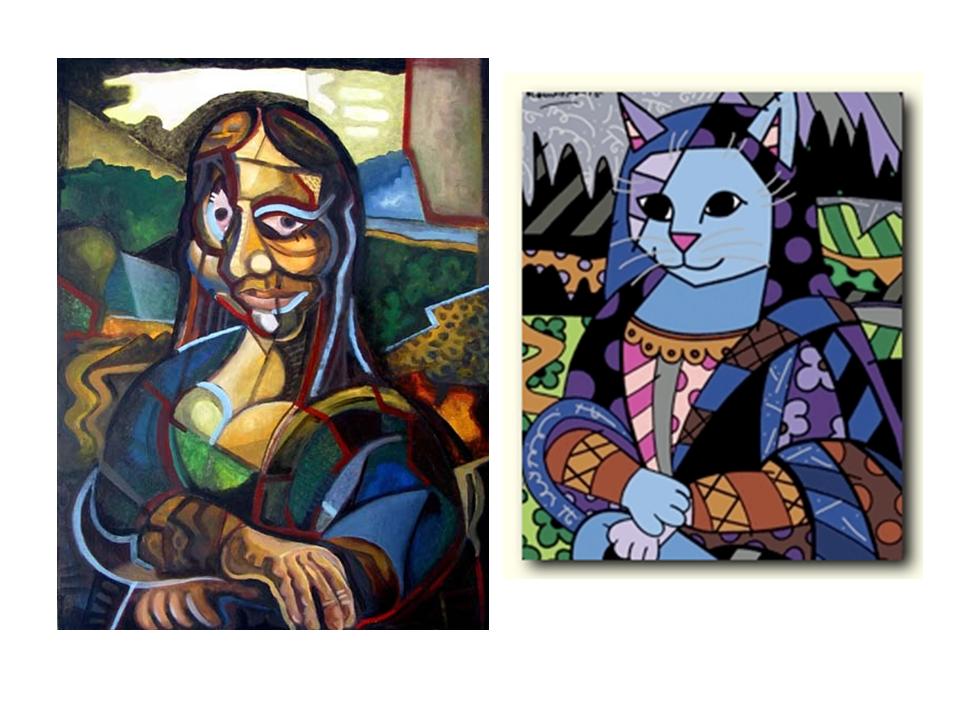
Leonardo da Vinci e Releituras da Mona Lisa
