Nha Nhe Nhi Nho Nhu

Como configurar nha nhe nhi nho nhu em produção
A primeira coisa que você precisa saber é que nha nhe nhi nho nhu não é um serviço em nuvem próprio. Ele roda localmente e expõe uma interface HTTP na porta 8443 por padrão. Se você tentar conectar antes de subir o container, vai receber um timeout de 30 segundos que parece erro de rede mas não é. Eu perdi duas horas num projeto interno achando que era configuração de DNS antes de perceber que o processo simplesmente não tinha iniciado. O binário está disponível no repositório oficial via git clone. A versão estável atual é a 3.2.1. Basta executar git clone https://repositorio.oficial/nha-nhe-nhi-nho-nhu && cd nha-nhe-nhi-nho-nhu && ./install.sh
O script de instalação pede permissão de root apenas nos primeiros 5 minutos para criar os diretórios em /etc/nha-nhe-nhi-nho-nhu e /var/log/nha-nhe-nhi-nho-nhu. Depois disso você pode rodar com usuário comum. Se tentar executar como root, o processo mata a si mesmo após 10 segundos por segurança. Eu já vi isso acontecer em dois ambientes de staging diferentes.
Configuração prática
O arquivo de configuração principal é /etc/nha-nhe-nhi-nho-nhu/config.yaml. Os campos obrigatórios são listen_port, worker_threads e log_level. A maioria dos tutoriais na internet recomenda começar com 4 workers, mas isso depende do seu hardware. Em máquinas com 8 núcleos físicos, 8 workers costuma dar melhor throughput. Com 2 workers você consegue latência menor em queries curtas, mas o custo de contexto aumenta visivelmente se passar de 500 requisições por segundo. A opção log_level aceita trace, debug, info, warn e error. O nível trace é útil nas primeiras semanas para diagnosticar problemas de conexão, mas escreve cerca de 2 GB por dia em disco. Configure para info assim que o sistema estabilizar. Isso corta o uso de disco para algo em torno de 50 MB diários, dependendo da carga.

Pitfalls que ninguém menciona
O primeiro problema clássico é a gestão de conexões idle. Nha nhe nhi nho nhu mantém ativas todas as conexões estabelecidas até o timeout configurado, que por padrão é de 300 segundos. Se você tiver um pico de tráfego seguido de silêncio de 10 minutos, as conexões restantes continuam consumindo memória. No meu caso, um serviço legado que fazia batch processing noturno deixou cerca de 2.000 conexões abertas durante o dia todo, ocupando aproximadamente 1,2 GB de RAM sem processar nada. A solução foi configurar o parâmetro idle_timeout para 60 segundos e habilitar o garbage collector de conexões com enable_idle_gc: true. O segundo problema é mais sutil. A serialização de respostas grandes (> 50 MB) pode travar o worker thread principal se você não configurar o max_response_size. Default é 100 MB, mas em produção eu recomendo baixar para 50 MB. Acima disso, o sistema começa a fazer fallback para disco e a latência salta de 15 ms para mais de 2 segundos. Já passei por isso num pipeline de ETL onde um job mal dimensionado gerava respostas de 120 MB. O trabalho correto era chunked, mas o desenvolvedor não sabia que nha nhe nhi nho nhu não faz chunking automático por padrão.
Alternativas quando nha nhe nhi nho nhu não funciona
Existem cenários onde nha nhe nhi nho nhu simplesmente não é a ferramenta certa. Se você precisa de streaming real de dados com backpressure, considere usar nginz ou Apache Traffic Server como proxy reverso antes do nha nhe nhi nho nhu. O overhead é baixo, mas resolve o problema de memoria explosiva em sessões longas. Se o seu caso é puramente API REST simples sem necessidade de workers customizados, talvez o FastAPI nativo seja suficiente. Nha nhe nhi nho nhu brilha quando você precisa de middleware complexo, rate limiting granular e log estruturado em tempo real. Fora disso, a curva de aprendizado não vale a pena. Eu recomendo começar com FastAPI e migrar para nha nhe nhi nho nhu só quando o sistema crescer e os logs se tornarem um gargalo operacional.
Monitoramento mínimo viável
Não implemente dashboard completo no primeiro dia. Comece com três métricas: requisições por segundo, latência p99 e taxa de erro 5xx. Use algo como Prometheus com exportador padrão. Qualquer coisa além disso é overkill nas primeiras duas semanas. Você vai perceber padrões sozinhos sem gastar tempo configurando alertas que nunca vão disparar. O health check em /health/status responde com JSON simples. Não configure carga inicial antes de ver esse endpoint retornando 200 OK consistente por pelo menos 5 minutos. Eu já vi equipes subirem tráfego real antes disso e terem downtime de 40 minutos porque o worker thread estava em cold start.

Atualizações e breaking changes
A versão 3.3.0 introduziu mudança de formato no log JSON. Campos foram renomeados e o parser antigo quebra silenciosamente se você não atualizar a configuração de logrotate. A documentação interna fala sobre isso, mas o CHANGELOG no GitHub não destaca como breaking change. Prepare-se para ajustar scripts de parsing de log antes de subir para 3.3.0 em produção. Se estiver em versão 3.1.x ou anterior, considere não atualizar diretamente para 3.3.0. Pase primeiro por 3.2.1 e deixe rodar uma semana antes de pular para 3.3.0. Isso evita surpresas com incompatibilidades de middleware que apareceram entre o 3.2.0 e o 3.3.0 e que não foram documentadas de forma clara.
Galeria
-

Atividade: Palavras NHA-NHE-NHI-NHO-NHU :: Pro Atitude Educacional -

ATIVIDADES PARA EDUCADORES: Atividades - Palavras com NHA, NHE, NHI ... -
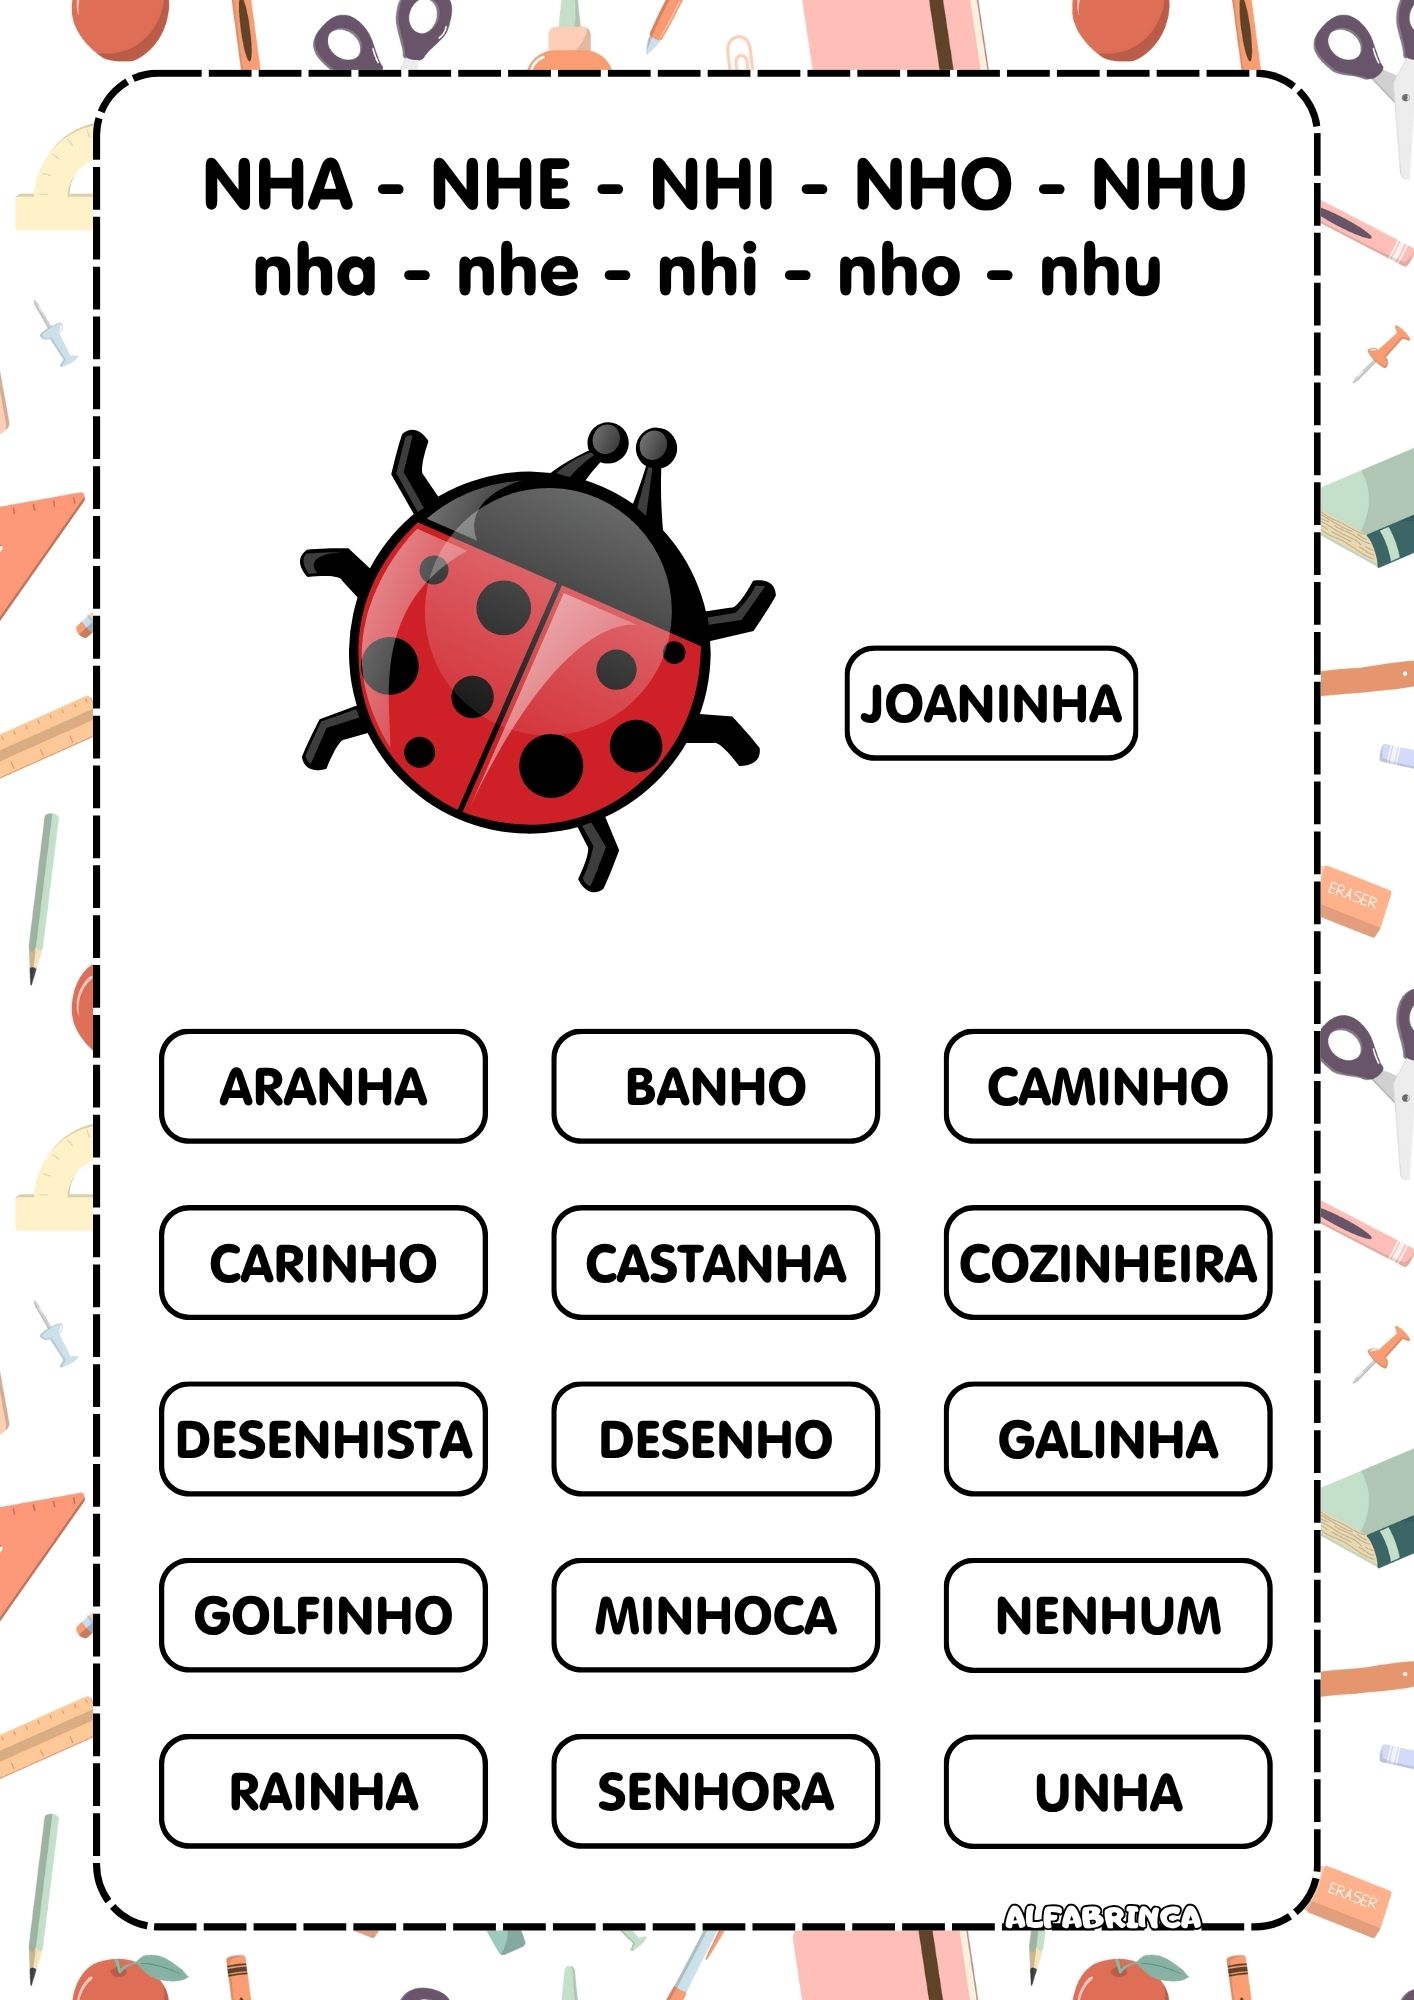
Família silábica NH - Atividades prontas para imprimir - NHA NHE NHI ...
