No Gerenciamento Da Infraestrutura De Um Sistema De Informação

O que acontece quando você decide que precisa gerenciar a infraestrutura do seu sistema de informação
Você já notou que a maioria das empresas trata infraestrutura como algo que "funciona" até parar de funcionar? Eu vi isso acontecer décadas em diferentes setups. A realidade é que gerenciar a infraestrutura de um sistema de informação não é sobre servidores, bancos de dados ou redes isoladamente. É sobre criar visibilidade antes que algo quebre. Quando eu comecei a lidar com isso na prática, pensei que o problema era falta de ferramentas. Na verdade, o problema era quase sempre a falta de documentação viva. Você pode ter o melhor monitoramento do mercado, mas se ninguém sabe o que aquele gráfico de CPU significa para o negócio, você tem um custo alto com insights zero.
A relação entre no gerenciamento da infraestrutura de um sistema de informação e a realidade operacional
O conceito de no gerenciamento da infraestrutura de um sistema de informação vai muito além do que aparece em livros técnicos. Na prática, significa estabelecer um ciclo onde cada componente da sua stack tem dono, métricas definidas e playbooks de resposta. Sem isso, você está apenas esperando o próximo incidente. Um detalhe que poucas pessoas mencionam: o maior custo não é a ferramenta de monitoramento em si. É o tempo que sua equipe gasta investigando falsos positivos porque alguém configurou alertas genéricos. Já passei semanas debuggando um problema que era apenas um pico de tráfego normal em horários de pico de vendas. A solução foi criar baselines específicas por período do dia, não regras binárias. O monitoring precisa ser contextual. Um servidor com 90% de CPU pode estar tranquilo se estiver processando um batch que roda todo domingo às 3h da manhã. O mesmo servidor com 60% de CPU durante um horário comercial pode indicar um vazamento de memória que vai derrubar tudo em duas horas. A diferença está nos dados que você coleta e em como os correlaciona.
O que realmente funciona na prática
A primeira coisa que eu faria é mapear todos os componentes que impactam a experiência do usuário final. Não os componentes que você acha importantes. Os que o usuário final realmente sente quando algo falha. Isso inclui desde o tempo de resposta do banco de dados até o tempo de carregamento dos assets estáticos no CDN. Infraestrutura como código não é opcional. Se você provisiona servidores manualmente, esteja ciente de que ogni alteração não documentada é uma mina terrestre para o futuro. Eu vi equipes inteiras perderem dias inteiros tentando reconstruir ambientes porque alguém fez uma configuração manual em produção que não estava em nenhum repositório. Automação de patch management também economiza horas semanais. Existe uma diferença enorme entre deixar o sistema atualizar quando o servidor estiver livre e ter um pipeline que testa o patch em staging antes de aplicar em produção. O segundo método exige mais esforço inicial, mas reduz drasticamente incidentes causados por atualizações mal testadas.

Vou ser específico sobre backup e recovery. Muitas empresas fazem backup mas nunca testam a recuperação. Isso é como ter um extintor de incêndio que você nunca abriu para ver se funciona. Eu trabalhei em um projeto onde o backup parecía perfeito até precisarmos restaurar. Os dados estavam corrompidos desde o terceiro dia de retenção. Perdemos 72 horas de operação enquanto reconstruíamos manualmente a partir de logs incrementais.
Erros comuns que custa caro corrigir
A tendência de tentar automatizar tudo sem entender o fluxo primeiro é perigosa. Automatizar um processo ruim só cria problemas automáticos mais rápido. Antes de implementar qualquer orquestração, entenda cada passo manual e identifique onde estão os gargalos reais. Outro erro frequente é confiar apenas em métricas de saúde dos componentes. Um serviço pode estar "up" mas retornando dados incorretos. Isso acontece mais do que você imagina. Eu testemunhei APIs funcionando perfeitamente do ponto de vista técnico mas entregando resultados completamente errados porque a lógica de negócio tinha sido alterada sem sincronizar o código em todos os ambientes. Monitoramento de dependências externas também é crítico. Seu sistema pode estar perfeito, mas se uma API de terceiros que você consome começa a responder lentamente ou com erros, sua saúde geral cai. Configure health checks para todas as integrações externas e tenha planos de contingência claros.
Sobre limites e frustrações reais
Nenhuma ferramenta resolve todos os problemas. Monitoramento excessivo gera noise e causa fadiga de alerta. Equipes que recebem dezenas de notificações por dia acabam ignorando as importantes. O equilíbrio é difícil e requer ajuste constante baseado no comportamento real do sistema. Drift de configuração é outro problema persistente. Mesmo com infraestrutura como código, mudanças manuais acontecem. O ideal é ter processos de compliance que detectam e rejeitam alterações não autorizadas, mas isso exige disciplina organizacional que nem sempre existe. Custos também merecem atenção. Ferramentas de monitoramento enterprise podem chegar a valores altos dependendo do volume de dados coletados. Avalie se você realmente precisa de métricas customizadas para cada componente ou se dashboards padrão cobrem 80% das suas necessidades. A resposta geralmente é a segunda opção.

O gerenciamento eficaz depende de cultura tanto quanto de tecnologia. Sem documentação, sem processos claros e sem responsabilidade definida, as melhores ferramentas do mercado vão subutilizadas. Comece pelo básico bem feito antes de investir em soluções complexas.
Galeria
-

Tudo o que você precisa saber sobre um manual de infraestrutura de TI ... -
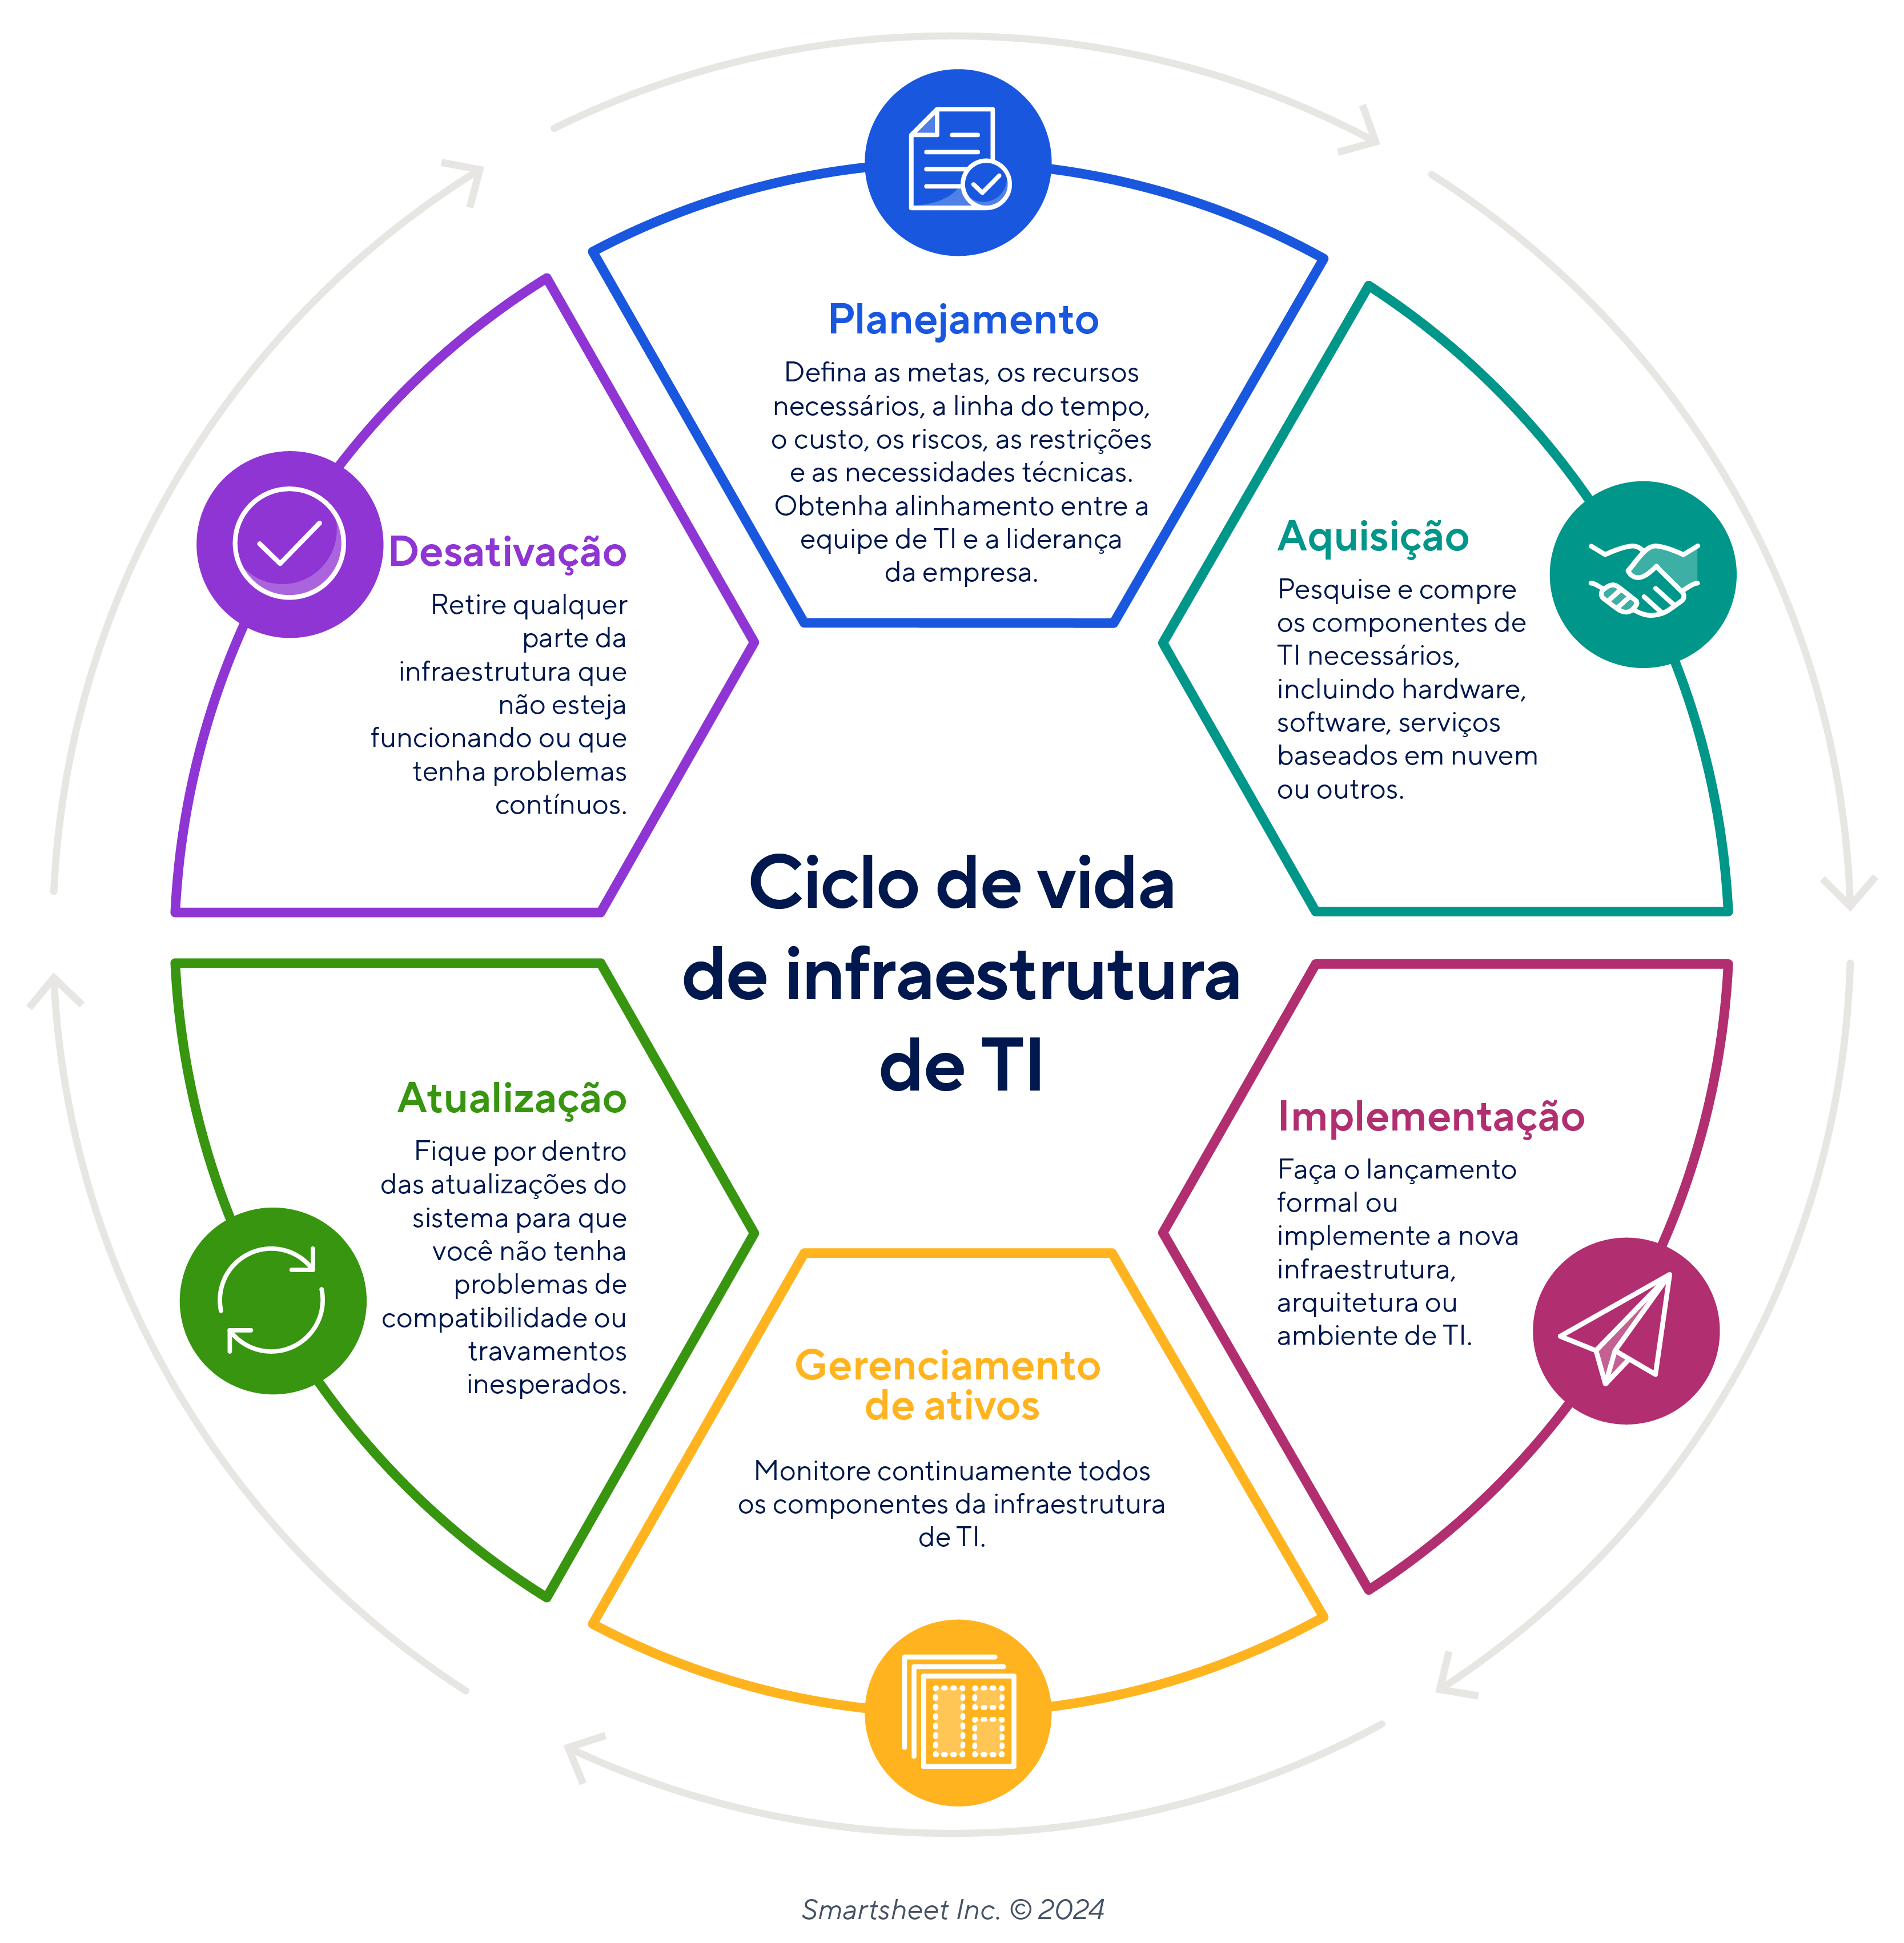
Fundamentos de gerenciamento de projetos de infraestrutura de TI -

Sistema de Informação: O que é, O que Faz, Tipos, Curso
