No Modelo De Responsabilidade Compartilhada Sabemos Que A Responsabilidade
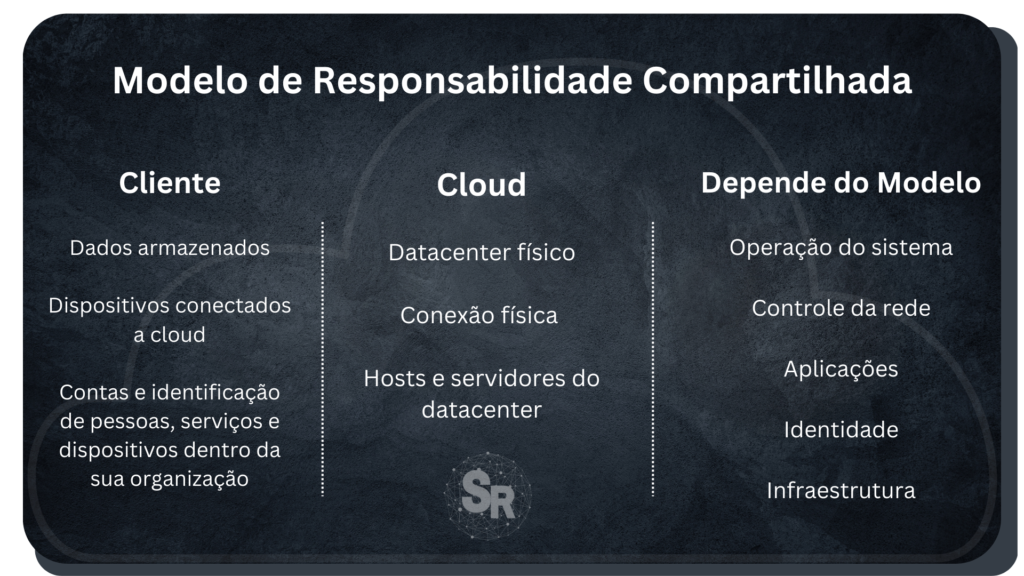
Responsabilidade compartilhada na nuvem: o que realmente muda quando você sobe para o AWS ou Azure
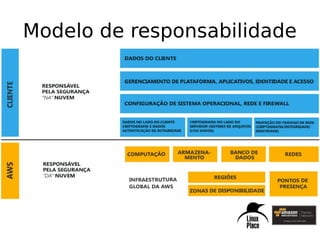
A maioria das empresas subestima o lado do cliente no modelo de responsabilidade compartilhada. Vejo isso todos os dias em auditorias de segurança. O provedor de nuvem garante a segurança dentro da infraestrutura, mas cabe a você garantir a segurança da infraestrutura que roda ali em cima. Essa distinção não é apenas teórica, é onde a maioria dos incidentes acontece. É dividida entre o provedor e o cliente, mas a parte do cliente é muito mais ampla do que o pessoal pensa. O provedor cuida da segurança física dos data centers, da hipervisor, da rede de transport, da disponibilidade dos serviços subjacentes. Você cuida de tudo que roda acima disso: sistema operacional, configurações de segurança, criptografia de dados, gerenciamento de identidades, patches de aplicações, políticas de acesso, logs de auditoria. Um exemplo concreto. Trabalhei com uma equipe que migrava uma aplicação para EC2 e configurou um security group abrindo a porta 22 para 0.0.0.0/0, achando que era "só para administração temporária". Dois dias depois, a instância estava minerando crypto. A AWS não foi responsável pelo vazamento ou pelo uso indevido. A responsabilidade era inteiramente deles. Eles tiveram que refazer toda a política de rede com VPC privada, subnet privada, NAT gateway e SSM Session Manager para acesso sem chave SSH exposta.
O que ninguém te avisa com clareza é que serviços gerenciados mudam completamente a divisão. Quando você usa RDS, por exemplo, a AWS assume responsabilidade adicional sobre o patching do banco de dados. Com Lambda, você não gerencia nada no sistema operacional. Com EKS, a responsabilidade volta quase totalmente para você porque o kubelet e o runtime são seu problema. A linha se move dependendo do serviço. Outro ponto que causa confusão constante é o modelo de responsabilidade compartilhada para identidade. O IAM é inteiramente sua responsabilidade, mesmo sendo um serviço da AWS. Políticas mal escritas, permissões excessivas, senhas fracas, MFA desativado — tudo isso é problema seu. Já vi casos onde uma policy de root com "*" em ações sensíveis ficou ativa por meses porque ninguém revisava as permissões. O provedor não vai alertar você sobre isso automaticamente.
Como mapear exatamente onde termina a sua responsabilidade
O primeiro passo prático é construir uma matriz de responsabilidade por serviço. Não adianta dizer "eu uso AWS" e pronto. Cada serviço tem um nível diferente de compartilhamento. Para EC2 e servidores virtuais, sua fatia é enorme. Para Amazon S3 com bucket policies corretas, a responsabilidade sobre a infraestrutura de storage é do provedor, mas a responsabilidade sobre o que você coloca dentro do bucket e quem acessa continua sendo sua. Aqui vai algo contra-intuitivo que aprendi na prática: muitos times acham que usar um WAF gerenciado resolve a camada de aplicação. Não resolve. O WAF protege contra ataques na camada 7, mas se a aplicação tem uma vulnerabilidade de SQL injection porque o desenvolvedor não parametrizou queries, o WAF pode até detectar o padrão, mas a correção real depende de você. O provedor entrega a ferramenta, não a segurança do código. Para serviços como CloudFront, a responsabilidade do provedor cobre a rede de entrega e a proteção DDoS básica. Mas o cache poisoning, a configuração incorreta de origens, headers de segurança faltando — tudo é responsabilidade sua. Uma config errada de origem no CloudFront já causou exposição direta de buckets S3 em mais de um caso que acompanhei.

O truque que funciona na prática é fazer um inventário de todos os serviços ativos e cruzar com a tabela de responsabilidade compartilhada de cada um. A AWS tem essa tabela pública, a Azure também, a Google Cloud também. O problema é que ninguém lê a tabela inteira. Você precisa ler service por service, porque as regras mudam entre categorias. O que vale para compute não vale para storage, que não vale para networking.
Erros comuns que todo time comete na transição
O erro mais frequente é tratar a nuvem como data center próprio. Você coloca um servidor legado, com as mesmas configurações de segurança que tinha on-premise, e espera que funcione. Não funciona. A superfície de ataque é diferente. A rede é diferente. As políticas de compliance são diferentes. O que era seguro num data center físico pode ser_explicitamente_violador num ambiente de nuvem pública. Outro erro crônico é confiar que o provedor vai notificar qualquer anomalia. Eles notificam problemas na infraestrutura, sim. Mas não vão te avisar que seu security group está aberto para o mundo, ou que uma chave de API está hardcoded num repositório GitHub, ou que um bucket S3 está público por engano. O serviço de Config da AWS pode ajudar, mas ele precisa estar configurado e ativo. Se não estiver, você não tem visibilidade automática. O terceiro erro, e talvez o mais perigoso, é achar que compliance do provedor automaticamente significa compliance seu. O fato de a AWS ser SOC 2 Type II, HIPAA eligible ou PCI DSS compliant não significa que sua conta está em conformidade. A certificação cobre a infraestrutura do provedor, não a forma como você a usa. Um auditor vai perguntar especificamente sobre suas configurações, seus logs, seus processos de acesso, suas políticas de retenção. Tudo isso é responsabilidade sua.
Configurações práticas para reduzir seu risco
Comece pelo essencial e faça funcionar antes de sofisticir. Security groups com prinsip de menor privilégio. Nada de 0.0.0.0/0 em portas sensíveis. Use ranges de IP específicos dos seus escritórios ou de servidores de. Se precisa de acesso remoto, use SSM Session Manager ao invés de SSH com chave pública distribuída manualmente. Ative o CloudTrail em todas as regions. Logs não ativados são o maior ponto cego que existe. Sem CloudTrail, você não tem trilha de auditoria de quem fez o quê e quando. Isso é crítico tanto para investigaçao de incidentes quanto para compliance. A versão paga do CloudTrail com log file validation é recomendada porque previne que logs sejam alterados ou deletados sem rastreo. Configure o GuardDuty ou um equivalent funcional no provedor que estiver usando. Ele analisa logs de forma automatizada e detecta comportamentos anômalos que humanos poderiam perder. Custo baixo, visibilidade alta. O problema é que muitos times ativam e não configuram os alerts adequadamente, então recebem eventos sem contexto e acabam desligando. Configure thresholds realistas e integre com seu sistema de ticketing ou chat operacional.
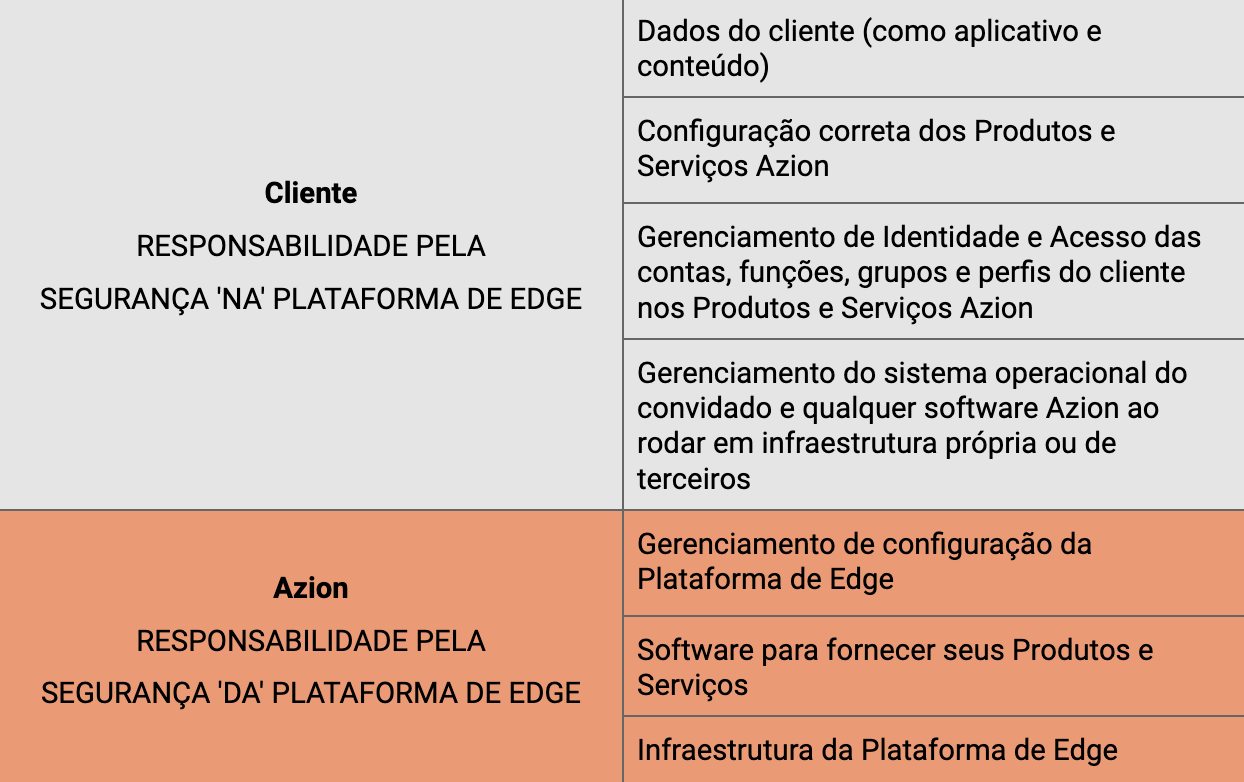
Sobre IAM, aplique o princípio de menor privilégio desde o início. Roles com permissions boundary são mais seguras do que policies soltas. Evite usar o root account para operações do dia a dia. Crie uma conta administrativa separada com MFA obrigatório e acesso restrito por VPN ou endpoint privado. Já vi contas onde a key de root estava exposta em um painel de dashboard interno, acessível por qualquer funcionário com login na rede corporativa. Para storage, desative o block public access em nível de conta e só libere por exceptions reais, nunca por padrão. Criptografia em repouso com KMS é padrão obrigatório. Criptografia em trânsito com TLS 1.2 mínimo. Versionamento ativado em buckets críticos. Bucket policies que verificam condições de acesso ao invés de apenas listar accounts permitidas.
Limitações do modelo que você precisa aceitar
O modelo de responsabilidade compartilhada não é perfeito e tem falhas conhecidas. A principal é a ambiguidade em serviços híbridos. Quando você usa algo como ECS com Fargate, a responsabilidade do provedor aumenta porque você não gerencia o servidor. Mas com ECS em modo EC2, você volta a ser responsável pelo auto-scaling group, pelo OS, pelos patches. A mesma ferramenta, responsabilidades completamente diferentes dependendo do modo. Isso gera confusão frequente durante migrações. Outra limitação é que o provedor não assume responsabilidade pela disponibilidade que você projetou. Se sua arquitetura é single-AZ e uma zona falha, o provedor cumpriu o SLA dele. A perda de negócio é sua. Arquitetura multi-AZ ou multi-region é sua responsabilidade de design, não do provedor. Existem ferramentas de terceiros que tentam preencher essas lacunas, como Checkov, Terrascan, Prowler. Elas escaneiam infraestrutura como código e apontam violações de segurança baseadas nas responsabilidades do cliente. Usem antes de aplicar mudanças em produção. Reduzem erros de configuração em cerca de 60 a 70% quando integradas ao pipeline de CI/CD, dependendo da maturidade do time.
A nuvem nunca vai ser totalmente segura sozinha. Ela oferece controles poderosos, mas a segurança real depende de como você os configura, mantém e monitora. O modelo de responsabilidade compartilhada existe exatamente para deixar isso claro desde o início. Ignorar essa divisão custa caro, e o custo quase sempre aparece na forma de um incidente que poderia ter sido prevenido com configuração adequada desde o primeiro dia.
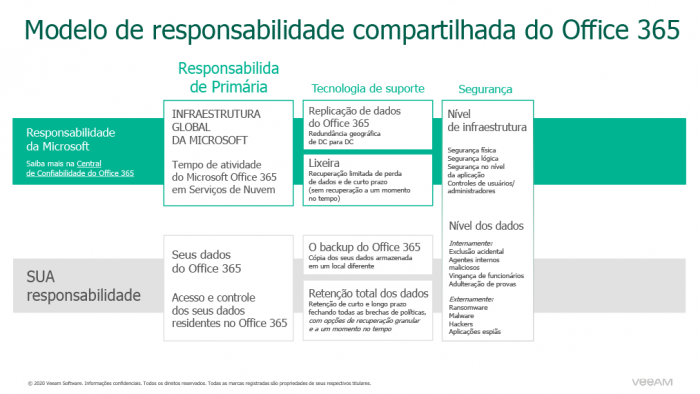
Galeria
-
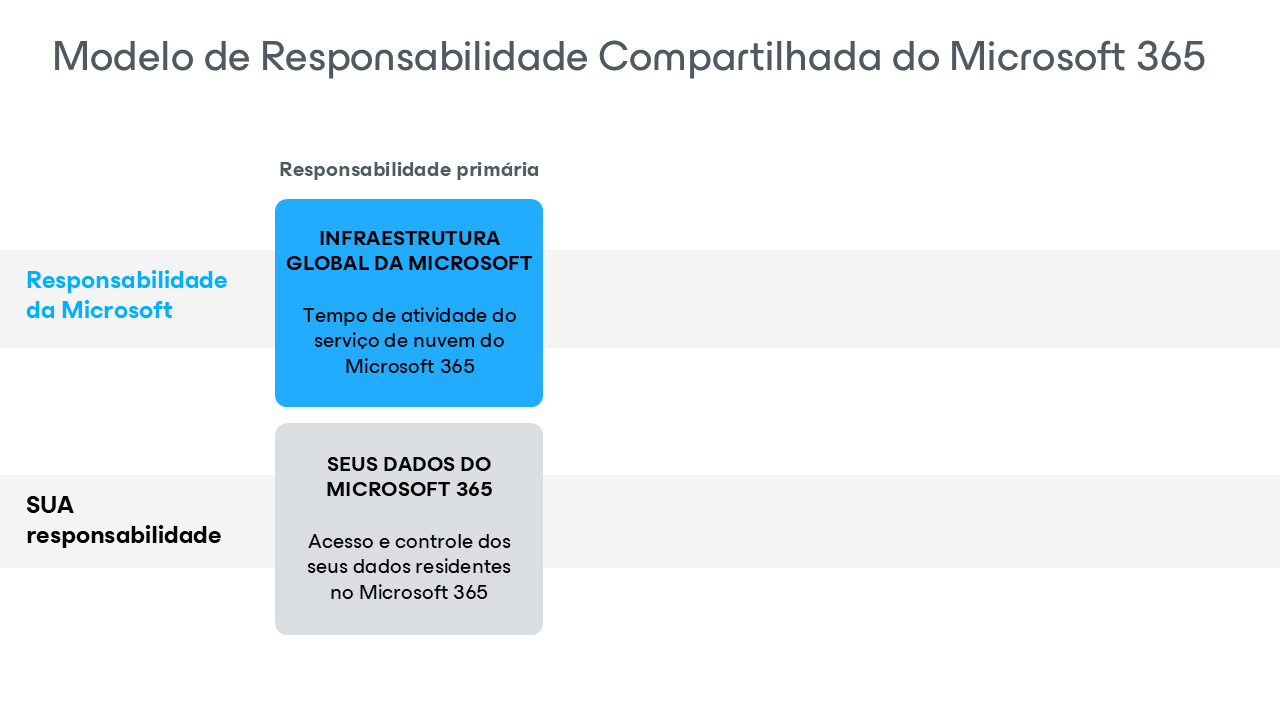
Modelo de responsabilidade compartilhada do Microsoft 365 -
Palestra Daniel Peres - Modelo de Responsabilidade compartilhada AWS e ...
