Noção De Estatistica

O que realmente significa ter noção de estatística
A maioria das pessoas acha que estatística é só calcular média e desvio padrão. A realidade é bem mais chatinha. Ter noção de estatística significa conseguir olhar para um número e já saber instintivamente se ele confia ou não. Isso não se aprende decorando fórmulas. Se aproxima com tempo de ver dados bagunçados. Eu comecei a entender isso na prática quando precisei analisar taxas de conversão de um funil de vendas que parecia estar crescendo 40% mês a mês. A impressão inicial era ótima. Ao separar os dados por canal de aquisição, percebi que o crescimento vinha inteiramente de um único canal sazonal que tinha tido uma promoção pontual. O funil real estava estagnado. Esse tipo de armadilha acontece todo dia em empresas que dependem de dashboards bonitos sem nenhuma leitura crítica por baixo.
Construindo uma noção de estatistica sólida
O caminho mais direto é parar de confiar na primeira métrica que aparece. Quando alguém te mostra um KPI, a primeira pergunta que você deveria fazer é sobre a amostra. Quantas observações sustentam aquele número. Qual é a variabilidade. Qual é o período coberto. Três perguntas que levam dois minutos e revelam a maioria das mentiras nos dados. Depois disso, aprenda a diferença entre média, mediana e moda de verdade. Não na teoria. Na prática você vai perceber que a média é extremamente sensível a outliers. Se você tem um conjunto de salários onde a maioria ganha entre dois e cinco mil reais e existe um diretor ganhando cem mil, a média vai distorcer completamente a percepção do que é normal. A mediana aqui é muito mais honesta. Eu já vi relatórios executivos inteiros usarem média de ticket médio sem nenhum ajuste, o que gerava decisões de precificação baseadas em números irreais.
Métricas que todo mundo usa errado
A correlação é o conceito mais mal interpretado que existe. Duas variáveis subirem juntas não significa que uma causa a outra. Eu passei meses lidando com um caso em que a quantidade de solicitações de suporte técnico e o tempo médio de atendimento tinham uma correlação de quase zero. Parecia bom. O problema era que ambas cresciam juntas simplesmente porque o volume geral de usuários da plataforma estava subindo. O que existia de verdade era um fator de confusão invisível, o crescimento da base, empurrando as duas para cima ao mesmo tempo. Ignorar fatores de confusão é o erro mais comum em análises feitas por quem está começando. O desvio padrão também é amplamente subutilizado. Ele resume a dispersão dos dados em um único número. Se você está analisando tempos de resposta de um servidor e a média é 200 milissegundos mas o desvio padrão é 180 milissegundos, você não tem um sistema consistente. Você tem um sistema imprevisível. A média sozinha esconde completamente esse problema. Relatórios que apresentam apenas a média sem o desvio são basicamente inúteis para tomada de decisão técnica.

Distribuições e o erro de assumir normalidade
Muitos métodos estatísticos tradicionais assumem que os dados seguem uma distribuição normal. A vida real raramente obedece a essa regra. Dados de comportamento de usuário, receitas de e-commerce, tempo de permanência em páginas e taxas de churn seguem frequentemente distribuições assimétricas, com caudas longas para a direita. Aplicar testes que pressupõem normalidade nesses casos gera conclusões equivocadas com frequência surpreendente. A solução prática é usar testes não paramétricos quando você não tem certeza da distribuição. O teste de Mann-Whitney substitui o teste t de Student para comparação de duas amostras independentes. O teste de Kruskal-Wallis faz o mesmo papel da ANOVA para três ou mais grupos. Eles exigem menos suposições e funcionam bem com dados discretos e assimétricos. A perda de poder estatístico em relação aos testes paramétricos é real mas pequena na maioria dos cenários do dia a dia.
Amostragem e tamanho de amostra
Um dos problemas que mais vejo são analistas tirando conclusões de amostrasridículas. Se você está testando uma mudança em uma interface e tem apenas cinquenta usuários expostos ao novo fluxo, qualquer diferença que aparecer pode ser puro ruído. O tamanho mínimo de amostra depende do efeito que você espera detectar, da variabilidade dos dados e do nível de confiança desejado. Ferramentas como o G*Power calculam isso rapidamente. Ignorar o cálculo de tamanho de amostra antes de rodar um teste A/B é um erro que custa caro em tempo e decisão errada. Outro ponto negligenciado é o viés de seleção. Dados coletados de forma não aleatória nunca representam a população-alvo corretamente. Pesquisas online, por exemplo, tendem a super-representar usuários mais engajados e letrados digitalmente. Se a população real inclui pessoas com menos familiaridade tecnológica, as conclusões do estudo vão na direção oposta da realidade. Reconhecer o viés é o primeiro passo para corrigi-lo ou, pelo menos, limitar o escopo das conclusões.
Interpretação de valor-p e intervalos de confiança
O valor-p é um dos conceitos mais mal compreendidos. Ele não mede a probabilidade de uma hipótese ser verdadeira. Ele mede a probabilidade de observar os dados que você coletou, ou algo mais extremo, assumindo que a hipótese nula está correta. Um valor-p de 0,03 não significa que há 97% de chance de seu tratamento funcionar. Significa que, se não houvesse efeito algum, seria improvável obter resultados tão extremos assim por acaso. A distinção é sutil mas decisiva para não tomar decisões erradas. Intervalos de confiança são mais úteis do que valores-p isolados porque eles mostram a faixa plausível para o parâmetro estimado. Um intervalo de confiança de 95% para uma diferença de médias que vai de menos dois pontos a mais dez pontos não é um resultado confiável para decidir se uma mudança deve ser adotada. Ele é inconclusivo. Aprender a ler intervalos de confiança como ferramentas de decisão é muito mais produtivo do que focar apenas na significância estatística binária.

Limitações que ninguém gosta de admitir
A estatística não resolve problemas de dados ruins. Se a coleta é falha, a limpeza é negligente ou os registres são inconsistentes, nenhuma técnica avançada vai recuperar a situação. Métodos sofisticados aplicados a dados ruim simplesmente produzem erros sofisticados. A qualidade dos dados sempre supera a complexidade da análise. Também é importante reconhecer que modelos preditivos têm limites claros. Um modelo bem ajustado em dados históricos não garante bom desempenho futuro, especialmente em contextos dinâmicos onde o comportamento do usuário muda rapidamente. Reavaliar modelos a cada três a seis meses com dados recentes é o mínimo razoável. Confiança excessiva em modelos antigos é uma das causas mais comuns de decisões equivocadas em equipes que trabalham com dados. Por fim, estatística descobre padrões mas não explica mecanismos. Ela indica que algo está acontecendo. Para entender o porquê, você precisa de contexto qualitativo, entrevistas, observação e compreensão do negócio. Números sozinhos nunca dão a resposta completa. Combinar análise quantitativa com interpretação qualitativa é o que separa uma análise rasa de uma análise útil.
Galeria
-
Noções de Estatística para o ENEM | PDF | Média | Modo (Estatística) -
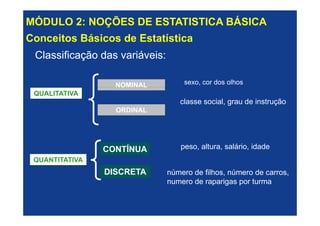
Modulo 2 nocoes de estatistica | PDF -
Noções Elementares de Estatística | PDF | Média | Modo (Estatística)


