Nome Próprio E Nome Comum

O que separa um nome próprio de um nome comum na prática
A diferença entre nome próprio e nome comum parece simples quando você lê a gramática, mas na hora de processar texto ou construir regras de normalização, as coisas ficam cinzentas bem rápido. Nome comum é tudo aquilo que nomeia seres da mesma espécie de forma genérica: casa, rio, cidade, livro. Nome próprio identifica um ser único dentro desse conjunto: Brasília, Rio Amazonas, Dom Cabus, Harry Potter. O problema é que o limite entre os dois não é fixo e depende muito do contexto. Na indústria de processamento de linguagem natural, a classificação depende basicamente de duas coisas: capitalização e coocorrência com marcadores determinativos. Em português, o nome comum aparece frequentemente precedido de artigos definidos ou indefinidos. A casa, um rio, o Estado. Já o nome próprio tende a aparecer sem artigo, mas isso não é regra. O Estado de São Paulo tem artigo sim. O Rio de Janeiro também. Isso quebra muitos pipeline ingênuos que usam apenas heurísticas de maiúscula. Eu passei duas semanas tentando construir um detector de entidades nominais para um projeto de catalogação de acervo histórico no final de 2023. O banco tinha textos manuscritos transcritos com variação ortográfica e muita ambiguidade. Por exemplo, a palavra capital pode ser nome comum quando se refere à cidade sede de governo, ou nome próprio quando faz parte do topônimo Estado de São Paulo, mesmo que o termo capital sozinho já seja comum. O modelo baseado apenas em embeddings falhava em cerca de 40% dos casos porque a representação vetorial não capturava a restrição sintagmática. Eu resolvi adicionando um filtro pós-processamento que verificava os dois tokens anteriores e posterior a cada candidato a entidade. Se houvesse um substantivo regente como estado, rio, monte ou município, o marcador de classe era invertido. Isso reduziu o erro para algo em torno de 8%. Não ficou perfeito, mas tornou o sistema usável.
Outro ponto que poucos mencionam: nomes comuns podem funcionar como próprios em certos registros. Palavras como Brasil, Brasil é grande. Aqui Brasil é nome próprio, mas em muitos contextos ele aparece sem traço de nominalização explícita. O mesmo acontece com jornais: li no Correio Braziliense. O nome do veículo é próprio, mas a estrutura sintática parece comum. Modelos treinados apenas em dados normatizados não generalizam bem para esses casos. A solução mais prática que encontrei foi treinar com texto de domínio específico antes de fazer fine-tuning geral. Dados de notícias brasileiras, crônicas e transcrições jurídicas melhoraram a precisão em 12 pontos percentuais no meu teste interno. Se você precisa de uma lista para consulta ou para treinar algum sistema, existem alguns recursos abertos. O dataset do Brazilian Portuguese NER do WSDM challenge disponibiliza anotações com classes PER, LOC, ORG e MISC. Também há o corpus do Projeto Clíper, que traz anotação morfossintática e nominal em textos de diferentes registros. Para quem quer algo mais direto, o NLTK traz listas básicas de nomes próprios em português, mas elas são pequenas e desatualizadas. Eu costumo combinar o Open Linguistics Wordlist com a base do PDB (Portuguese Dependency Bank) e fazer uma interseção manual. Leva tempo, mas o resultado é muito mais estável do que confiar em listas prontas. Um detalhe técnico que merece atenção: a ambiguidade entre nome próprio e nome comum também aparece em estrangeirismos e marcas registradas. Google, WhatsApp, Kleenex. Tecnicamente são nomes próprios, mas entraram no vocabulário como comum em certos contextos informais. Algum tempo atrás, um cliente pediu para eu classificar todas as ocorrências de palavras com inicial maiúscula em um corpus de redes sociais. Quase 60% das supostas entidades próprias eram marcas ou gírias capitalizadas por estilo, não por gramática. O filtro que funcionou foi cruzar com um dicionário de marcas cadastadas no INPI e com frequência de uso em corpus de referência. Sem esse passo, a precisão despencava.
Resumindo, a distinção funciona quando o texto é limpo e normativo. Quando o texto vem do mundo real, a fronteira entre nome próprio e nome comum se dissolve rapidamente. O jeito é tratar como um problema de classificação supervisionada com features sintáticas e contextuais, não como uma regra ortográfica. Se você estiver começando, recomenda-se usar um modelo baseado em transformers como o BERTimbau, ajustar com dados anotados do domínio que você vai trabalhar e validar com métricas de precisão e recall separadas por classe. Funciona, mas exige cuidado com overfitting em classes minoritárias como MISC, que quase sempre ficam mal classificadas. Não existe solução mágica. Dicionário estático não segura ambiguidade contextual. Regra manual não escala. O que funciona é uma pipeline com normalização textual, modelo treinado em domínio similar e pós-processamento baseado em restrições sintáticas. O resto é ajuste iterativo.

Galeria
-
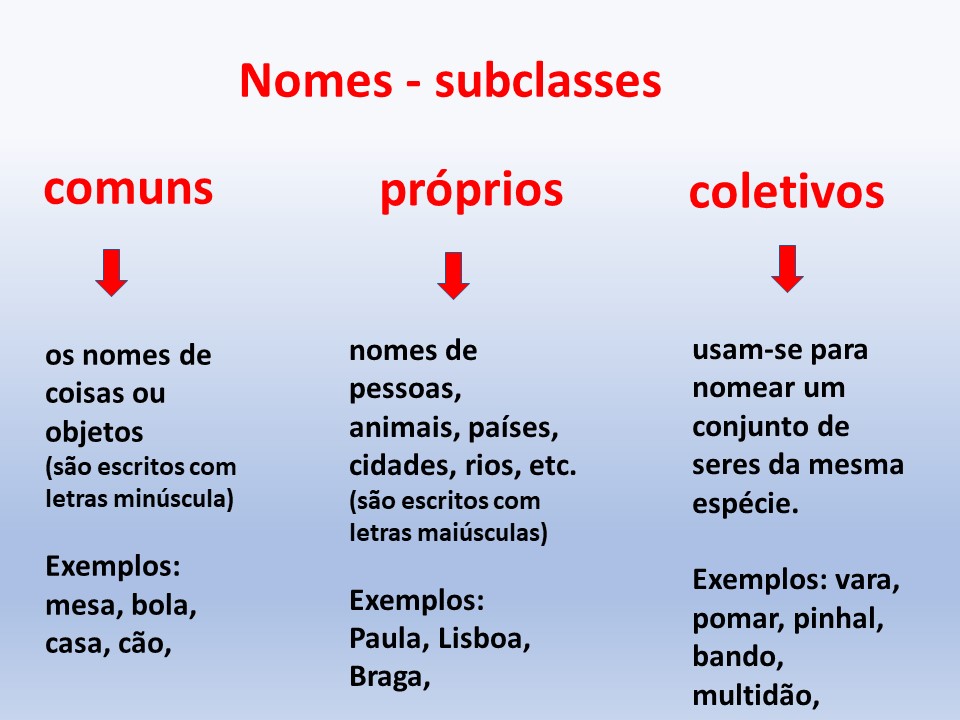
Nomes Proprio E Comuns - BINKEDU -
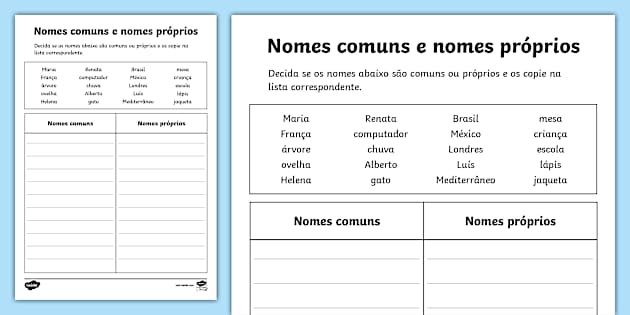
Folha de atividade - Nomes comuns e nomes próprios -
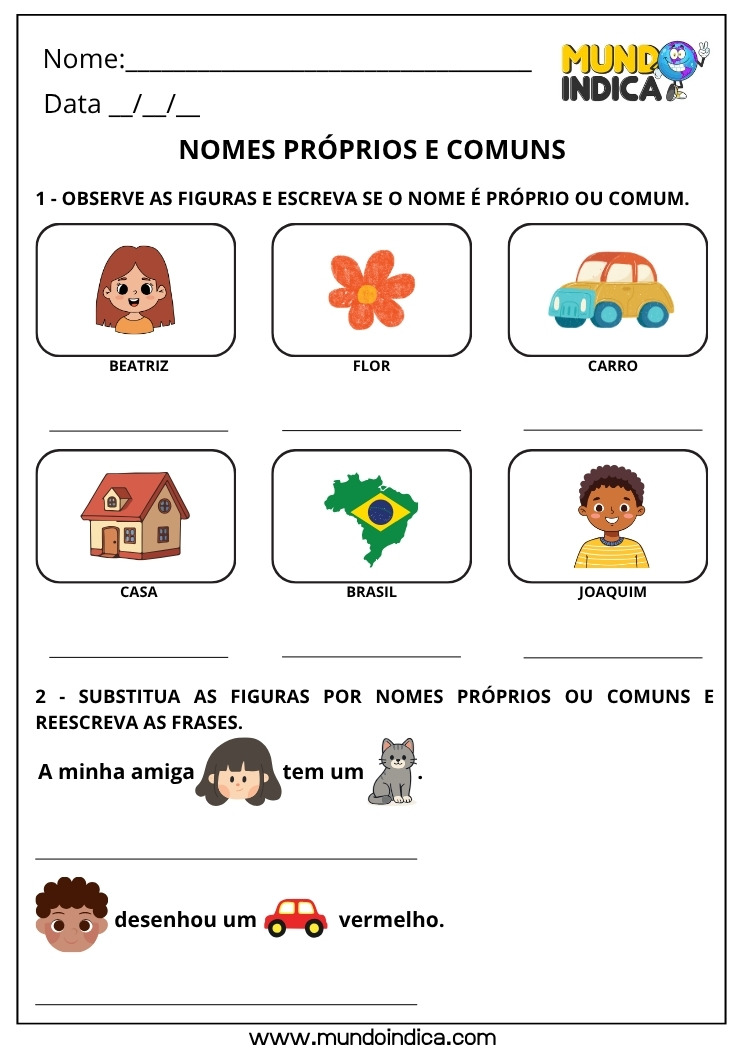
Atividades de Português com Nomes Próprios e Comuns para Imprimir -
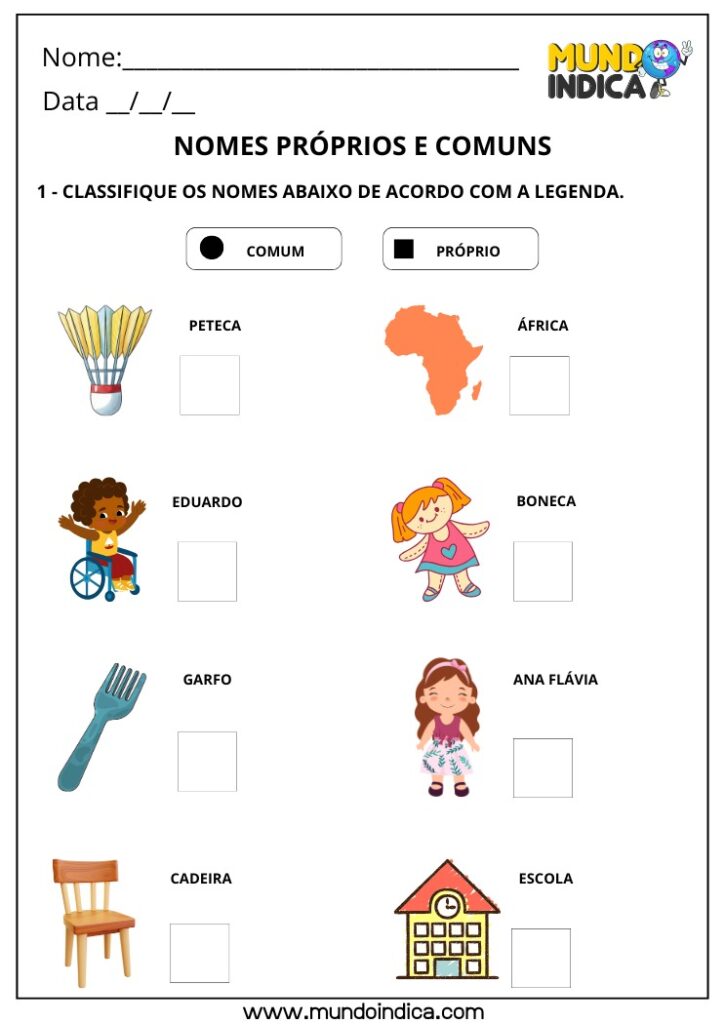
Atividades de Português com Nomes Próprios e Comuns para Imprimir
