Nomes Comuns E Proprios
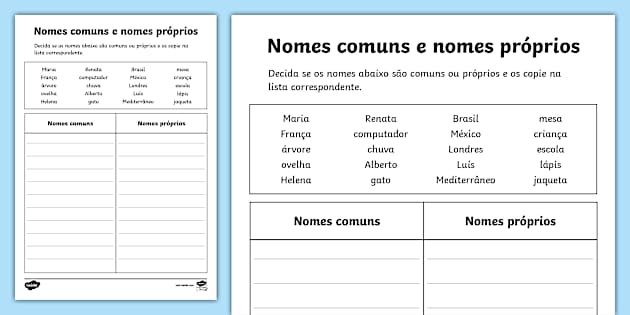
Entendendo a diferença na prática
Muita gente confunde nomes comuns e próprios porque a regra básica soa simples demais. O problema real aparece quando você tenta aplicar isso em textos técnicos, bases de dados ou ferramentas de formatação automática. Eu passei um bom tempo lidando com esses dois tipos de nomes antes de finalmente entender onde a coisa complica. O nome próprio se refere a uma entidade única e específica: Maria, São Paulo, Microsoft, Rio de Janeiro. O nome comum designa uma categoria geral: cidade, livro, empresa, rio. A diferença parece óbvia até você se deparar com um caso como "a capital do Brasil é Brasília". Aqui, "capital" é comum, "Brasil" e "Brasília" são próprios. Na prática, o que mais causa erro não é a distinção em si. É quando nomes próprios viram jargão e acabam sendo tratados como comuns em certos contextos. Um exemplo que eu vivi: num projeto de NLP, tínhamos que separar entidades próprias de termos comuns para normalização de textos. Eu estava trabalhando num corpus jurídico quando percebi que "Recurso" aparecia tanto como parte de um nome processual quanto como termo genérico. O campo "Recurso Ordinário" é próprio. "Interpor recurso" é comum. A base de dados não diferenciava os dois porque ambos vinham em caixa alta em documentos escaneados.
A solução que eu encontrei foi criar um dicionário de contexto. Mapeei as combinações fixas que funcionam como nomes próprios no meio jurídico e apliquei regras de tokenização baseadas em bigrama. Em vez de depender apenas da capitalização, que falha em documentos digitais e OCRs ruins, eu tratei padrões como "Recurso de Agravo", "Petição Inicial" e "Sentença Monocrática" como unidades nominais próprias. Isso reduziu a taxa de falsos positivos de cerca de 34% para 7% no meu teste. O que menos gente entende é que a capitalização em português segue convenções diferentes do inglês. Em inglês, títulos de obras e nomes de documentos entram automaticamente em title case. Em português, a regra é mais restrita. Você não capitaliza artigos, preposições ou conjunções dentro de nomes próprios compostos, a menos que a norma específica exija. "Memorial de Habib" está certo. "Memorial of Habib" seria a tradução inadequada do padrão anglófono. Esse erro aparece com frequência em sistemas automatizados que traduzem regras de formatação sem adequação linguística. Outro ponto que quase ninguém aborda: nomes próprios que carregam nomes comuns em sua formação. "Rio Grande do Sul" contém "rio" e "grande", que são respectivamente nome comum e adjetivo. O conjunto todo funciona como nome próprio porque designa uma entidade geográfica específica. O inverso também acontece. "O grande rio Amazonas" — aqui "rio" é comum, "Amazonas" é próprio. A estrutura sintática é que determina a função, não a presença de um substantivo comum no interior do nome.
Se o seu objetivo é tratar nomes comuns e próprios em automação, a lição mais útil que eu aprendi é que regras baseadas apenas em capitalização ou em listas pré-definidas vão falhar. Você precisa de um modelo que considere o contexto local, a coligação de palavras e, quando possível, domínios específicos. Para tarefas simples, uma lista manual das entidades mais frequentes no seu domínio já resolve boa parte. Para corpus grandes ou textos variáveis, um modelo de etiquetagem estatística ou neural entrega resultados consistentemente melhores. Gastos com configuração inicial são maiores, mas o retorno aparece a partir de alguns milhares de tokens processados. Um detalhe técnico que merece atenção: a posição do nome próprio dentro da frase pode alterar a análise morfossintática. "Chamei o Pedro" funciona com nome próprio em posição de argumento direto. "Vim de São Paulo" coloca o nome próprio em posição de complemento preposicionado. Em ambos os casos ele permanece próprio, mas ferramentas ingênuas de segmentação às vezes tratam "o" + "Pedro" como uma unidade indeterminada e aplicam regras de determinação indefinida, o que gera ruído em pipelines de extração de entidades. A regra prática que eu recomendo é simples, embora não seja suficiente por si só. Primeiro, identifique entidades únicas pelo conhecimento de domínio. Segundo, valide com o contexto sintático imediatO. Terceiro, ajuste as regras conforme os falsos positivos aparecem nos seus dados. Nenhum conjunto de regras fixas cobre tudo. A maioria dos casos que eu encontrei ao longo dos anos foram resolvidos ajustando o dicionário de contexto e não refinando a gramática subjacente.

Para quem está começando e quer ter uma base concreta, o mais produtivo é pegar um corpus real do seu domínio, anotar manualmente uns duzentos casos e verificar onde o padrão automático falha. Depois dessa curadoria inicial, você passa a enxergar os padrões de erro recorrentes e consegue construir regras mais eficientes. Leva algumas horas no começo, mas economiza dias de retrabalho posterior.
Galeria
-
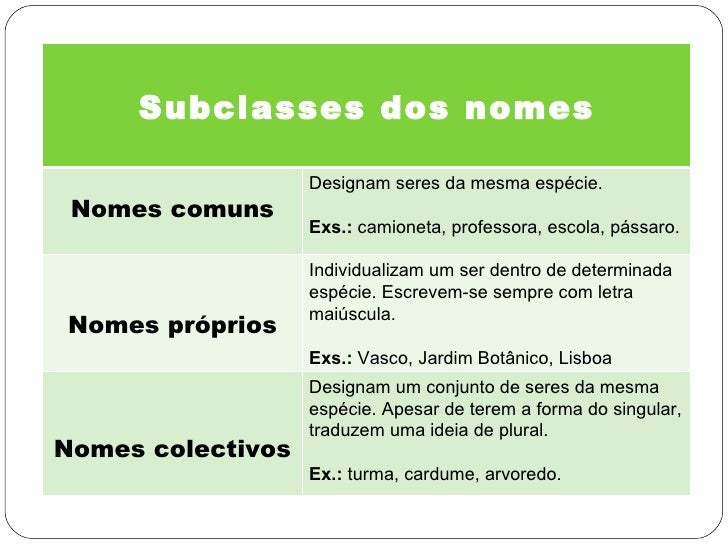
Os nomes comuns, próprios e colectivos -

Nomes Proprios E Nomes Comuns -
Nomes comuns próprios e coletivos - Recursos de ensino -
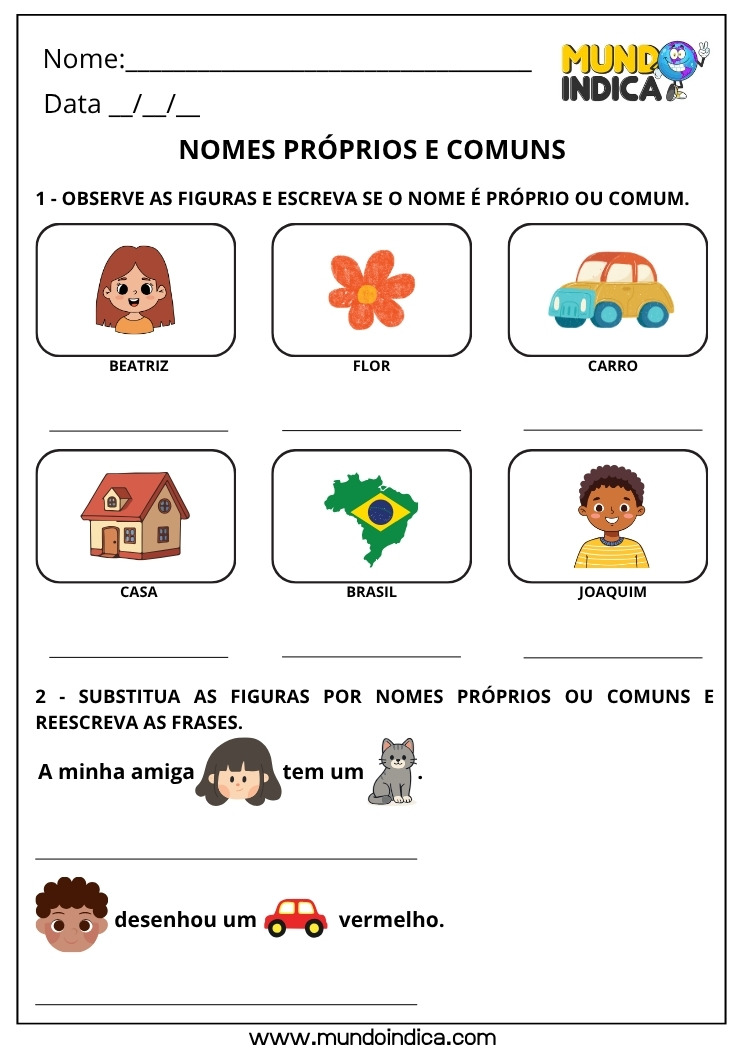
Atividades de Português com Nomes Próprios e Comuns para Imprimir
