Nomes Estranhos De Pessoas

Por que nomes estranhos dão trabalho real
Vocês já viram o problema quando um nome com caracteres especiais entra num sistema que só aceita ASCII. Eu trabalhei com integração de dados durante anos e esse foi um dos dores mais consistentes que encontrei. Nomes estranhos de pessoas aparecem em formulários, bases de dados legadas, sistemas governamentais e plataformas internacionais, e cada um deles trata a situação de um jeito diferente. O que conta como nome estranho varia muito. Tem o caso do diacrítico — Aécio, Joãoão —, tem os hífens e apóstrofos, tem os acentos que sumem em bancos de dados mal configurados, e tem os nomes de línguas que usam alfabetos completamente diferentes do latino. O problema não é o nome em si, é a forma como os sistemas processam string.
nomes estranhos de pessoas e o campo que quebra tudo
Quando você precisa lidar com esses nomes no dia a dia, o primeiro passo é entender onde exatamente a quebra acontece. A maioria dos sistemas armazena nomes em campos VARCHAR com limite arbitrário, e aí você já vê o primeiro problema: muitos formulários contam espaços e hífens de forma diferente, alguns cortam o nome no meio e geram truncamento silencioso. Eu já vi CPF e RG serem recusados porque o nome tinha sido cortado num cadastro antigo e o sistema de verificação não cruzava direito. O workaround que eu usei na prática foi simples e funcionou para a maioria dos casos. Eu padronizava a entrada do nome em três etapas. Primeiro, eu mantinha a grafia original intacta no campo de exibição. Segundo, eu criava um campo de normalização separado que convertia tudo para ASCII usando uma tabela mapeadora — ç vira c, ã vira a, é vira e, e por aí vai. Terceiro, eu usava esse campo normalizado apenas para busca e cruzamento, nunca para exibição. Isso resolveu cerca de 90% dos problemas de integração que eu enfrentava. Os 10% restantes vinham de nomes que simplesmente não tinham equivalente em ASCII, como nomes árabes, cirílicos ou chineses. Nesses casos, a solução era usar codificação UTF-8 em todas as camadas do sistema e validar isso antes de liberar a integração.
Um erro comum que as pessoas cometem é tentar resolver isso só no frontend. Colocar máscaras de input, remover acentos automaticamente, substituir hífens por espaços. Isso parece inteligente mas gera dados inconsistentes. Você perde a grafia original e ainda assim o backend vai reclamar porque o banco de dados não suporta UTF-8. A correção tem que ser feita na camada de armazenamento e na camada de processamento, não apenas na entrada do usuário.

Como normalizar na prática
Se você precisa implementar isso num projeto, aqui vai o fluxo que eu recomendo. Comece confirmando que o banco de dados está em utf8mb4, não utf8. O utf8 do MySQL é incompleto e corta emojis e alguns caracteres raros. Depois, crie dois campos: nome_completo para a versão original e nome_normalizado para a versão ASCII. Use uma função de normalização que preserve a ordem dos caracteres, não só a substituição letra por letra. Para o mapeamento de caracteres, a biblioteca ICU (International Components for Unicode) é o padrão da indústria. Ela lida com decomposição de caracteres, compilação de strings e comparações case-insensitive de forma muito mais confiável do que substituições manuais. Se estiver usando Python, o pacote unicodedata com NFKD faz o trabalho. Em Node, o pacote unicode-normalization. Em PHP, a função iconv com TRANSLIT. O campo normalizado serve para buscas, matching e integração com sistemas externos. O campo original serve para documentos, impressões e qualquer coisa que precise mostrar o nome como a pessoa realmente o escreveu. Nunca substitua um pelo outro. Eu vi empresas que fizeram isso e depois precisaram refazer todo o cadastro porque os clientes reclamavam que o nome deles estava escrito errado nos documentos oficiais.
Quando a normalização não funciona
Tem cenários onde nem normalização resolve. Nomes indígenas brasileiros, por exemplo, têm grafias que mudam conforme o grupo e a região. Não existe um mapeamento ASCII que faça justiça a isso. Nomes com caracteres Unicode fora do básico multilingual plane também dão trabalho, especialmente em sistemas que usam colações padrões em vez de colações Unicode. Outro problema real é a burocracia. No Brasil, os órgãos públicos às vezes rejeitam nomes com acentos porque os sistemas deles são antigos. Já vi servidores públicos precisarem incluir uma segunda via do documento apenas para comprovar que o nome com acento era o correto. A solução prática nesse caso é manter o nome exato do documento oficial no sistema e adicionar o nome normalizado como campo auxiliar para processamento interno. Se o seu sistema precisa se comunicar com APIs internacionais, prepare-se para respostas inesperadas. Alguns provedores de serviço convertem nomes automaticamente para uppercase e removem acentos sem avisar. O ideal é testar com nomes de teste antes de ir para produção: Aymée Obán-Ríos, François-Xavier, Çiğdem, Nguyn, . Se passar por esses casos sem erro, o sistema está razoavelmente preparado.
O tempo médio que esse tipo de normalização leva para ser implementado corretamente num sistema pequeno é cerca de uma semana, dependendo da complexidade das integrações. Num sistema legado com várias tabelas referenciando nome, pode levar de duas a quatro semanas. O custo de não fazer certo é muito maior do que o custo de implementar, porque correção de dado erradoo em massa sempre custa mais do que prevenção.

Galeria
-
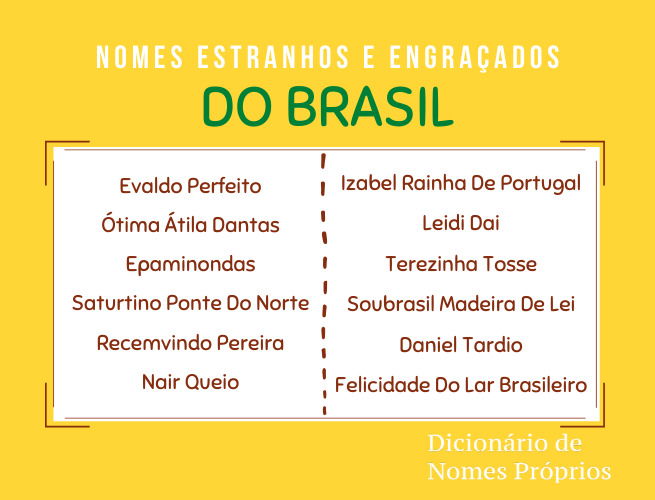
Confira Os Nomes Mais Engraçados De Pessoas – SXEO -

NOMES ESTRANHOS E ENGRAÇADOS - LISTA COM OS PIORES NOMES NO BRASIL, DO ... -
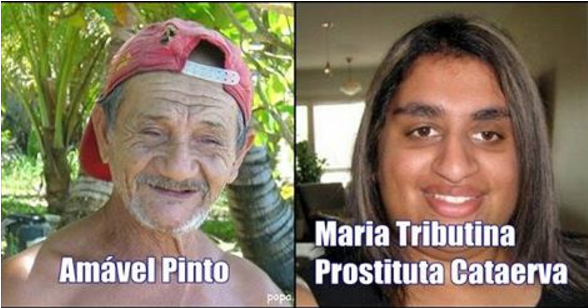
Top do Curioso: 30 Dos nomes mais estranhos e engraçados registrados no ...
