Numeros Que Mais Saem Na Mega Sena
Entendendo o histórico de números na Mega Sena
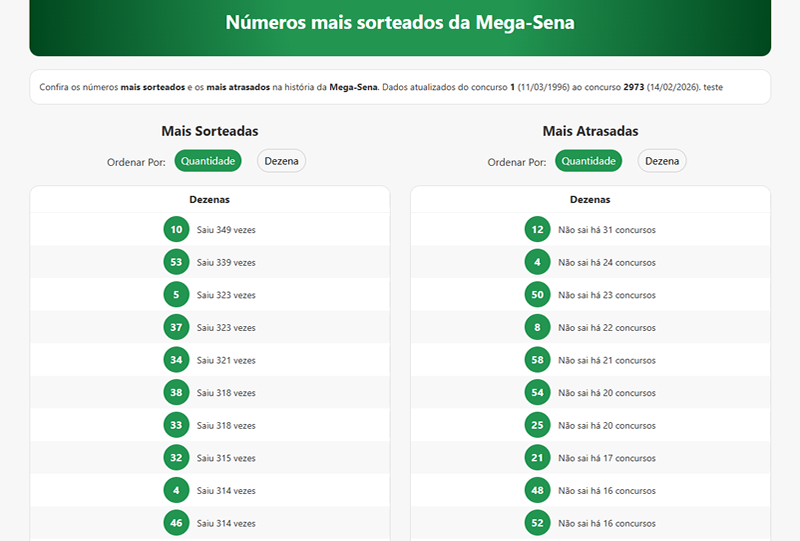
Muita gente acha que estudar a frequência dos números vai garantir um prêmio. A realidade é bem mais simples e, honestamente, mais chata. O que existe são estatísticas de sorteios passados, e isso não predictive nada sobre o próximo resultado. Eu já vi muita pessoa gastando dinheiro com planilhas e software que prometem "números quentes", e nenhum deles funcionou além do acaso. Os sorteios da Mega Sena usam bolas físicas em máquinas aerodinâmicas. Cada concurso é um evento independente. Isso significa que a bola 5 não tem memória da última vez que saiu. O mecanismo não sabe que ela está "atrasada" ou "quente". Quando as casas de apostas e sites de estatística mostravam os numeros que mais saem na mega sena, eles estavam apenas listando dados históricos, não revelando nenhum padrão real.
O que os numeros que mais saem na mega sena realmente significam
Em cerca de 3400 concursos realizados desde 2003, a distribuição teórica seria quase uniforme: cada um dos 60 números deveria sair aproximadamente a mesma quantidade de vezes. Na prática, há variações naturais de amostragem. Os números que mais apareceram até hoje ficam na faixa de 620 a 650 extracoes, enquanto os menos frequentes ficam em torno de 570 a 590. A diferença entre o mais e o menos sorteado é de cerca de 50 a 60 ocorrência ao longo de toda a história do jogo. Isso é estatisticamente insignificante para qualquer previsão. O que a maioria das pessoas não entende é que essa variação é exatamente o que se espera de uma distribuição uniforme com amostragem finita. Se você jogar uma moeda 3400 vezes, não vai obter exatamente 1700 caras e 1700 coroas. Vai haver um desvio. O mesmo princípio se aplica aqui. Eu já trabalhei com análises estatísticas aplicadas a loterias e posso dizer que o problema mais comum que eu via era gente escolhendo todos os números "quentes" e montando jogos com dezenas superlotadas pelo mesmo grupo. Isso cria um jogo com variância distorcida e nenhuma vantagem real. A solução que eu costumava recomendar era simplesmente distribuir as escolhas entre faixas diferentes: alguns números de 1 a 20, outros de 21 a 40, e o restante de 41 a 60. Não melhora suas chances, mas evita que seu jogo inteiro fique concentrado em uma viés aleatório.
Como obter os dados de frequência corretamente
A fonte oficial são os editais da Caixa Econômica Federal. O site da loterias.caixa.gov.br mantém um histórico completo com todos os concursos, datas, e números sorteados. Também existe a API pública do TCE-PI que espelha esses dados, mas a fonte primária é sempre a Caixa. Se você quer processar esses dados por conta própria, o fluxo básico é: baixar o CSV do histórico, calcular a frequência de cada número de 1 a 60, ordenar do mais frequente para o menos frequente, e comparar com a frequência esperada teórica (total de concursos dividido por 60). Qualquer ferramenta de spreadsheet faz isso em menos de dois minutos. Eu costumo usar um script Python simples que leva uns 30 segundos para rodar e gerar um ranking atualizado. O download dos dados brutos está disponível diretamente na página de resultados históricos da Caixa. O arquivo atualiza automaticamente após cada sorteio. Não existe um software oficial da Caixa para análise avançada, então quem quer ir além do básico precisa construir sua própria ferramenta ou usar pacotes de terceiros.

O que ninguém conta sobre frequência numérica em loterias
A armadilha principal é a falácia do apostador. É a crença de que se um número não sai há muito tempo, ele está "devendo" uma sorteia. Isso é completamente errado. O sorteio não tem memória. Cada concurso é independente. Um número que não sai há 100 concursos tem exatamente a mesma probabilidade de sair no próximo que um número que saiu no concurso anterior. A probabilidade não se compensa no curto prazo, e muito menos no médio prazo. A lei dos grandes números só opera em escalas enormes, e mesmo assim apenas convergindo para a média teórica, não forçando equilíbrios. Outro ponto que passa despercebido: a ideia de "números atrasados" é útil apenas para descrições, nunca para predição. Eu já vi planilhas inteiras sendo construídas em torno desse conceito, e todas elas tinham o mesmo defeito estrutural. Elas tratavam correlações espúrias como se fossem sinais reais. A correção é simples: qualquer padrão que você encontrar nos dados históricos pode perfeitamente ser ruído. A única forma de testar isso é aplicar a mesma metodologia a dados simulados gerados aleatoriamente, e ver se os "padrões" aparecem com a mesma frequência. Quando eu fazia esse teste, os chamados padrões desapareciam completamente. Se você quer uma alternativa prática, a única coisa que realmente faz diferença nas loterias é o custo por jogo e a cobertura do bilhete. Jogar mais números em um único volante aumenta exponencialmente o custo, mas também aumenta a probabilidade de acerto de forma proporcional e previsível. Estudar frequência não altera nenhuma dessas variáveis.
Limitações reais que você precisa considerar
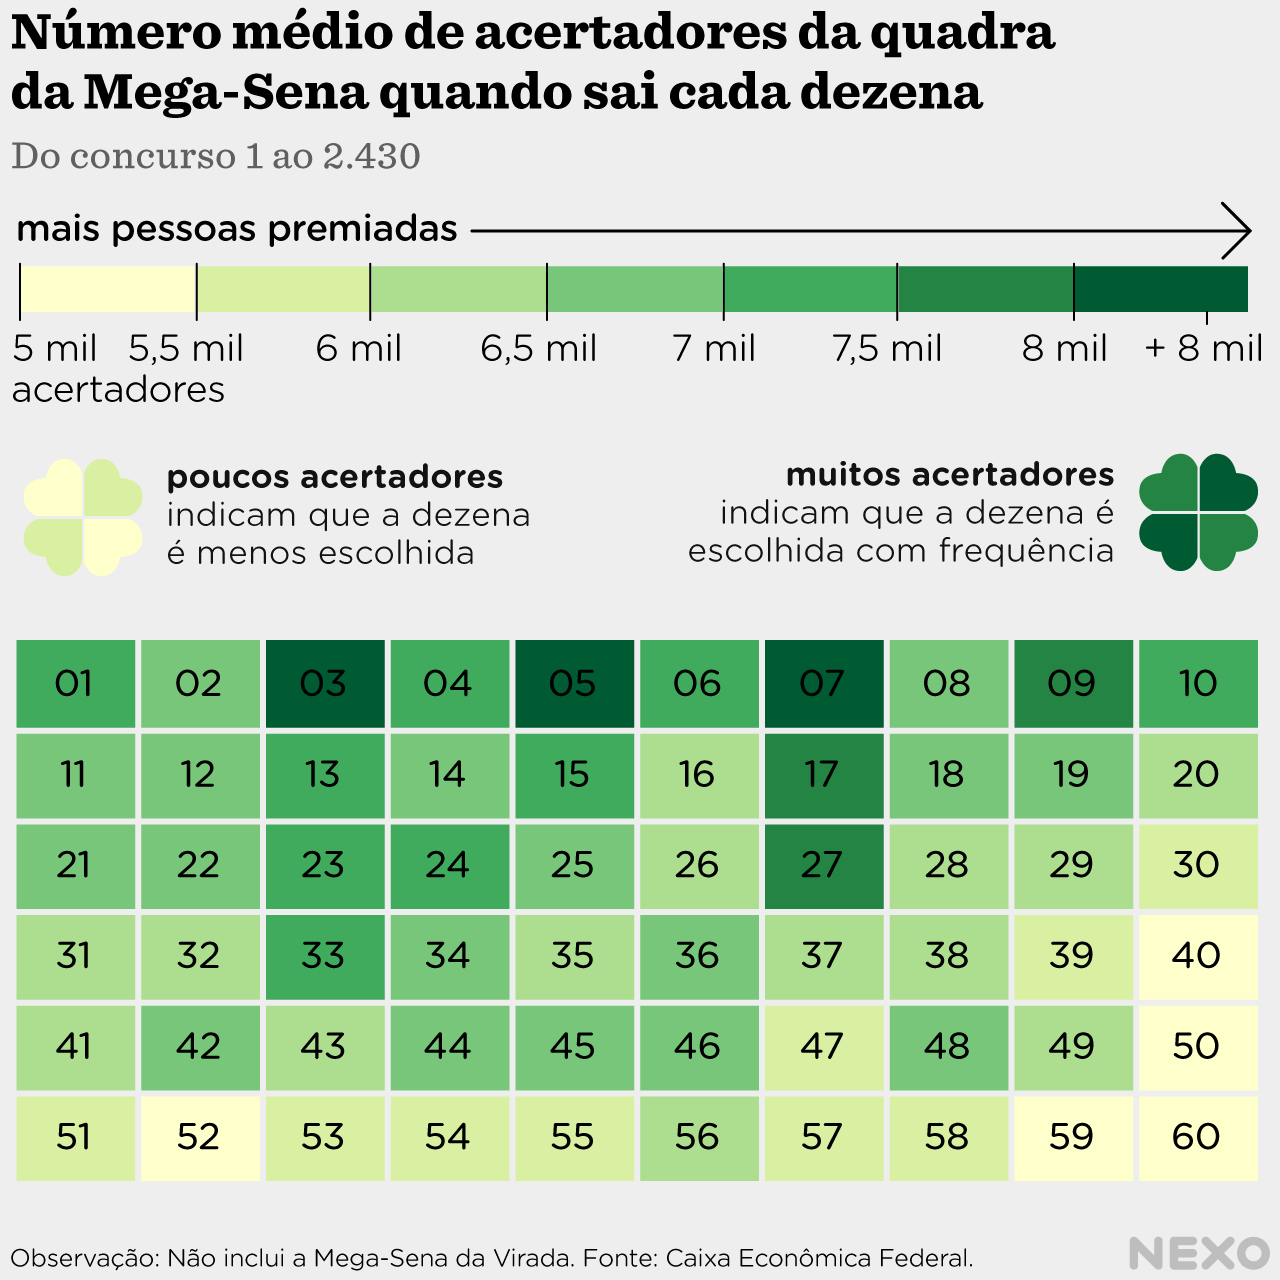
A principal limitação é que os numeros que mais saem na mega sena não têm valor preditivo algum. Use esses dados como curiosidade, não como estratégia. Se alguém vender um sistema baseado nisso, desconfie. O único cenário em que frequência histórica tem alguma aplicação prática é para fins de entretenimento ou para escolher números que não sejam comuns entre outros jogadores, reduzindo a chance de dividir o prêmio se vencer. Nesse caso específico, escolher os números menos sorteados pode ser uma jogada estrategicamente racional, não por aumentar suas chances de ganhar, mas por diminuir a probabilidade de dividir o prêmio com outros que também usam os mesmos números populares. O resultado prático é que você deve tratar esses dados como um histórico documental, não como uma ferramenta de análise preditiva. A distribuição é essencialmente uniforme, as variações são normais, e qualquer tentação de encontrar significado nelas é uma ilusão cognitiva bem documentada em teoria da probabilidade.
Galeria
-
Números mais sorteados na Mega-Sena -
Mega-Sena tem menos acertos quando saem números maiores - Nexo Jornal -

QUAIS OS NUMEROS MAIS SORTEADOS DA MEGA SENA QUAIS OS NÚMEROS QUE MAIS ... -

Mega-Sena: Veja Quais São Os Números Mais Sorteados Da História – QRZXI
