O Bit É A Menor Unidade Utilizada

Bits e bytes no dia a dia
Eu trabalho com binário há mais de dez anos, desde quando ainda dava suporte em equipamentos industriais e precisava interpretar logs de sensores que vinham como sequências hexadecimais. Uma coisa que ninguém explica direito nos manuais é que o bit nunca chega sozinho na prática. Você sempre lida com grupos, e o formato desses grupos muda completamente a forma como lê os dados. O bit é a menor unidade utilizada, isso não tem como negar, mas dizer que você trabalha com bits é como dizer que cozinha com átomos de farinha. Teoricamente correto, praticamente inútil. Quando eu comecei, achava que entender bits significava decorar tabelas de conversão binária. Meu primeiro choque veio em 2015, num sistema de automação onde um registrador de 16 bits precisava ser interpretado como dois inteiros assinados de 8 bits cada. O fabricante usava big-endian para o primeiro e little-endian para o segundo, sem documentar isso em nenhum lugar. Passei três dias tentando decodificar valores que pareciam aleatórios até escrever um script que invertia os bytes dependendo do offset. O problema não era o bit em si, mas a forma como ele era empacotado.
Entendendo o bit como base real
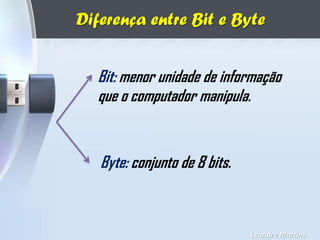
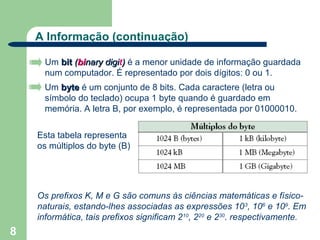
O bit representa um estado entre dois valores possíveis, geralmente chamados de 0 e 1. Na prática, isso se traduz em tensão baixa ou alta num fio, presença ou ausência de luz numa fibra óptica, polarização magnética numa superfície de disco. O que importa é que o bit por si só não carrega significado. Significado vem do contexto que você coloca em volta dele. Um único bit pode ser um flag de erro, o primeiro dígito de um número, ou simplesmente ruído que ninguém prestou atenção. Existe uma confusão comum entre bit e byte que causa erro atrás de erro. Byte são oito bits agrupados, e esse agrupamento é quase universal em sistemas modernos. Mas existem arquiteturas que usam palavras de 12 bits, 36 bits, até 72 bits. A IBM System/360 usava bytes de 8 bits mas endereçava palavras de 32 bits. A escolha do tamanho da palavra afeta diretamente quantos bits você precisa para representar um endereço de memória. Em sistemas embarcados, isso pode significar a diferença entre caber tudo num chip ou precisar de memória externa. O que eu aprendi na marra foi que a maioria dos bugs que vejo em produção não vêm de bits errados, mas de interpretação errada de campos adjacentes. Se você lê um float de 32 bits como um inteiro de 32 bits, o valor vai estar tecnicamente correto, só que sem sentido. O compilador não avisa, o runtime não valida, e o usuário reclama que o sensor está louco. Minha solução foi criar uma camada de mapeamento explícito entre tipos, mesmo que isso custasse uns 5 por cento de overhead. Valeu cada ciclo.
Como ler bits na prática
Pegar bits isolados dentro de um byte exige operações de deslocamento e máscara. Você desloca os bits para a posição menos significativa e aplica uma máscara de 1 para zerar tudo que não quer. Parece simples até encontrar um caso em que o sinal se estende além do byte. Inteiros assinados fazem extensão de sinal automaticamente em muitas linguagens, o que significa que um byte com o bit mais significativo ligado vai virar um valor negativo quando convertido. Isso quebra cálculo de CRC em protocolos que assumem tratamento unsigned. Um problema que eu enfrentei especificamente foi com um sensor de pressão que enviava leituras em 20 bits empacotados em três bytes, com dois bits de status no início de cada frame. A documentação dizia que os bits de status eram independentes, mas na prática o terceiro bit do primeiro byte era usado como flag de calibração pendiente. Eu confiava na documentação e ignorava esse bit, o que resultava em leituras driftadas sem aviso. A correção foi tratar os três bytes como uma estrutura fixa e isolar os bits individualmente com máscaras de 0x01, 0x02, 0x04. Só depois de aplicar isso é que os dados fizeram sentido. A regra que eu sigo hoje é nunca assumir alinhamento de byte sem verificar. Em redes, pacotes podem chegar fragmentados de formas inesperadas. Em arquivos, o finalizador pode variar entre sistemas diferentes. O bit é a menor unidade utilizada, mas a forma como ele se organiza define se seus dados chegam intactos ou como lixo. Eu gasto uns dez minutos extras analisando a estrutura antes de escrever qualquer parser, e esse tempo economiza horas de depuração depois.

Arquiteturas que complicam a vida
Nem todo mundo trabalha com bytes alinhados. Processadores mais antigos usavam palavras desalinhadas para economizar memória, o que significava que um inteiro de 32 bits podia começar numa posição impar de byte. Isso exigia instruções especiais de leitura, e cada acesso desalinhado custava de dois a quatro ciclos a mais dependendo do processador. Em sistemas críticos, essa sobrecarga se acumulava rápido. A ARM introduziu suporte a acesso desalinhado por hardware nas versões mais novas, mas ainda permite configuração para trapear esses acessos em vez de executar automaticamente. Eu tive um caso em que um driver legado funcionava perfeitamente num ARM Cortex-A9, mas travava em todo acesso num Cortex-M4 porque o modo de exception estava habilitado. A correção foi alinhar manualmente os dados antes de passar para a função de leitura. Doura meio por cento de performance a mais, mas elimina crashes aleatórios que ninguém conseguia reproduzir. Um erro muito comum é confundir endianismo com alinhamento de bits. Endianismo define a ordem dos bytes dentro de uma palavra, enquanto alinhamento de bits define a posição exata de cada bit dentro de um byte. Você pode ter um sistema little-endian com bits ordenados de forma não padrão, o que quebra qualquer parser que assuma convenção uniforme. Eu encontro isso principalmente em protocolos proprietários de equipamentos industriais, onde o fabricante decide seu próprio formato sem seguir padrão nenhum.
Quando bits simplesmente falham
Bits não resolvem tudo. Em transmissão de dados, ruído pode inverter um bit sem aviso, e a menos que você use código de detecção ou correção, o erro passa despercebido. Hamming code resolve para erros simples, mas precisa de bits extras que reduzem a capacidade útil. Em canais muito ruidosos, codificações como Reed-Solomon são mais eficientes, mas adicionam complexidade que nem sempre vale a pena. Um limite prático que eu vejo frequentemente é em memórias embarcadas de baixa capacidade. Cada bit extra de paridade consome espaço que poderia ser usado para dados. Em chips com menos de 64 Kbytes, eu opto por verificar dados na aplicação em vez de adicionar paridade no hardware. O custo é um pouco mais de tempo de processamento, mas evita desperdiçar metade da memória com correção de erros que raramente acontece. Se você precisa de confiabilidade real em transmissão, bits sozinhos não bastam. Protocolos como TCP adicionam checksum, sequência, e retransmissão, o que aumenta a sobrecarga para cerca de 25 por cento do throughput bruto. Em enlaces com taxa de erro inferior a 0,01 por cento, essa sobrecarga é aceitável. Acima disso, você precisa de camadas adicionais de correção ou simplesmente mudar de meio de transmissão.
Alternativas que valem a pena considerar
Quando bits começam a se tornar insuficientes, a primeira alternativa é usar representações compactas como bcd, que economizam espaço para números decimais mas complicam operações aritméticas. Bcd é útil em displays e interfaces humanas, mas péssimo para cálculo interno. Eu recomendo bcd apenas para armazenamento final, nunca para processamento intermediário. Outra opção é abandonar bits tradicionais e usar codificações como base64 ou xoroshiro para gerar sequências que parecem aleatórias mas são deterministicas. Isso é comum em testes de stress e geração de dados sintéticos. A desvantagem é que você perde a capacidade de manipular bits individualmente, o que pode ser um problema se precisar de controle fino sobre campos específicos. Se o seu objetivo é apenas armazenar dados de forma eficiente, considere codecs como gzip ou lz4 antes de preocupar-se com manipulação de bits. Compressão pode reduzir o volume em 60 a 80 por cento para dados textuais, o que torna irrelevante a discussão sobre alinhamento de bits. Eu uso lz4 em quase todos os projetos novos, e só volto a pensar em bits quando a compressão não resolve o problema.
O que eu faria diferente
Se eu fosse começar agora, passaria mais tempo entendendo como os bits chegam até mim do que tentando manipulá-los. A fonte determina o formato, e o formato determina tudo que vem depois. Documentos técnicos raramente explicam isso claramente, então eu gero meus próprios testes de validação antes de confiar em qualquer parser. Um erro que eu repetia frequentemente era assumir que meu código funcionava porque testava com dados perfeitos. Dados reais têm ruído, fragmentação, e bordas que só aparecem em produção. Eu agora corro testes de fuzzing em todos os parsers que escrevo, injetando bits errados, frames truncados, e valores fora da faixa. Isso revela problemas que nenhum teste manual encontra. A lição principal é que o bit é a menor unidade utilizada, sim, mas unidade de quê? De armazenamento, de transmissão, de cálculo. Cada contexto exige estratégia diferente, e nenhuma estratégia funciona em todos os casos. Entender isso economiza mais tempo do que decorar operações de bitmask.
Galeria
-
Unidade 5.1 - Unidade de medida de memória | PDF -
TIC Unidade 1.1. informacao e informatica a | PPT -

PPT - INFORMÁTICA BÁSICA - TCI1PA UNIDADES DE MEDIDAS PowerPoint ...
