O Conceito De Amostra É Utilizado No Sentido

Amostragem na prática: o que realmente significa tirar uma amostra
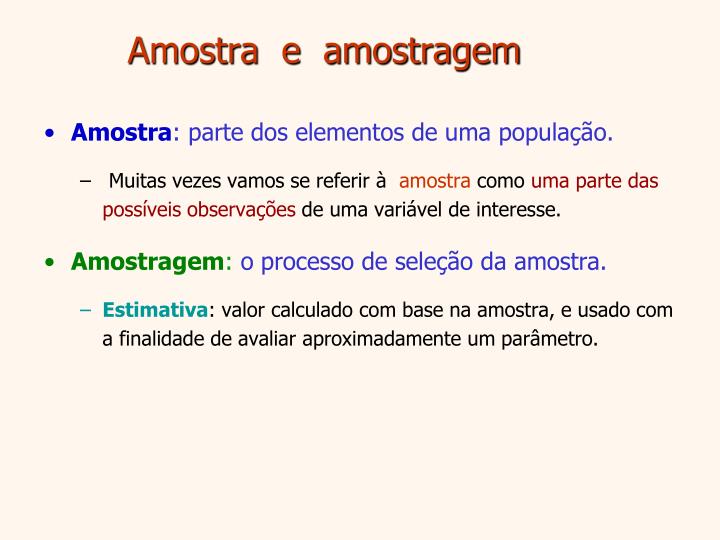
Ao discutir o conceito de amostra é utilizado no sentido estatístico, muitos materiais didáticosparam na definição de livro: um subconjunto representativo da população. O problema é que na prática isso raramente é tão simples assim. Já me deparei com cenários onde a representatividade teórica existia no papel, mas a coleta gerava viés severo porque a frame de amostragem estava desatualizada. O conceito de amostra é utilizado no sentido de inferência sobre uma população a partir de dados coletados em parte dela. Isso implica escolher unidades de forma que cada membro da população tenha uma probabilidade conhecida de ser selecionado, seja igual, seja diferente, desde que documentada.
O conceito de amostra é utilizado no sentido de estimativa controlada de erro
Aqui está a coisa que poucos explicam direito: amostra não serve para "retratar" a população perfeitamente. Serve para produzir estimativas com erro quantificável. O erro amostral não é um defeito, é uma propriedade mensurável. Quanto maior a amostra, menor o erro, mas a relação não é linear. Para reduzir o erro pela metade, você geralmente precisa quadruplicar o tamanho da amostra. Isso importa quando seu orçamento é limitado e você precisa decidir entre 500 ou 1.000 respondentes. No meu trabalho, encontrei um caso específico onde a amostra probabilística clássica falhou completamente. Estávamos estudando adoção de tecnologia em pequenas empresas de um município interiorano. A frame oficial do governo tinha empresas inativas há anos. Minha solução foi fazer amostragem por conglomerados em lotes industriais, com pesagem posterior para corrigir a probabilidade de seleção. O peso final ajustava o viés de cobertura, que estava em torno de 18% na estimativa bruta.
Tipos de amostragem que você realmente encontra no campo
A amostragem aleatória simples é o modelo teórico padrão, mas na prática quase ninguém a usa isoladamente. Ela exige uma lista completa da população, e listas completas são raras ou caras de construir. O que se vê com frequência é amostragem sistemática, que é mais fácil de implementar: você define um intervalo de seleção k dividindo o tamanho da frame pelo tamanho da amostra desejado e sorteia um ponto de partida aleatório. A amostragem estratificada funciona bem quando você conhece variáveis de estratificação relevantes, como região, porte da empresa ou faixa de renda. O ganho real está na precisão: ao garantir representação em cada estrato, você reduz a variância da estimativa. O custo é a complexidade administrativa, que aumenta proporcionalmente ao número de estratos. Já a amostragem por conglomerados é comum em pesquisas eleitorais e estudos de saúde pública. Você sorteia unidades primárias, como bairros ou escolas, e depois coleta dentro delas. A desvantagem é o aumento do erro padrão comparado à amostragem aleatória simples de mesmo tamanho, porque indivíduos do mesmo conglomerado tendem a ser mais parecidos entre si do que com o restante da população. O fator de efeito de desenho (design effect) quantifica isso, e em conglomerados bem definidos ele pode variar de 1,5 a 2,5.
O erro que todo mundo comete na hora de calcular tamanho amostral
Muitas pessoas confundem margem de erro com precisão absoluta. A margem de erro de 3% para uma proporção de 50% com 95% de confiança não significa que a resposta certa está necessariamente dentro desse intervalo. Ela significa que, se você repetisse a pesquisa infinitas vezes com a mesma metodologia, 95% dos intervalos construídos conteriam o verdadeiro valor populacional. Esse é um detalhe sutil que faz diferença quando você precisa justificar resultados para equipes jurídicas ou comitês de auditoria. Outro erro comum é ignorar a taxa de não resposta no cálculo do tamanho amostral. Se sua taxa de resposta esperada é 40%, você precisa aumentar a amostra inicial em 2,5 vezes para obter o efetivo desejado. Fazer essa correção antes do campo economiza semanas de retrabalho e dinheiro de deslocamento. No meu caso mais recente, precisei refazer todo um levantamento porque a amostra foi calculada sem considerar a variabilidade interna de subgrupos minoritários. O grupo de empresas com até cinco funcionários tinha variância quatro vezes maior que o restante, e a amostra original não conseguia estimar sua proporção com margem aceitável. A correção foi superdimensionar a amostra nesse estrato usando alocação ótima de Neyman, que distribui o esforço de coleta proporcionalmente à variância de cada grupo. O custo total subiu cerca de 22%, mas a precisão nos subgrupos críticos voltou ao esperado.
Limitações que ninguém gosta de ouvir
Amostragem probabilística exige frame de qualidade. Se a frame estiver incompleta ou desatualizada, nenhum cálculo de tamanho amostral corrige o viés de cobertura. Nesse cenário, métodos não probabilísticos, como amostragem por cotas ou snowball, podem ser úteis como complemento, mas suas estimativas não admitem cálculo formal de erro amostral. Você perde a capacidade de generalizar com rigor estatístico. Amostragem por conveniência, aquela que todo mundo faz por praticidade, gera dados que só descrevem a própria amostra. Não há inferência válida sobre a população. Se você precisa tomar decisões baseadas em evidências, isso é um limite duro, não uma questão de opinião. Quando o custo de contato por unidade é alto e a população é geograficamente dispersa, a amostragem clusters bem desenhada tende a superar a amostragem simples em eficiência operacional. Porém, se o número de conglomerados for baixo, a variância entre conglomerados domina a variância total, e o ganho de custo pode não compensar a perda de precisão. Nesses casos, amostragem multinível com estimação por efeitos mistos é mais adequado do que métodos clássicos de expansão.
Como decidir na prática entre as opções disponíveis
O processo típico começa definindo o parâmetro de interesse, depois estimando a variabilidade esperada com base em estudos anteriores ou pilotagem. A pilotagem vale o investimento porque revela desvios que cálculos teóricos não captam. Em uma pesquisa recente sobre hábitos de consumo, nossa pilotagem mostrou que a variabilidade real era 30% maior que a estimada na literatura. Adjustamos o tamanho amostral e evitamos um intervalo de confiança impraticavelmente largo no estudo principal. Depois de definir o tamanho, você escolhe o desenho de amostragem considerando a disponibilidade da frame, o custo por unidade, a heterogeneidade interna e a necessidade de desagregação por subgrupos. Se houver menos de vinte conglomerados e a variância entre eles for alta, considere aumentá-los ou mudar para estratificação em níveis superiores da hierarquia populacional. A documentação do protocolo é tão importante quanto a execução. Registrar definições de população, critérios de inclusão e exclusão, taxas de resposta por setor e pesos finais permite replicação e auditoria. Sem isso, resultados não sustentam revisões posteriores e perdem credibilidade institucional.
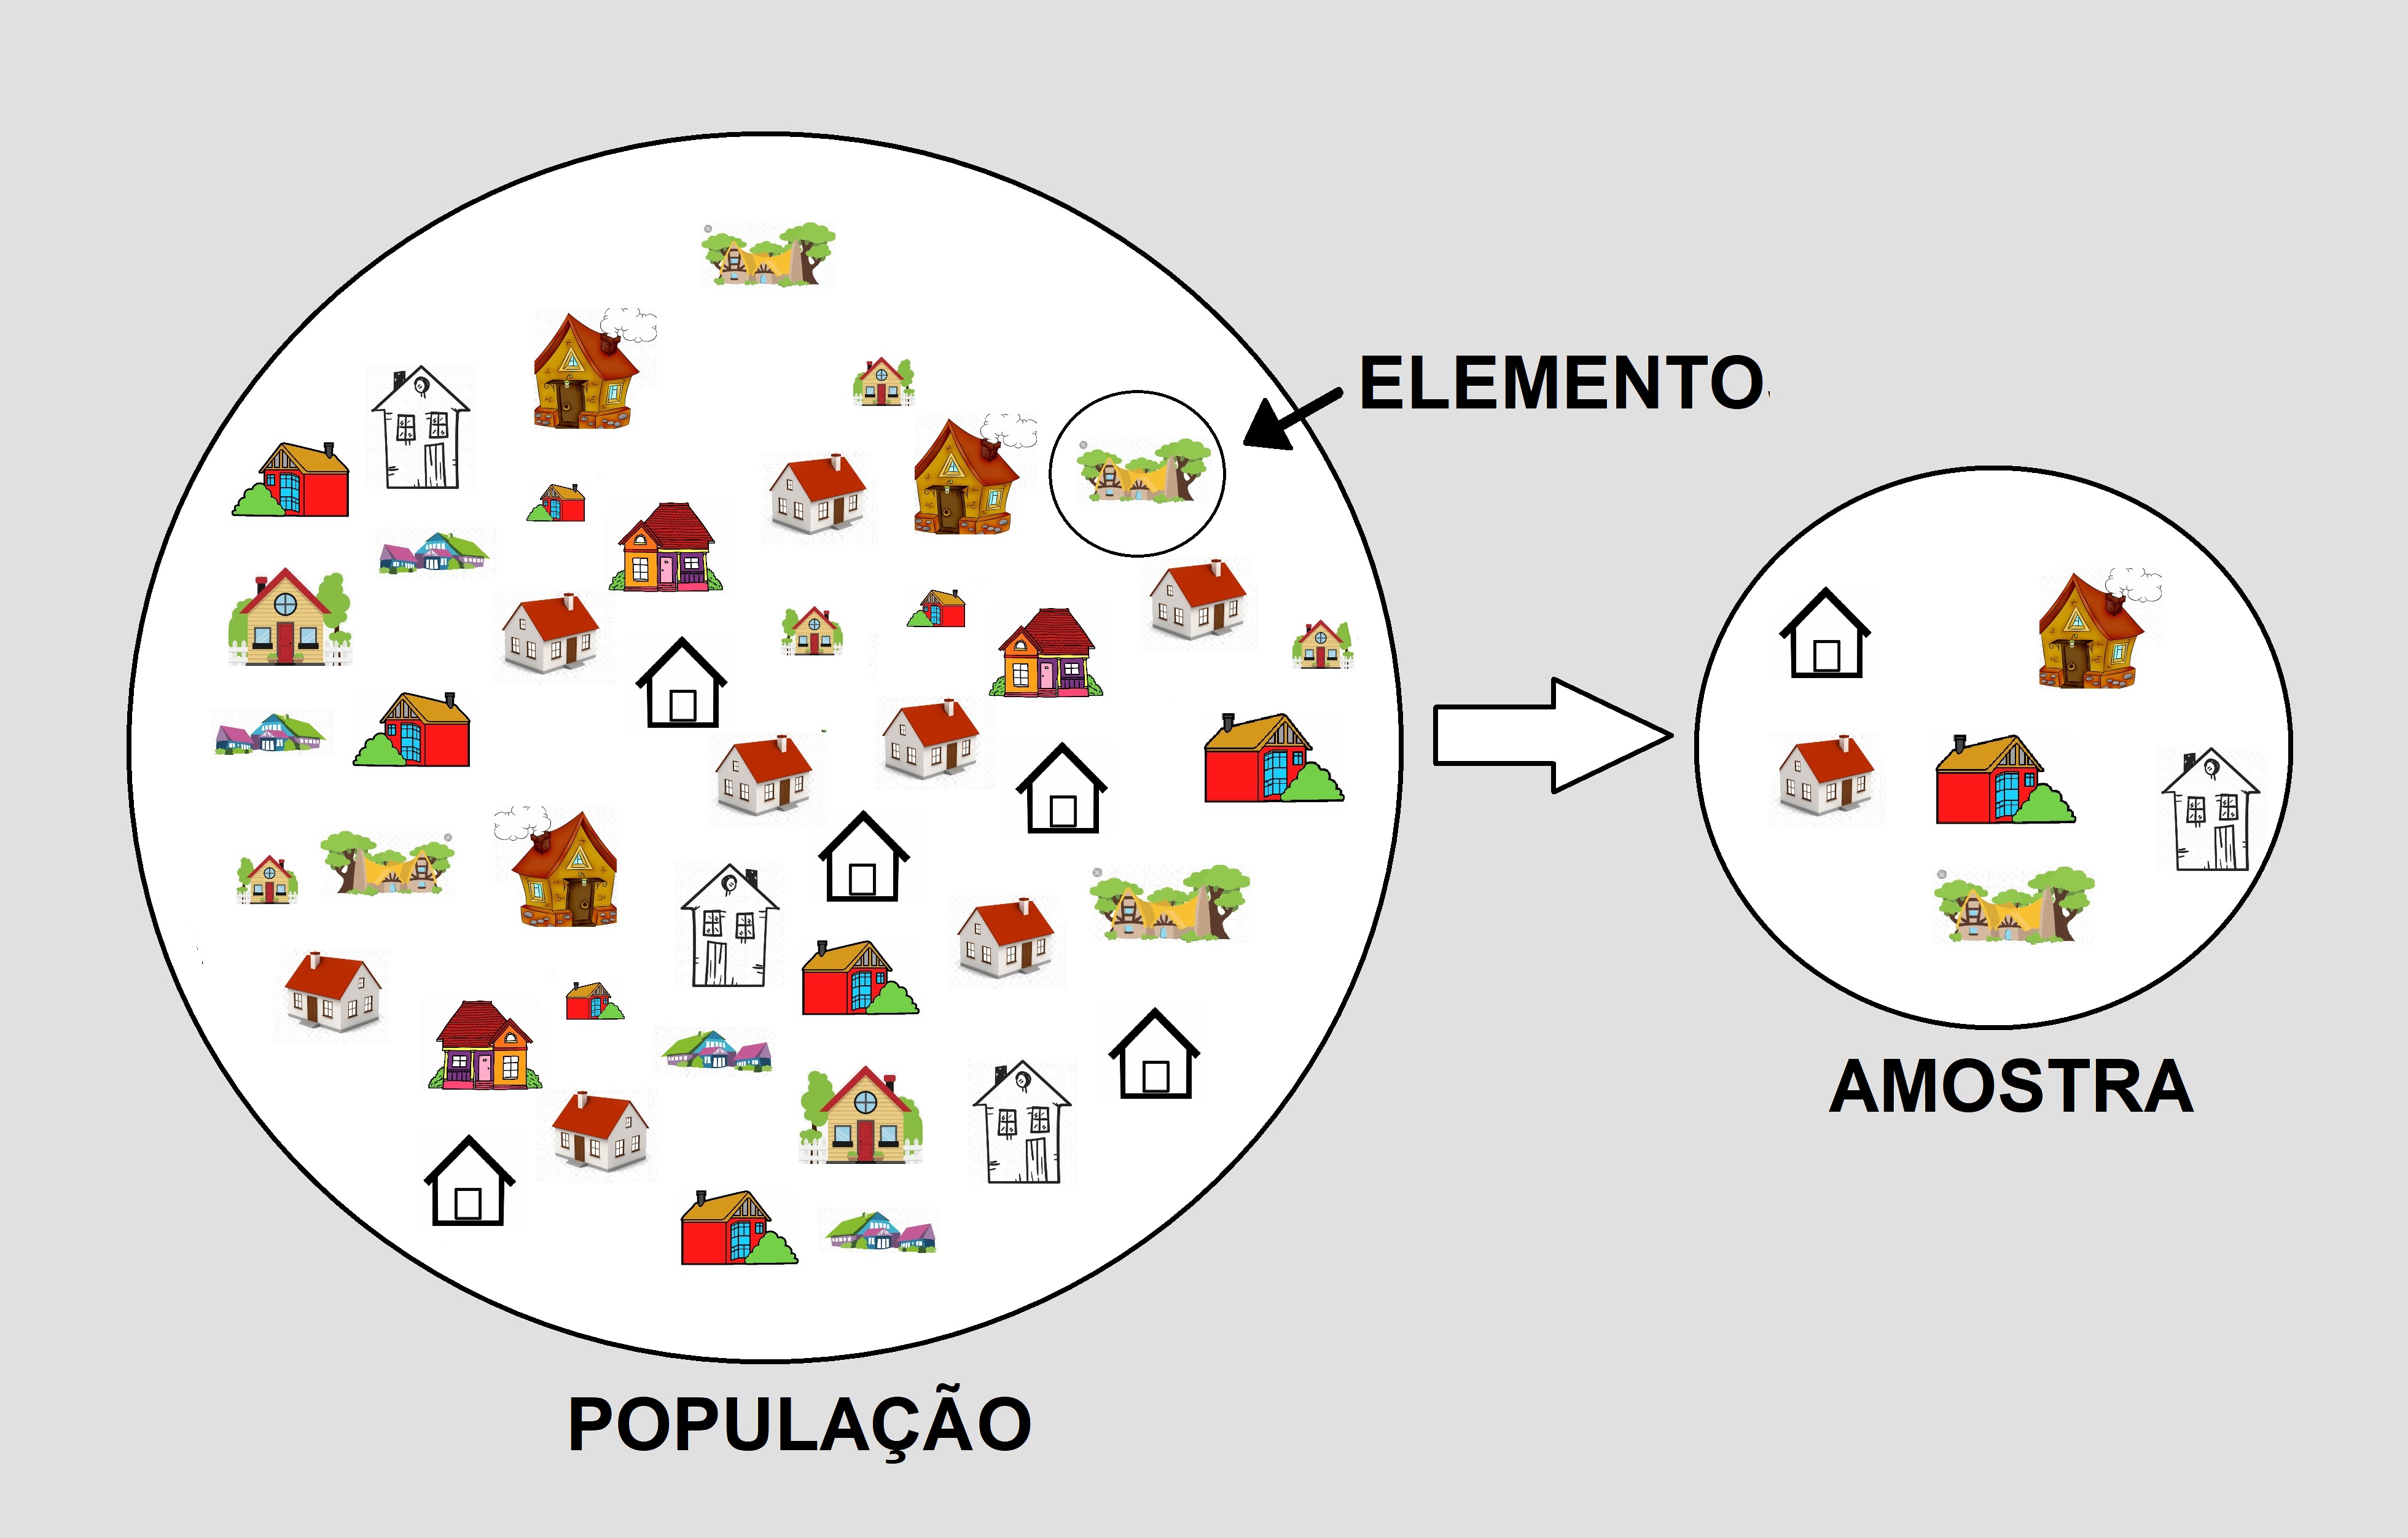
O conceito de amostra é utilizado no sentido de construir pontes entre dados observáveis e informações sobre a população inteira, mas essas pontes exigem fundações técnicas sólidas. Quando os fundamentos estão errados, nenhuma ferramenta estatística salva o resultado. Quando estão corretos, mesmo amostras modestas produzem estimativas confiáveis e decisões mais bem embasadas.
Galeria
-
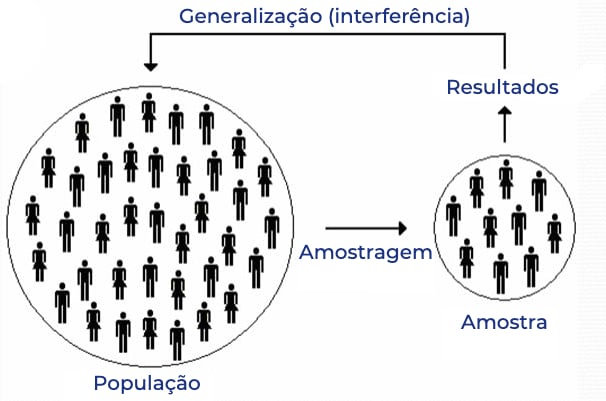
Amostragem Estratificada Distribuição Da Amostra Por Bairros E -
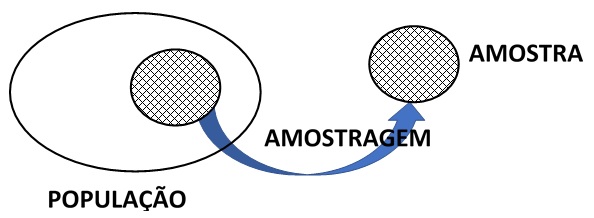
População e amostra - Professora Noemi Matemática -
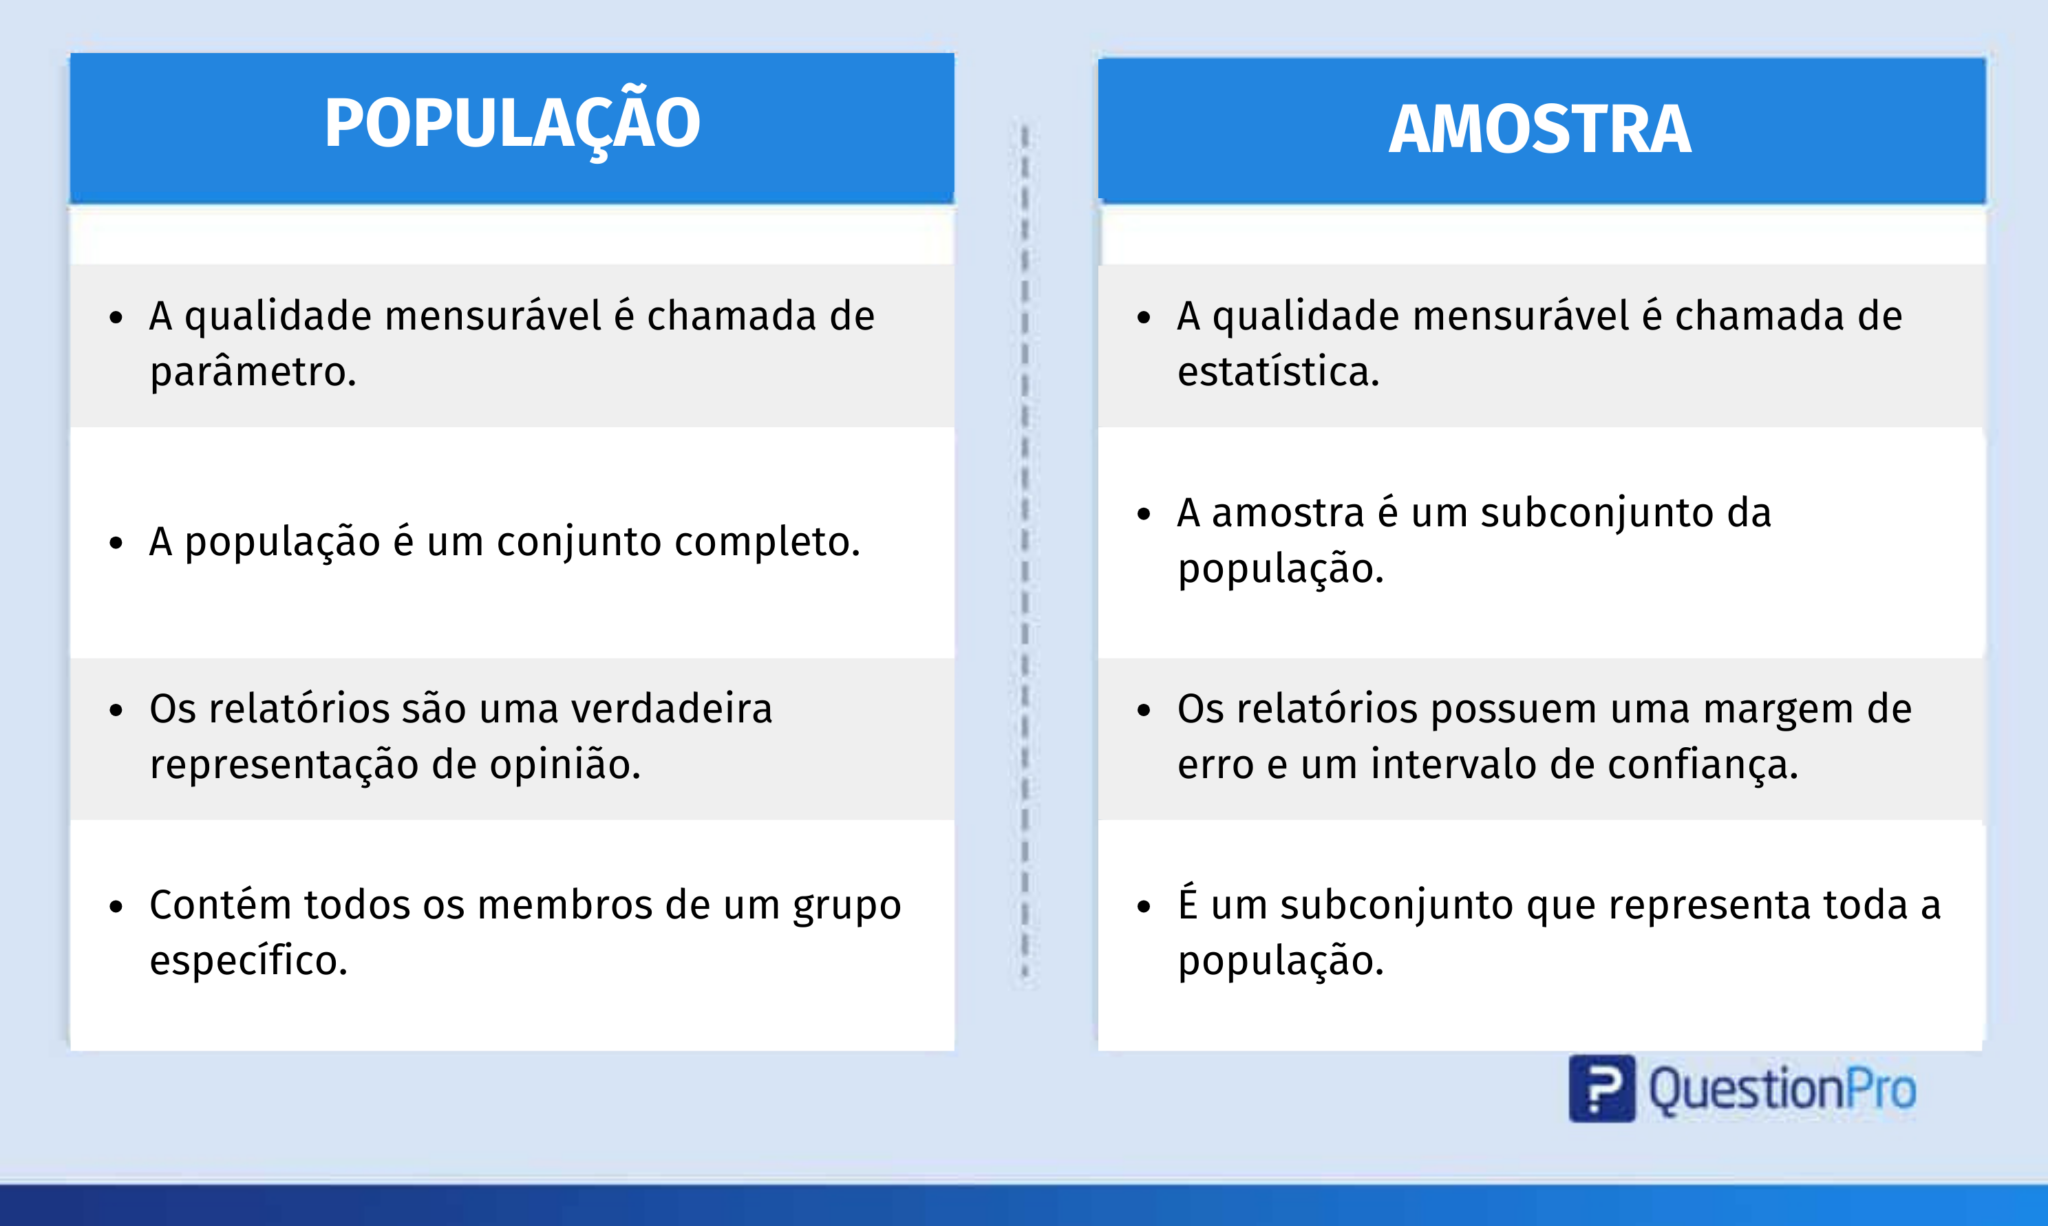
População e amostra: qual a diferença? Saiba aqui!
