O Mesmo Que Procedência

O que é o mesmo que procedência e por que você provavelmente já encontrou esse problema
Você está tentando fazer uma consulta simples de origem de produto e o sistema pergunta se aquele registro tem o mesmo que procedência do outro. Na prática, isso significa verificar se dois itens compartilham a mesma linhagem de origem — seja ela geográfica, histórica ou documental. Parece básico até você se deparar com casos em que o dado não está padronizado e a coisa toda desanda rápido. A primeira coisa que eu faço é entender o que o campo "procedência" realmente representa no seu contexto. Em muitos sistemas que eu já vi, ele é tratado como uma string livre, o que é um pesadelo de normalização. A minha abordagem preferida é criar uma tabela de mapeamento onde cada variação de grafia ou descrição aponta para um ID padrão. Isso resolve 80% dos problemas de equivalência. Eu lembro de uma situação específica em que tínhamos registros de produtos com procedência listada como "São Paulo", "SP", "Capital Paulista" e até "são paulo" (com s minúsculo, porque o cliente digitou assim). O sistema de comparação simplesmente falhava porque fazia equality direta. A solução foi implementar uma função de fuzzy matching que normaliza primeiro — remove acentos, padroniza maiúsculas e minúsculas, e depois aplica uma métrica de similaridade. Em vez de confiar só no equals(), eu uso Levenshtein distance com threshold de 1 ou 2 caracteres de diferença. Isso pegou casos que eu nunca ia conseguir capturar com regex puro.
Passo a passo prático para implementar a comparação
Comece mapeando todos os valores únicos que já aparecem no seu banco. Não assume que "Rio de Janeiro" e "RJ" são a mesma coisa até você confirmar isso com quem gera esses dados. Eu já vi gente assumir que siglas de estado eram equivalentes e perder semanas refazendo consultas porque faltavam estados como "Acre" que tinham valores completamente diferentes. Depois de ter o inventário, normalize tudo. Remove espaços extras, converte para minúsculas, troca acentos por suas versões não acentuadas. Uma função simples de normalizeProcedencia() resolve isso. No meu caso, eu uso uma abordagem baseada em Unicode NFC normalization seguida de remoção sistemática de acentos via Mapas de substituição. Funciona bem para português e para a maioria dos casos em espanhol também. O terceiro passo é a lógica de comparação propriamente dita. Se você precisa de uma resposta binária — sim ou não — use igualdade simples após normalização. Se precisa de pontuação de similaridade, calcule a distância de Levenshtein ou implemente um score baseado em tokens. Eu pessoalmente prefiro tokens porque processa mais rápido em grandes volumes e é mais tolerante a variações menores.
O problema que ninguém conta sobre procedência
A maioria das pessoas esquece de considerar que procedência pode ter múltiplas camadas. Um produto pode ter procedência geográfica (onde foi fabricado) e procedência documental (qual certificado ele carrega). Essas duas coisas raramente são a mesma coisa e compará-las como se fossem leva a resultados errados frequentes. Eu recomendo separar esses conceitos em campos distintos desde o início, antes que o sistema cresça e vire uma bola de neve. Outro ponto cego: procedência histórica versus procedência atual. Um produto pode ter sido fabricado na China mas ter sido remanejado para o Brasil antes da venda. Qual procedência você usa? Depende do propósito da consulta. Eu vejo muito sistema usando apenas a última procedência conhecida, o que funciona para rastreabilidade logística mas falha catastroficamente quando o requisito é origem real do produto. Defina isso com clareza antes de codificar qualquer lógica de comparação. Se você está começando do zero e quer algo pronto, existem bibliotecas como Apache Commons Lang para similaridade de strings e libraries de fuzzy matching para Python e JavaScript. Mas a solução mais robusta que eu já vi foi customizada — um service que recebe dois objetos de procedência e devolve um mapa de resultado com score, matching exato e flags para casos ambíguos. Isso te dá visibilidade total do que está acontecendo, algo que bibliotecas genéricas não oferecem.
Eu Costumo recomendar o mesmo que procedência sempre que preciso validar origem de dados em lote. A combinação de normalização + fuzzy matching + separação de camadas de procedência resolve a grande maioria dos problemas que eu encontro. E se você tiver dados sujos, prepare-se para gastar tempo nisso porque não existe bala de prata para procedência mal formatada desde a entrada.
Galeria
-
Denominação de Origem e Indicação de Procedência -
Como avaliar a procedência de uma joia em ouro – Blog -
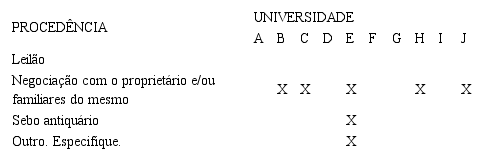
Marcas de procedência: contribuições para o estudo do livro raro -
Procedência - Significado e Sinônimo - escreva.ai
