O Paradigma Conexionista Tambem Conhecido Por Redes Neurais
O que você realmente precisa saber sobre redes neurais antes de tentar implementar
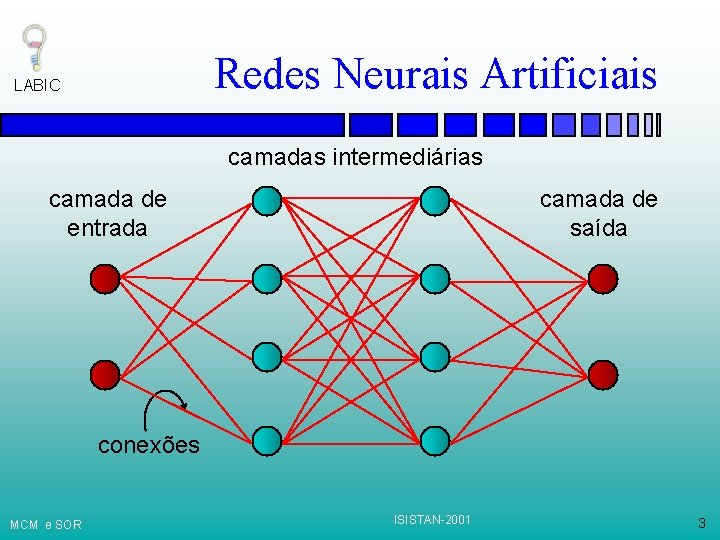
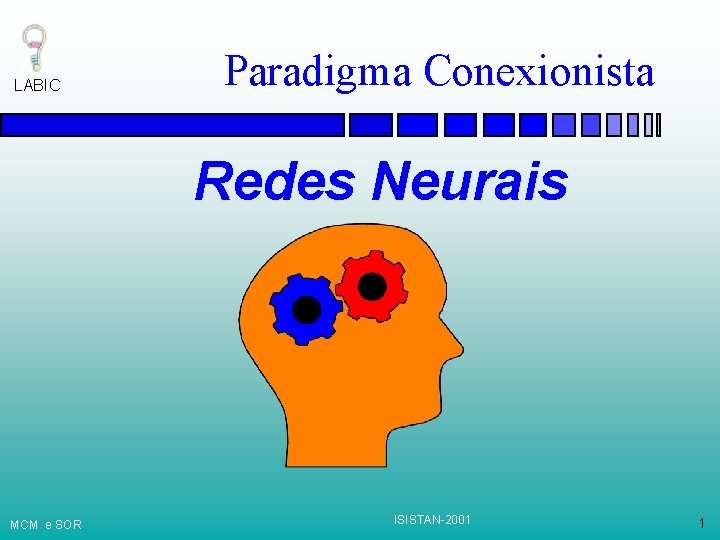
O paradigma conexionista tambem conhecido por redes neurais é, na prática, uma família de modelos que aprendem mapeamentos entre entradas e saídas ajustando pesos através de retropropagação. Nada mais, nada menos. A teoria é elegante. A implementação no mundo real costuma ser irritante. Vou começar pelo que ninguém conta nos tutoriais: a normalização dos dados. Se você não normalizar suas features antes de treinar, a maior parte do tempo de treino vai se perder em oscilações desnecessárias no gradiente. Eu vi modelos levarem 3x mais epochs apenas porque alguém esqueceu de aplicar standardization. Use MinMax ou StandardScaler antes de qualquer coisa. Isso não é opcional, é obrigatório. O cerne do funcionamento é simples. Cada neurônio recebe entradas, aplica pesos, soma um bias e passa por uma função de ativação. O conjunto disso forma uma camada. Múltiplas camadas criam uma rede profunda. O modelo produz uma previsão, você compara com o valor real usando uma função de perda, e a retropropagação calcula quanto cada peso contribuiu para o erro. Os pesos são atualizados com um otimizador, geralmente Adam. Repita até convergir.
o paradigma conexionista tambem conhecido por redes neurais
Aqui está um detalhe que quase ninguém menciona: a escolha da função de ativação importa muito mais do que a arquitetura em si.ReLU é padrão para camadas ocultas em redes feedforward, mas se você estiver trabalhando com dados que precisam preservar sinal negativo com precisão, pode considerar Leaky ReLU ou ELU. Já vi pessoas usarem sigmoid em camadas ocultas de redes profundas e se perguntarem por que o treino não convergia. O vanishing gradient é um problema real e sigmoid é uma das maiores causas. Sobre dropout. Muita gente aplica dropout em tudo e depois se decepciona com o overfitting nos dados de teste. Dropout deve ser usado principalmente nas camadas mais largas da rede, aquelas com milhares de parâmetros. Camadas de embedding ou as primeiras camadas de feature extraction geralmente se beneficiam menos. Um valor de 0.2 a 0.5 é suficiente na maioria dos casos. Mais que isso e você está basicamente treinando um modelo diferente a cada epoch, o que atrasa a convergência sem benefício proporcional. Agora vou contar um problema específico que tive. Trabalhei num projeto de classificação de séries temporais de sensores industriais com cerca de 50 mil amostras e 200 features de frequência. Usei uma rede LSTM com duas camadas de 128 unidades cada, dropout de 0.3 entre as camadas, e Adam como otimizador. O modelo treinava normalmente mas generalizava mal para dados de novos equipamentos. O overfitting estava acontecendo nas camadas mais profundas porque o dataset era muito pequeno para a capacity do modelo.
A solução que funcionou foi uma combinação de três coisas. Primeiro, reduzi a LSTM para uma única camada com 64 unidades. Segundo, adicionei Batch Normalization antes de cada camada LSTM. Terceiro, usei data augmentation simulada com pequenas perturbações Gaussianas nos sinais de entrada. O resultado foi uma queda de 18% na loss de validação em comparação com o modelo original. O trade-off foi que o treinamento ficou cerca de 40% mais lento devido ao Batch Norm, mas o ganho em generalização compensou ampiamente. Um insight contraintuitivo: mais dados não resolvem tudo. Tem um limite prático. Para datasets menores que 10 mil amostras, redes neurais profundas raramente superam métodos tradicionais como Random Forest ou Gradient Boosting, a menos que você tenha técnicas avançadas de regularização e augmentation. Eu perdi semanas tentando fazer uma rede convolucional funcionar bem num dataset de 3 mil imagens médicas quando um SVM com kernel RBF atingia 94% de acurácia em dois dias de setup. Sobre hardware. Se você não tem uma GPU, treinar redes com mais de três camadas escondidas em datasets medianos vai demorar muito. Um modelo simples de MLP com duas camadas de 256 unidades num dataset de classificação de texto com 100k amostras leva cerca de 15 minutos numa CPU moderna e 2 minutos numa GPU de entrada como uma RTX 3060. A diferença não é marginal. É a diferença entre iterar rapidamente e desistir do experimento.
Outro ponto negligenciado: o learning rate. Adam adapta o learning rate automaticamente para cada parâmetro, mas isso não significa que você possa ignorar completamente esse hiperparâmetro. O valor padrão de 0.001 funciona na maioria dos casos, mas para problemas com dados muito desbalanceados ou funções de perda com gradientes explosivos, reduzir para 0.0001 ou usar learning rate scheduling pode ser a diferença entre convergir e divergir. Eu já vi modelos explodirem (loss infinito) porque alguém copiou a arquitetura de um paper sem ajustar o learning rate para o seu dataset. Se você quer implementar algo prático, o caminho mais direto é usar PyTorch ou TensorFlow/Keras. Ambos têm abstrações que eliminam a necessidade de escrever retropropagação manualmente. Um modelo básico em Keras leva cerca de 20 linhas de código. A estrutura típica envolve definir uma sequência de camadas, compilar com otimizador e função de perda adequadas, e chamar fit com validação split. O tempo médio de setup para um modelo funcional é de 30 a 60 minutos para quem já tem familiaridade com o framework. Limitações importantes que você precisa considerar. Redes neurais são essencialmente black boxes. Interpretabilidade é praticamente inexistente sem ferramentas adicionais como SHAP ou LIME, e mesmo essas dão apenas aproximações. Para aplicações regulamentadas como saúde ou finanças, isso pode ser um problema sério. Além disso, redes neurais são sensíveis a outliers e dados ruídos. Uma pequena fração de labels incorretos num dataset de treino pode degradar significativamente a performance, especialmente em datasets grandes onde o modelo tem capacity suficiente para memorizar padrões errados.
Para quem está começando, recomendo uma ordem prática: domine primeiro MLPs simples em datasets tabulares como Iris ou MNIST. Entenda como cada hiperparâmetro afeta a loss curve. Só então avance para architectures mais complexas como CNNs para imagens ou LSTMs para sequências. Pular etapas gera más práticas que são difíceis de corrigir depois. Um recurso útil para download de datasets e benchmarks é o Hugging Face Datasets, que permite carregar centenas de datasets com uma linha de código. Para modelos pré-treinados, o transformers library da Hugging Face oferece acesso a arquiteturas padrão como BERT, ResNet e EfficientNet, o que evita treinar do zero quando transfer learning é suficiente.
Galeria
-
LABIC Paradigma Conexionista Redes Neurais MCM e SOR -

Redes neurais artificiais sistema conexionista ann ia generativa | Foto ... -
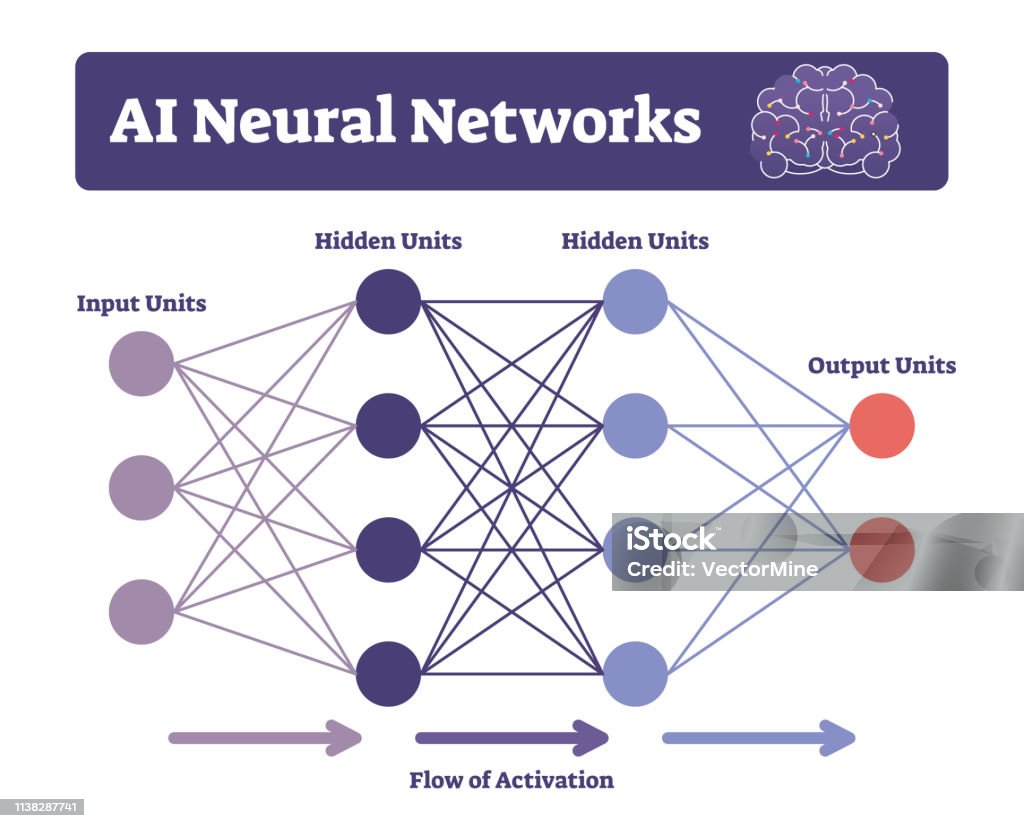
Vetores de Ilustração Do Vetor Das Redes Neurais Ai Rotulado Esquema ... -

Avatares del paradigma conexionista | Ciencia Cognitiva
