O Pyspark Caracteriza-se Como Uma Biblioteca Spark

O que é o PySpark na prática
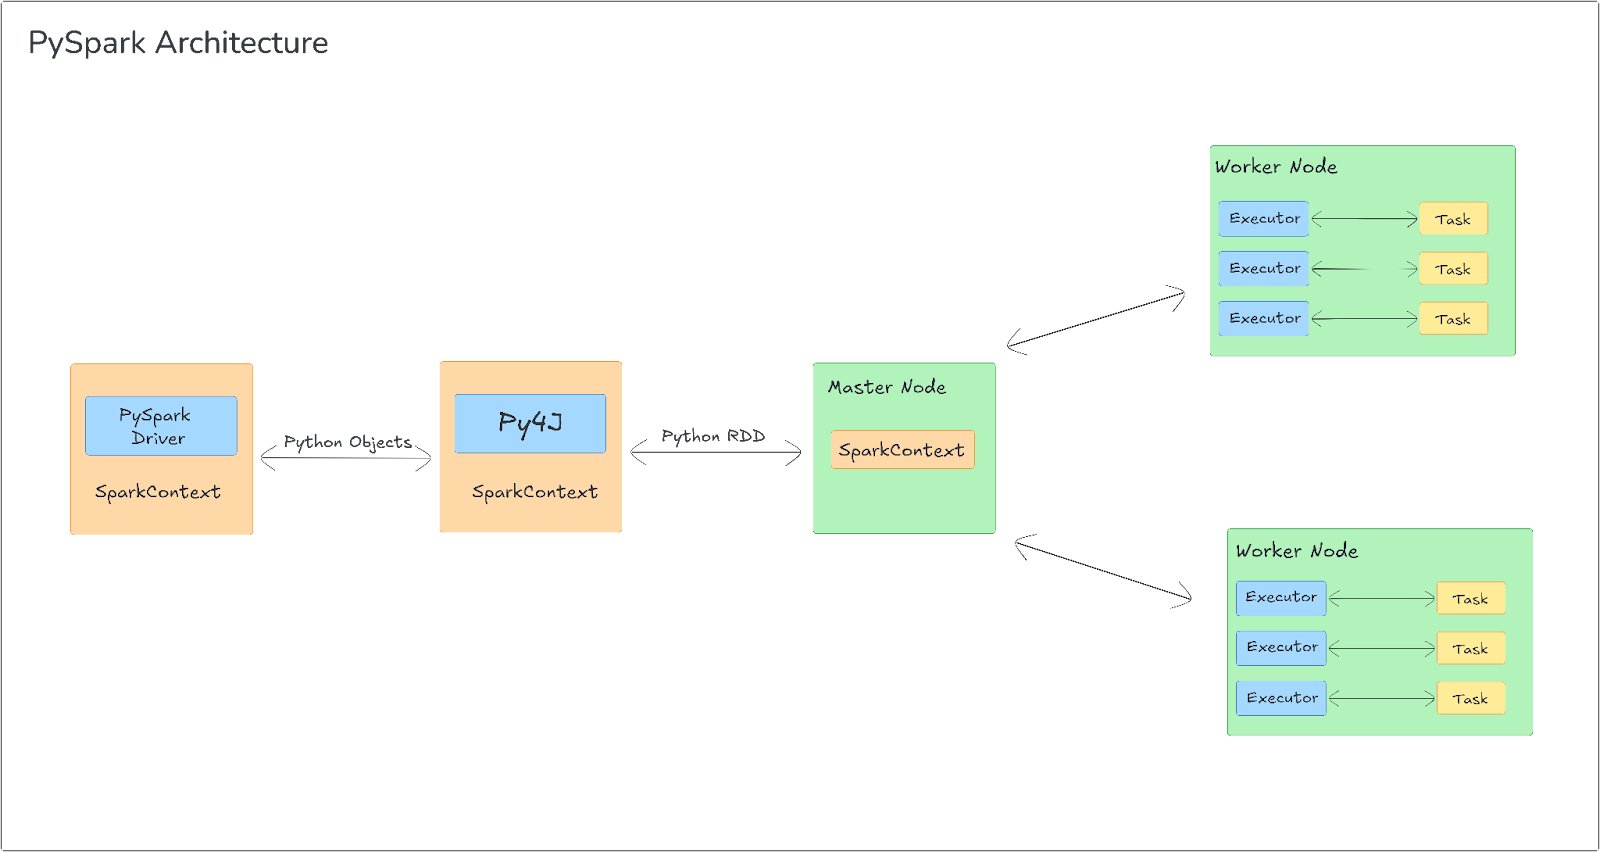
A maior parte dos artigos que aparecem no Google explica o PySpark como um wrapper Python do Apache Spark, mas a realidade do dia a dia é bem mais específica. O PySpark não é apenas uma interface. Ele é uma camada de execução completa que traduz operações DataFrame do Python para o motor JVM do Spark, serializa dados via Arrow, e orquestra o trabalho distribuído entre workers. Isso significa que a experiência de uso não é idêntica ao Spark em Scala ou Java, e entender essas diferenças é o que separa quem consegue entregar pipelines funcionais de quem fica horas debugando problemas de performance. A afirmação parece óbvia, mas tem implicações diretas que muitos desenvolvedores ignoram até cometerem o erro. Como biblioteca Spark, o PySpark herda todas as limitações arquiteturais da JVM. Serialização, shuffle, broadcast joins, gerenciamento de memória no driver — tudo isso existe e age da mesma forma que no Scala. A diferença é que no PySpark você vê os efeitos colaterais mais cedo porque o interpretador Python adiciona overhead adicional em cada operação. Eu já passei por um caso específico que ilustra bem isso. Tinha um job que processava dados de logs de acesso com cerca de 12 GB compactados, divididos em partições de 150 MB. O código era simples: filtro por timestamp, join com uma tabela de referência de 3 GB, group by e agregação. No desenvolvimento, rodava em modo local com master="local[*]" e levava cerca de 8 minutos. Quando subi para um cluster com 3 workers de 8 GB de memória, o job travou. O erro era OutOfMemoryError no driver, mas o problema real estava em outro lugar. O join com a tabela de referência estava sendo resolvido sem broadcast, e como a tabela era pequena demais para justificar broadcast mas grande demais para ficar na memória sem esquema otimizado, o Spark tentou fazer um sort-merge join disperso. A solução foi forçar um broadcast explícito usando spark.sparkContext.broadcast() na tabela de referência antes do join, ou ajustar o limiar com a propriedade spark.sql.autoBroadcastJoinThreshold para um valor menor que o tamanho da tabela. Na prática, o job caiu de 8 minutos para 45 segundos no mesmo cluster.
Esse tipo de situação não aparece na documentação oficial. Aparece quando você lê logs de execução, monitora a UI do Spark e percebe que uma fase do DAG está consumindo memória desproporcional. A lição é que conhecer o PySpark superficialmente não basta. Você precisa entender como o motor toma decisões de plano de execução e como o Python se encaixa nessa equação.
Instalação e configuração básica
O PySpark pode ser instalado via pip, mas instalar não é o mesmo que configurar corretamente. O comando pip install pyspark baixa a distribuição e resolve as dependências, mas em ambientes de produção o cenário muda. Você precisa definir as variáveis de ambiente SPARK_HOME e adicionar o caminho dos executáveis ao PATH. No Linux ou macOS, isso costuma ficar em /usr/local/spark, mas depende de como o Spark foi instalado originalmente. No Windows, o caminho varia conforme a versão e o gerenciador usado. Um detalhe importante que muita gente perde é a compatibilidade entre versões. O PySpark instalado via pip traz sua própria cópia do Spark embutida, mas se você estiver trabalhando com um cluster existente rodando Spark 3.4, usar uma versão diferente do PySpark local pode causar incompatibilidades silenciosas. A recomendação é sempre alinhar as versões. Se seu cluster roda Spark 3.4.3, instale pyspark==3.4.3. Não ignore isso. Outro ponto prático: o PySpark depende de um runtime Java. Especificamente, JDK 8 ou 11 para versões até 3.3, e JDK 11 ou 17 para versões 3.4+. Se o JAVA_HOME não estiver configurado ou apontar para a versão errada, o Spark nem sequer inicia, e o erro que aparece na tela pode ser confuso. Eu já perdi duas horas rastreando esse problema em uma máquina que tinha múltiplas versões do Java instaladas. A solução foi desinstalar todas exceto uma e configurar o JAVA_HOME explicitamente no .bashrc ou .zshrc.

Como o PySpark funciona por baixo dos panos
Quando você chama SparkSession.builder().getOrCreate(), o Spark inicia uma JVM separada no background. O processo Python se comunica com essa JVM através de um protocolo baseado em subprocessos e serialização Pickle. Cada DataFrame que você cria é traduzido internamente para um DataFrame do Spark em Scala, e cada transformação que você aplica gera um estágio no plano de execução. A tradução não é instantânea. Operações em lote, como .toPandas(), podem disparar a transferência de megabytes de dados da JVM para o processo Python, o que muitas vezes é a causa de estouro de memória que ninguém consegue diagnosticar no primeiro olhar. Uma coisa que desenvolvedores vindos do Pandas frequentemente fazem errado é tratar o PySpark como se fosse Pandas distribuído. A semântica é parecida na superfície, mas o comportamento interno é radicalmente diferente. No PySpark, .filter() não modifica o DataFrame em si. Ele cria um novo plano de execução. Operações são preguiçosas por padrão, o que significa que nada acontece até você chamar .collect(), .show(), .write(), ou qualquer ação que force a execução. Isso pode ser útil para performance, mas é fácil esquecer e construir pipelines inteiros sem saber se algo está realmente sendo processado ou apenas registrado como plano de execução. O uso de UDFs no PySpark merece atenção especial. UDFs definidas em Python são executadas em processos separados da JVM, o que introduz custos de serialização e comunicação que podem transformar uma operação rápida em um gargalo sério. Eu tive um caso onde uma UDF simples de normalização de texto reduziu a velocidade de processamento de 2 minutos para 25 minutos em um dataset de 50 GB. A solução foi substituir a UDF por uma expressão built-in do PySpark, que roda diretamente na JVM e evita completamente a sobrecarga de comunicação entre processos.
Pitfalls comuns que ninguém menciona
O número de partições é um dos problemas mais subestimados no PySpark. Por padrão, o Spark usa um número de partições que pode ser muito alto para datasets pequenos ou muito baixo para datasets grandes. Se você carrega um arquivo CSV com 1 milhão de linhas e deixa o número de partições padrão, o Spark pode criar 200 partições de 5 MB cada, o que gera overhead desnecessário de orchestrção. O inverso também é verdade: datasets de terabytes com poucas partições geram desbalanceamento severo. A regra prática que eu uso é ajustar para aproximadamente 2x o número de cores disponíveis no cluster, mas isso varia conforme o tipo de operação. Joins e agregações pesadas podem se beneficiar de mais partições, enquanto operações de leitura simples geralmente funcionam melhor com menos. O cache também é uma área onde muita gente erra. Chamar .cache() ou .persist() sem verificar se o DataFrame realmente será reutilizado é um desperdício de memória. Eu já vi pipelines inteiros com cache aplicado em DataFrames que eram consumidos uma única vez, ocupando gigabytes de memória no cluster sem nenhum benefício. A verificação básica é simples: se uma transformação aparece mais de uma vez no plano de execução ou se o mesmo DataFrame é usado em múltiplas ações, o cache faz sentido. Caso contrário, é melhor não usar. Outro problema recorrente é o tratamento de nulos em operações de group by. No PySpark, colunas com valor null são agrupadas juntas, o que pode ser inesperado para quem vem do SQL tradicional onde null é tratado de forma diferente. Se você precisa separar nulos de valores válidos, o workaround é usar coalesce() ou na.fill() antes da agregação.
Quando não usar PySpark
O PySpark não é a solução para tudo. Para datasets que cabem na memória de uma única máquina, o Pandas ou o Polars são significativamente mais rápidos e consomem menos recursos. O overhead do Spark para jobs pequenos pode ser de 30 a 60 segundos só para inicialização, o que transforma um cálculo que levaria 2 segundos em um processo de mais de 1 minuto. Para análise interativa em tempo real, o DuckDB oferece resultados ordem de grandeza mais rápido com a mesma quantidade de código. E para pipelines que exigem controle fino de memory management e garbage collection, o Spark em Scala ou Java oferece muito mais previsibilidade. O PySpark brilha em dois cenários principais: datasets que não cabem em uma única máquina, e workflows que envolvem múltiplas transformações complexas em dados estruturados ou semiestruturados. Fora desses casos, avaliar alternativas antes de entrar no ecossistema Spark pode economizar horas de debugging e configuração.
Download e recursos
O PySpark está disponível no PyPI. A instalação direta via pip resolve a maioria dos casos de uso individual e desenvolvimento. Para produção em cluster, o Spark precisa ser instalado separadamente e o PySpark instalado localmente deve ser versionado para corresponder. Os documentos oficiais estão em spark.apache.org, e a documentação da API Python segue o mesmo padrão da comunidade com exemplos atualizados para cada versão lançada. O que diferencia quem entrega projetos com PySpark de quem trava nos primeiros testes não é o conhecimento da sintaxe. É a familiaridade com como o motor toma decisões, onde os gargalos aparecem, e como diagnosticar problemas que parecem vir do Python mas na verdade vêm da JVM. Esses detalhes aparecem com o tempo de uso, mas saber antecipadamente onde eles existem já coloca você alguns passos à frente.
Galeria
-
🚀 Explorando o Poder do Spark com PySpark: O Que é um RDD? No universo ... -
PySpark: Qué es, para qué sirve y cómo usarlo -
Como aprender PySpark do zero em 2026 | DataCamp

