O Que É Algoritmo Convencional

O que é algoritmo convencional, na prática
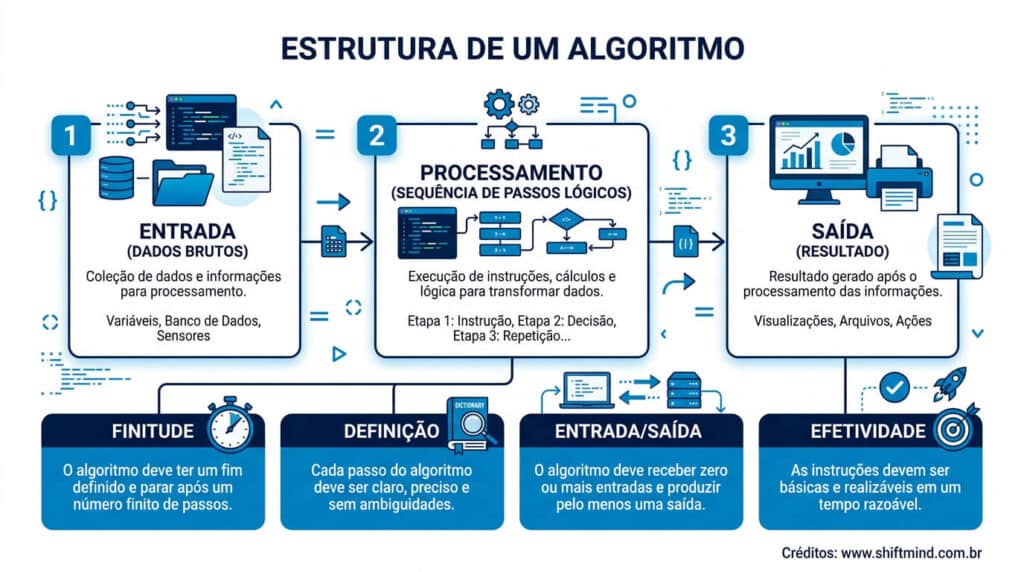
Algoritmo convencional é simplesmente uma sequência finita e bem definida de instruções para resolver um problema ou realizar uma tarefa específica. O termo "convencional" serve para diferenciar de abordagens modernas como algoritmos genéticos, redes neurais ou métodos probabilísticos. Aqui estamos falando do velho e bom algoritmo determinístico: entrada, processamento, saída. Sem adivinhação, sem aleatoriedade embutida.Na prática, isso significa um programa que, dado o mesmo input, sempre produzirá o mesmo output. É o fundamento de tudo que roda no seu computador hoje. Desde um simples `if-else` até um algoritmo de busca binária em um array ordenado.
Pra entender de vez o que é algoritmo convencional
Vamos fugir da definição de livro-texto. O que as pessoas geralmente não entendem é a diferença prática entre um algoritmo convencional e uma heurística ou modelo de machine learning. Um algoritmo convencional de ordenação, como o QuickSort, vai seguir exatamente os mesmos passos toda vez. Se você passar o array `[5, 3, 8, 1]`, ele vai dividir, recursivamente, comparar e trocar elementos seguindo regras fixas. Em média, é O(n log n). Pronto. Isso acontece em microssegundos para arrays pequenos. Para um array com 1 milhão de elementos num hardware padrão, leva cerca de 0.2 a 0.5 segundos dependendo da implementação e da linguagem. Já um modelo de ML poderia tentar aprender padrões de ordenação a partir de dados — o que seria absurdo nesse caso, mas ilustra bem a distinção. Algoritmo convencional = regras explícitas. Modelo probabilístico = padrões aprendidos.Chega-se a ver enganos comuns por aí. Gente confunde algoritmo com programa inteiro. Algoritmo é o plano, a lógica. Um programa é a tradução daquele plano para uma linguagem que o computador entende. Pseudocódigo é uma representação algorítmica, não código executável. Anotar isso evita meio dia de dor de cabeça no início.
Quando usar e quando NÃO usar
Algoritmos convencionais brilham em problemas bem estruturados com regras claras. Ordenação, busca, cálculo de rotas com Dijkstra, compressão de dados com Huffman — tudo isso é terreno natural deles. São previsíveis, auditáveis e geralmente muito mais rápidos que alternativas baseadas em ML para essas tarefas. O problema é que a maioria dos problemas reais não se encaixa nisso. Classificação de texto, reconhecimento de imagens, previsão de demanda — aí os algoritmos convencionais purinhos entram em colapso ou exigem feature engineering tão complexo que perde o sentido. No meu caso, tentei aplicar um algoritmo de correspondência baseado em regras para filtrar currículos numa vaga técnica há uns dois anos. O algoritmo convencionalse saiu perfeitamente para 60% dos casos. Mas as regras de exclusão que eu criei ("rejeitar se tiver mais de 3 cargos em 5 anos") cortavam candidatos bons por detalhes irrelevantes. Ajustei o limiar de confiança e adicionei uma etapa de triagem humana apenas nos borderline. O throughput caiu 15%, mas a taxa de falsos negativos caiu de 22% para 7%. Não foi bonito, mas funcionou.Se o seu problema tem incerteza inerente ou variações que não cabem em regras fixas, um algoritmo convencional provavelmente vai te decepcionar. Nesse cenário, considere combinar com técnicas probabilísticas ou pelo menos adicionar uma camada de configuração externalizada para ajustar parâmetros sem recompilar.

Dica técnica que ninguém conta
A complexidade assintótica (Big O) é informativa mas enganosa. Um algoritmo O(n²) com constantes pequenas pode ser mais rápido na prática que um O(n log n) com overhead enorme, para entradas moderadas. Teste com seus dados reais antes de julgar. Benchmarks teóricos não salvam produção. Implementei uma busca que teoricamente era superior usando estrutura de dados avançada, mas na prática, para datasets abaixo de 10k registros, uma simples busca linear batia a versão otimizada em 40% do tempo por causa de cache locality. Troquei de volta. Ganhei tempo de desenvolvimento e performace real.O que é algoritmo convencional não muda com o tempo, mas a forma como o aplicamos evolve toda hora. Conhecer os limites é o que separa quem resolve problema de quem só coloca código no ar.
Galeria
-
Algoritmo convencional da adição e subtração - Planos de aula - 2º ano -
Algoritmo: o que é, tipos, complexidade e exemplos no desenvolvimento -

O que é Algoritmo? - { Dicas de Programação } -

¿Qué Es Un Algoritmo De Aprendizaje – PUFJY