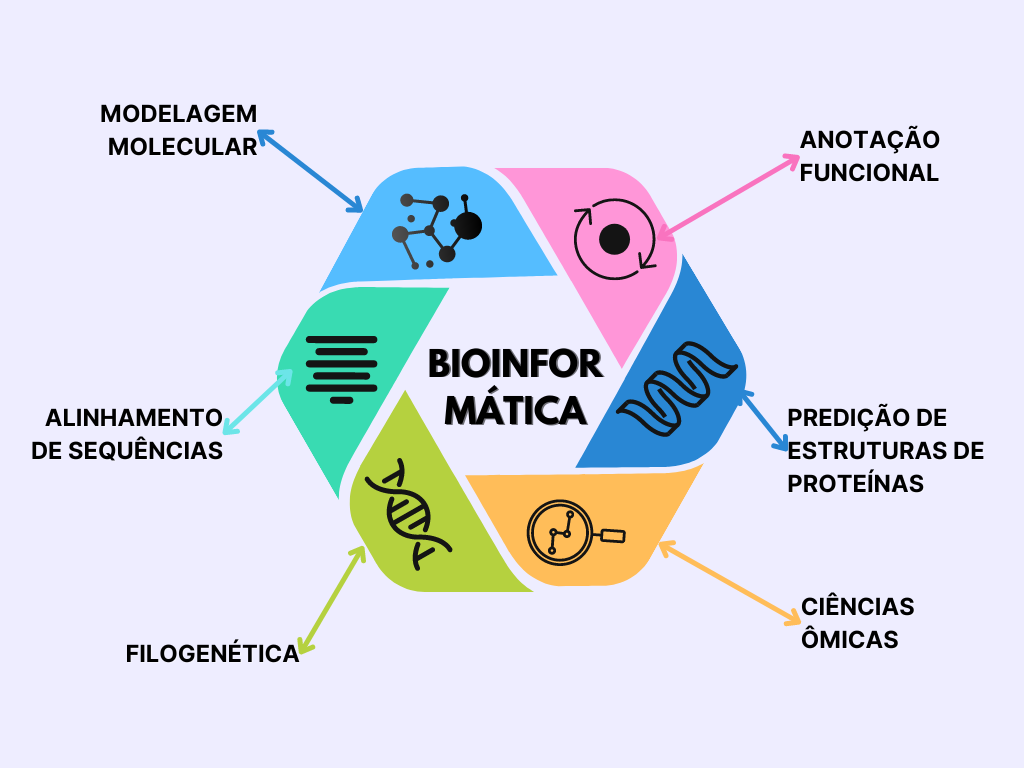
O Que É Bioinformatica

Eu passei os últimos anos trabalhando com dados de sequenciamento de nova geração e, se você me perguntasse o que eu faço, provavelmente diria que "analiso sequências". A verdade é muito mais simples: eu transformo terabytes de dados brutos em respostas biológicas que fazem sentido. Isso é bioinformática na prática, fora dos livros didáticos. O campo existe porque a biologia moderna gera dados demais para qualquer pessoa processar manualmente. Um único experimento de RNA-seq pode produzir entre 20 e 100 gigabytes de dados brutos. Sem ferramentas computacionais, isso seria apenas ruído. O básico envolve três etapas principais: controle de qualidade dos dados, alinhamento ou montagem das sequências contra um genoma de referência, e análise estatística diferencial.
O que é bioinformatica e como ela funciona no dia a dia
A bioinformática combina biologia, ciência da computação e estatística. Não é só programar, nem só biologia. Você precisa entender o que está analisando e saber lidar com arquivos que quebram no meio do processamento. Eu já perdi uma noite inteira porque um arquivo FASTQ estava corrompido no final e nenhum filtro de qualidade havia capturado o problema. O workaround foi escrever um script Python simples que verificava o tamanho de cada leitura e removia os outliers antes do alinhamento. As ferramentas mais usadas dependem do tipo de dado. Para alinhamento de reads curtos, BWA e Bowtie2 são padrão no campo. Para montagem de novo, SPAdes e Flye são confiáveis, embora cada um tenha limitações específicas. SPAdes funciona bem com dados Illumina, mas falha com reads longos do PacBio. Flye é projetado para long reads, mas pode produzir contigs fragmentados em genomas muito repetitivos. O fluxo de trabalho típico começa com FastQC para avaliar a qualidade. Se a qualidade estiver ruim nas extremidades, usamos Trimmomatic ou Cutadapt para limpar os dados. Depois do alinhamento, SAMtools e Picard processam os arquivos BAM. Para expressão diferencial, DESeq2 e edgeR são as ferramentas padrão, mas exigem familiaridade com modelagem estatística.
Um detalhe que iniciantes costumam ignorar é o controle de versão dos dados e pipelines. Eu documentei todos os parâmetros de cada análise em arquivos de configuração YAML. Isso facilita replicabilidade e diagnóstico quando algo sai errado. Sem documentação, você não consegue rastrear qual versão de uma ferramenta produziu um resultadoquestionável meses depois. Outra armadilha comum é a falta de espaço em disco. Dados de sequenciamento crescem rápido. Um projeto simples de RNA-seq com 20 amostras pode facilmente ocupar 2 terabytes de armazenamento. Planeje espaço antes de começar, não depois. Há também o problema dos falsos positivos em análises de expressão diferencial. Quando você testa milhares de genes simultaneamente, o risco de encontrar resultados significativos por acaso aumenta drasticamente. O ajuste de Benjamini-Hochberg controla a taxa de descoberta falsa, mas não elimina o problema completamente. Replicados biológicos são essenciais, não opcionais.

Eu já vi pesquisadores publicarem resultados com apenas dois replicados por condição. Os números pareciam bonitos, mas a variabilidade biológica era tão alta que as conclusões não sobreviveram à replicação independente. Recomendo no mínimo três, preferencialmente quatro replicados biológicos. Existem limitações sérias que a literatura às vezes minimiza. Alinhadores falham em regiões altamente repetitivas. Montadores produzem artefatos quando há contaminação bacteriana em amostras eucarióticas. Ferramentas de quantificação assumem distribuições que nem sempre correspondem aos dados reais. Para análise de variantes, GATK é o padrão ouro, mas exige tuning cuidadoso de parâmetros. A chamada "best practices" do GATK funciona bem para variant calling de SNPs em humanos, mas performa pior em plantas com genomas poliplóides. Nesses casos, DeepVariant pode ser uma alternativa, embora seja computacionalmente mais caro.
A área também enfrenta o problema da reproducibilidade entre plataformas. Resultados obtidos com Illumina podem diferir de dados Nanopore na mesma amostra, especialmente em regiões com alto conteúdo GC. Nenhum pipeline atual resolve isso completamente. O melhor é reconhecer a limitação e validar achados importantes com métodos ortogonais. Pessoalmente, eu prefiro trabalhar em ambientes containerizados com Singularity ou Docker. Isso elimina problemas de compatibilidade de bibliotecas e facilita a execução em clusters de alta performance. Eu tenho um image Docker com todas as ferramentas essenciais que uso regularmente. Leva alguns minutos para iniciar, mas economiza horas de troubleshooting. Se você está começando, recomendo dominar Linux básico e Python antes de mergulhar em pipelines complexos. Compreender o que cada comando faz, não apenas copiar e colar scripts da internet. Eu já vi muitos erros críticos originarem de pessoas que não entendiam por que um pipeline quebrava.
O campo evolui rápido. Ferramentas que eram padrão há cinco anos estão sendo substituídas por alternativas mais precisas ou eficientes. Mantenha-se atualizado, mas desconfie de hype excessivo. Novas ferramentas precisam ser validadas rigorosamente antes de serem adotadas em projetos de pesquisa sérios. Bioinformática não é mágica. É trabalho técnico, repetitivo às vezes, mas fundamental para a biologia moderna. Sem ela, simplesmente não conseguiríamos interpretar os dados que geramos diariamente. O conhecimento vem com experiência, e a experiência vem de quebrar coisas e consertar.

Galeria
-
[Bioinformática] O que é? + História e Origem 2026 -

O que é bioinformática e como se aplica à oncologia? -
Bioinformática na luta contra o câncer: os bancos de dados na pesquisa ...