O Que É Cardinalidade

Por que seu SQL fica lento mesmo com índices bons
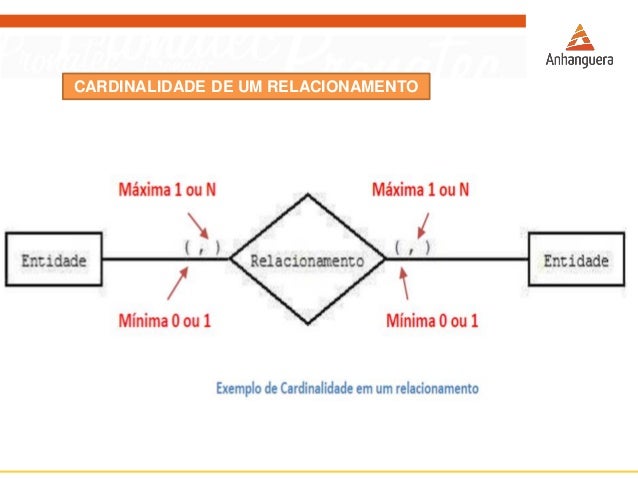
Você cria uma query que deveria voltar rápido. O plano de execução mostra um índice sendo usado. A consulta ainda leva 4 segundos. A diferença quase sempre está em cardinalidade e em como o otimizador a entende. Cardinalidade é o número de valores distintos que uma coluna ou conjunto de colunas contém. É um conceito contábil do otimizador, não uma regra da sua modelagem. Ele estima quantas linhas vão passar por cada operação e escolhe o plano com base nisso. Existem dois usos do termo que não podem ser confundidos. O primeiro é a cardinalidade de uma coluna, medida em valores únicos. O segundo é a cardinalidade de um relacionamento, aquela coisa de um-para-um, um-para-muitos e muitos-para-muitos que aparece em diagramas.
Se você trabalha com PostgreSQL ou MySQL, costuma ver isso como stats de tabela e de coluna. Se mora em SQL Server, vê como estimativa de linhas versus linhas reais no plano. O problema é o mesmo em qualquer motor: a estimativa errada distorce todo o resto.
Como a cardinalidade entra no plano de execução
O otimizador lê estatísticas. Estatísticas vêm de amostragem ou de varreduras completas, dependendo do tamanho da tabela e da configuração. A partir disso, ele calcula sequelecidade, custo de índice versus varredura, escolha entre nested loop e hash join, e agrupamento de colunas nos índices. Um índice em coluna de baixa cardinalidade muitas vezes é inútil para filtros seletivos. Uma coluna de gênero com dois valores não salva query que busca por status de conta. Um índice em CPF com centenas de milhões de valores distintos é outro assunto. O erro mais comum que vejo é tratar cardinalidade como sinônimo de quantidade de linhas. Não é. É quantidade de valores distintos. Uma tabela com 10 milhões de linhas pode ter cardinalidade 1 em uma coluna que é sempre fixa.

Um caso que eu vi acontecer de novo
Eu estava ajustando uma query de relatório em PostgreSQL com uma tabela de eventos de cerca de 40 milhões de linhas. A coluna data_hora tinha distribuição claramente inclinada porque parte da coleta vinha de um lote noturno. O plano escolhia full scan porque a estatística antiga impunha cardinalidade uniforme. A solução não foi “criar índice”. Foi atualizar estatísticas com ajuste de distribuição e, depois, criar um índice multicolumna na ordem que a query realmente usava: data_hora, tipo_evento, id_cliente. O tempo caiu de segundos para frações de segundo, mas o ganho veio da combinação de histograma correto com ordem de colunas no índice, não só do índice em si. Em SQL Server, um problema parecido apareceu com variável de tabela. O otimizador assumia 1 linha. A correção usou OPTION RECOMPILE ou estatísticas atualizadas, porque estimativa fixa mata a escolha de join quando a variável na verdade trazia milhares de linhas.
Cardinalidade de relacionamento versus cardinalidade de coluna
Essa separação é importante no dia a dia. Cardinalidade de relacionamento define como as tabelas se ligam. Ela responde se um registro na tabela A pode ter múltiplos registros na tabela B. Isso orienta chave estrangeira, restrição e modelagem. Cardinalidade de coluna entra no otimizador. Ela responde quantos valores únicos existem e como eles se distribuem. Isso orienta uso de índice, escolha de join e estimativa de custo. Muita gente monta o modelo perfeito e ainda vê query lenta. O modelo pode estar certo. As estatísticas podem estar erradas. A variável de ambiente pode estar enviesada. A query pode usar parâmetro que muda drasticamente a seletividade.
Erros comuns que eu recomendo evitar
- Confiar em estatísticas antigas após carga massiva. Atualize-stats ou espere o auto-vacuum fazer seu trabalho, mas monitore.
- Criar índice em coluna de baixa cardinalidade esperando ganho mágico. Em geral, não funciona para filtros seletivos.
- Ignorar correlação entre colunas. Se a query filtra por dois campos que se relacionam, o otimizador pode subestimar a interseção.
- Tratar todos os valores iguais como igualmente prováveis. Dados reais têm cauda longa, buracos e picos sazonais.
Quando a cardinalidade falha como conceito
Em sistemas distribuídos e data warehouses, estimativas de cardinalidade podem desviar por amostragem por partição. Em bancos que usam columnar storage, a lógica de custo muda e a noção clássica de índice B-tree perde força. Também há limite prático. Se a query depende de valor único em coluna de unicidade natural, a melhor resposta pode ser garantir restrição de unique key e deixar o otimizador usar index unique scan. Se a query opera com text ou json, a cardinalidade real muitas vezes só aparece com função específica de extração e estatísticas dedicadas. Em alguns cenários, manter estatísticas é mais barato que tuning cego. Em outros, reescrever a query ou alterar a ordem de joins resolve mais rápido que ajustar histogramas.

Como verificar e corrigir na prática
No PostgreSQL, execute comandos de análise de tabela para forçar atualização de estatísticas. Use exibir plano com analyze para ver estimativa versus linhas reais. A diferença entre essas duas coisas é o radar de problema. No MySQL, analise a tabela e verifique cardinalidade nas estatísticas de índice. Em tabelas grandes, a amostragem pode ser insuficiente; considere aumentar o valor de amostra se o sistema permitir. No SQL Server, olhe estimativa de linhas versus linhas reais no plano. Se houver desvio grande, considere recompile, atualização de estatísticas ou ajuste de variável de tabela com tabela temporária devidamente indexada.
Em todos os casos, a métrica que importa é o desvio entre estimado e real. Quanto maior o desvio em operações críticas, mais urgente é revisar estatísticas, estrutura de índice e desenho da query.
O que eu recomendo antes de tocar em índice
Primeiro entenda a distribuição dos dados. Depois verifique a idade das estatísticas. Só então decida entre criar, rearranjar ou remover índice. Indexar tudo não resolve estimativa errada. Se você precisa de um ponto de partida rápido, comece verificando cardinalidade das colunas envolvidas no filtro e no join da query problemática. Anote valores distintos e compare com total de linhas. A discrepância geralmente indica onde o otimizador está enganado. A cardinalidade é o Termômetro do plano. O índice é a ferramenta. Se o termômetro marca errado, a ferramenta não ajuda.

Galeria
-
Aula 6 - Cardinalidade -

Edson Gouveia de Brito: Cardinalidade
