O Que É Clusterização
Entendendo clusterização na prática
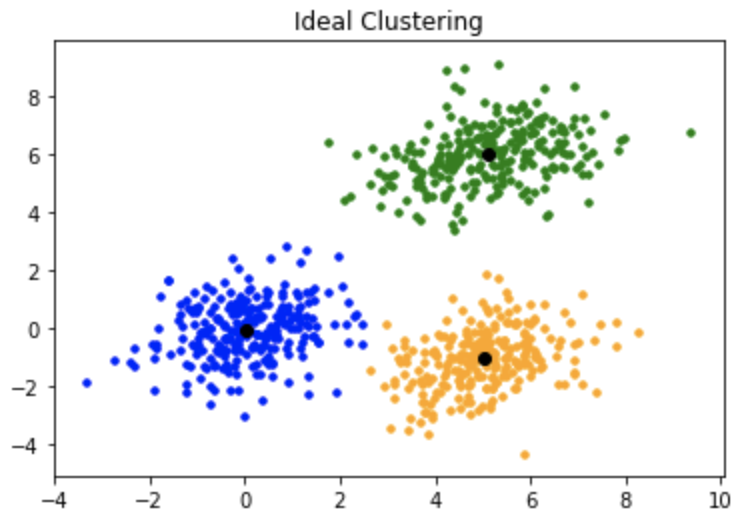
Clusterização é uma técnica de aprendizado não supervisionado que agrupa dados similares sem usar rótulos. O algoritmo analisa características numéricas e separa amostras em grupos baseando-se na proximidade ou similaridade. Você tem um conjunto de dados e quer descobrir padrões estruturais, aí você usa clustering. O jeito mais comum de ver isso funcionando é com o K-Means. Você escolhe um número K, o algoritmo acha centros iniciais aleatórios, atribui cada ponto ao centro mais próximo, recalcula os centros baseado nas médias dos pontos agrupados e repete até convergir. Geralmente leva de 3 a 15 iterações em datasets razoáveis. Funciona rápido para dados compactos e bem separados. Tem outros métodos também. DBSCAN agrupa por densidade e lida melhor com ruído, enquanto clustering hierárquico constrói uma árvore de agrupamentos sem precisar definir K antecipadamente. Cada um tem seu lugar. K-Means é o que aparece em tutoriais porque é simples, mas na vida real não é sempre a melhor escolha.
Em 2019, eu tive um problema específico com dados de comportamento de usuários em um produto SaaS. Tínhamos centenas de variáveis demográficas e de navegação. O K-Means padrão fazia clusters completamente bagunçados porque os dados tinham escalas muito diferentes e alguns features estavam numericamente dominando a distância euclidiana. A solução foi aplicar PCA para reduzir dimensionalidade e normalizar Z-score em todos os features antes de rodar qualquer clustering. Isso cortou o tempo de debug de horas para cerca de 20 minutos e os clusters ficaram semanticamente interpretáveis pela primeira vez.
Métodos que você realmente vai usar
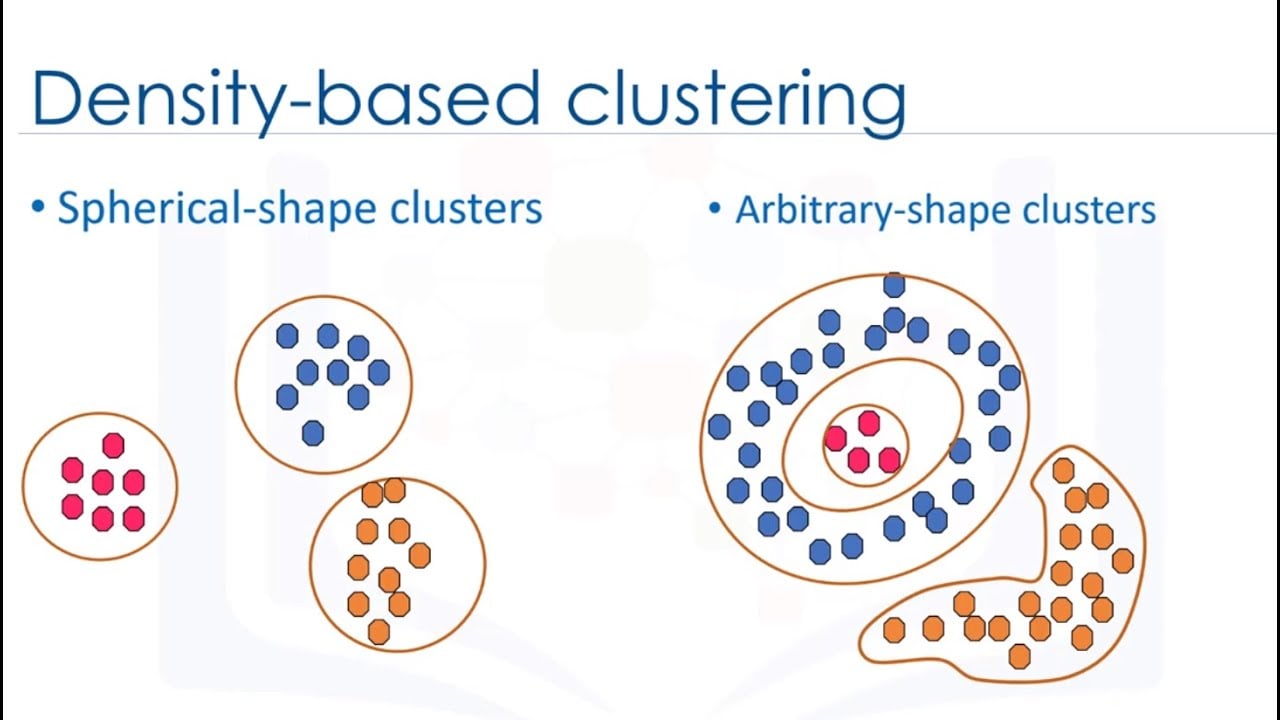
O K-Means é útil quando os clusters são mais ou menos esféricos e de tamanho similar. Se seus dados têm forma irregular, como nuvens alongadas ou aglomerados com densidades diferentes, o K-Means vai falhar silenciosamente e você não vai perceber porque o algoritmo sempre produzirá algo, independente do quão ruim é. DBSCAN resolve parte disso porque não assume forma esférica e identifica outliers como ruído. O problema é que você precisa ajustar dois parâmetros: eps e min_samples. Em datasets grandes com variações de densidade, um único eps não funciona em todo o espaço. Nesse caso, você pode usar o OPTICS, que é uma variação do DBSCAN que preserva a ideia mas lida melhor com densidades variáveis. Clustering hierárquico com dendrogramas é bom para análises exploratórias, mas a complexidade é O(n²) no tempo e O(n²) na memória. Com mais de 50 mil amostras, você basicamente vai travar a máquina ou ter que usar aproximações como o BIRCH. Não subestime isso. Eu já vi engenheiros tentarem rodar hierárquico em datasets de milhões de linhas e perder meio dia esperando algo que simplesmente não ia terminar.

Pegadinhas que ninguém conta
A métrica de silhueta é popular pra escolher o número de clusters, mas ela tende a favorecer clusters compactos e bem separados, o que significa que em dados reais com sobreposição natural entre grupos, a silhueta pode indicar um K artificialmente alto. Testei isso múltiplas vezes e o padrão é sempre o mesmo: a silhueta sobe até um K que parece lógico, mas os clusters resultantes não fazem sentido no domínio do problema. Outro problema que as pessoas ignoram é a sensibilidade inicial do K-Means. Usar k-means++ ajuda bastante, mas não resolve tudo. Se seus dados têm clusters desbalanceados — algo extremamente comum — o algoritmo pode terminar com clusters vazios ou com apenas um ponto. Nesse cenário, um workaround prático é rodar várias vezes com seeds diferentes e pegar a melhor inércia, ou trocar para um método baseado em densidade que não sofra desse viés. Feature selection antes de clusterizar não é opcional. Features irrelevantes adicionam ruído à distância e pioram a qualidade dos clusters. Usar uma técnica de seleção como variance threshold ou mutual information ajuda a filtrar o que não contribui. Digo isso porque passei semanas tentando ajustar hiperparâmetros em um dataset onde 60% das features eram praticamente constantes e não carregavam informação alguma.
Quando clusterização simplesmente não funciona
Se os seus dados não têm estrutura agrupável, nenhum algoritmo vai te salvar. Às vezes o problema é que as variáveis relevantes simplesmente não estão no dataset ou estão codificadas de forma inadequada. Antes de gastar tempo ajustando clustering, verifique se há correlações significativas entre as features e se a dispersão dos dados permite separação. Um teste rápido de validação interna, como validar com diferentes métricas, ajuda a confirmar se a estrutura existe mesmo. Outro caso claro de failure mode é dado sequencial ou temporal puro. Clusterização em séries temporais brutas não faz sentido sem extração de features temporais primeiro. Você precisa transformar a série em características como média móvel, tendência, volatilidade, picos, e só aí aplicar clustering nessas features derivadas. Tentei fazer clustering direto em dados de sensores IoT e o resultado foi essencialmente aleatório. Depois de extrair estatísticas temporais por janela de 30 segundos, os clusters passaram a corresponder a padrões operacionais reais. Se o seu objetivo final é previsão ou classificação, clustering pode ser um passo útil de feature engineering, mas nunca substitui modelos supervisionados. Já vi gente tratar clustering como solução definitiva para problemas que precisavam de classificação, e o resultado era simplesmente pior do que usar um modelo supervisionado direto.
Resumo técnico rápido
O que é clusterização de forma direta: é agrupar dados similares automaticamente usando medidas de proximidade. Escolha o método certo pro formato dos seus dados. Normalize sempre. Valide com mais de uma métrica. E não confie cegamente nos resultados só porque o algoritmo terminou de rodar.

Galeria
-
Qual a sua panelinha? A clusterização pode revolucionar a Tomada de Decisão -

Figura C.1: Funcionamento do framework de clusterização CEBMDC ... -
Clusterização de dados: entenda o conceito e formas de uso - Tera ...

