O Que É Coeficiente De Variação

O que o coeficiente de variação realmente faz por você na prática
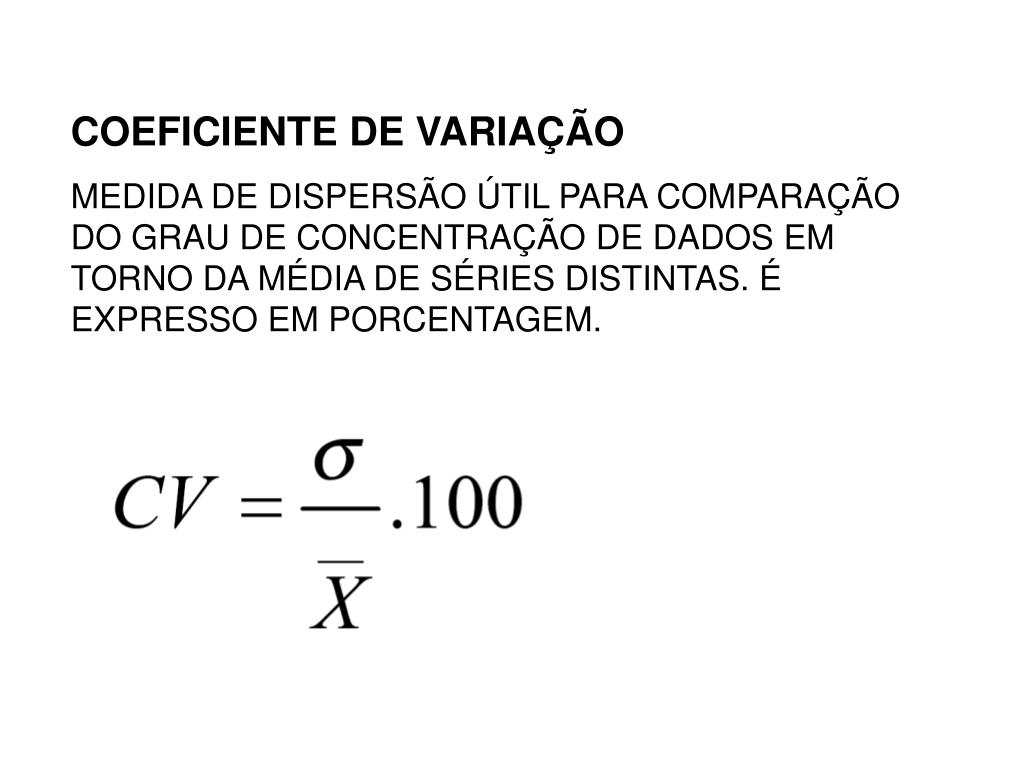
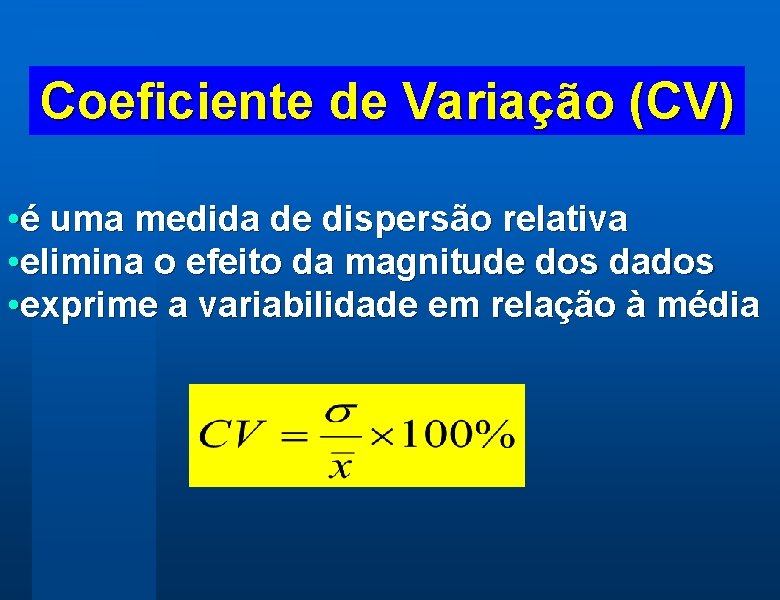
Você está analisando dois lotes de produção ou duas campanhas de marketing e quer saber qual deles é mais estável. A média sozinha não resolve isso. Um lote pode ter média de 100 unidades com dispersão alta, outro lote com média de 50 unidades e dispersão aparentemente menor. A comparação direta falha porque as escalas são diferentes. É exatamente nesse cenário que entra o coeficiente de variação. O coeficiente de variação é uma razão adimensional entre o desvio padrão e a média de um conjunto de dados. Ele expressa a variabilidade relativa, normalizando a dispersão pelo nível da média. A fórmula é simples: CV = (desvio padrão / média) × 100 para obter uma porcentagem. Isso permite comparar a estabilidade de conjuntos diferentes sem que a magnitude dos valores distorça a conclusão. No campo, o cálculo começa com os dados brutos. Você soma todos os valores, divide pela quantidade de observações e obtém a média. Em seguida, subtrai a média de cada ponto, eleva ao quadrado, soma tudo e divide pelo número de observações (para população) ou por n-1 (para amostra). A raiz quadrada do resultado dá o desvio padrão. Aí é só dividir pela média e multiplicar por 100.
O resultado é um número percentual. Quanto menor, mais homogêneo é o conjunto. Quanto maior, mais espalhado e imprevisível.
Quando eu realmente confio nele e quando eu desconfio
O CV funciona bem quando seus dados são positivos, contínuos e medidos em escala de razão. Precificação, tempo de ciclo, volume de produção, rendimento agrícola. Tudo isso se encaixa. O problema é quando as coisas saem desse padrão. Eu tive um caso específico com dados de temperatura corporal de pacientes em um estudo hospitalar. A média ficava em torno de 36,8 graus Celsius, e o desvio padrão era de 0,4. O CV veio em 1,09%. Parecia extremamente baixo, um indicador de estabilidade absurda. O problema era que a escala Celsius não é uma escala de razão verdadeira do ponto de vista fisiológico. O zero não representa ausência de calor. Quando você compara grupos com médias muito próximas de zero, o CV dispara artificialmente e distorce tudo. No final das contas, abandonei o CV para aquele conjunto e usei análise de variância com efeitos fixos, que lida melhor com essa situação. Outro ponto que muita gente ignora: o CV é sensível a outliers de uma forma que o desvio padrão isolado não é tão claramente. Um único valor extremo aumenta o desvio padrão mas pode não alterar tanto a média, o que inflaciona o coeficiente de forma desproporcional. Se seu dado tem cauda grossa, o CV vai mentir para você com cara de precisão.
Pitfalls técnicos que ninguém conta nos tutoriais básicos
O primeiro erro clássico é usar CV quando a média é próxima de zero. Nesse caso, a razão explode. Pequenas flutuações na média geram variações enormes no CV, tornando-o instável e inútil para comparação. Se sua média é próxima de zero, considere transformar os dados ou usar medidas alternativas como a amplitude interquartil normalizada. O segundo erro comum é interpretar o CV como uma probabilidade ou uma regra fixa. Um CV de 15% não significa automaticamente que algo é aceitável ou inaceitável. O limiar depende inteiramente do domínio. Em processos industriais de alta precisão, 10% pode ser katastrofa. Em vendas sazonais, 40% pode ser totalmente normal. Você precisa estabelecer limites baseados no contexto operacional, não copiar números de manuais genéricos. Um detalhe prático importante: se você trabalha com amostras pequenas, digamos menos de 30 observações, o CV tende a subestimar a variabilidade real da população. O desvio padrão amostral é um estimador tendencioso para populações grandes, e a divisão pela média amostral amplifica esse viés. Nesse cenário, o correto é aplicar correções como a de Kendall ou usar bootstrap para construir intervalos de confiança para o CV. Sem isso, você toma decisões baseadas em um número que não reflete a variabilidade verdadeira.
Como calcular de verdade, passo a passo, com um exemplo concreto
Vamos supor que você tenha os seguintes dados de produção diária em duas linhas: Linha A com 120, 130, 125, 135, 140, 115, 128, 132, 127, 142 e Linha B com 80, 90, 85, 95, 100, 78, 88, 92, 83, 105. Para a Linha A, a média é 130,4. O desvio padrão amostral é aproximadamente 8,37. O CV é 8,37 dividido por 130,4 vezes 100, resultando em 6,42%. Para a Linha B, a média é 89,6. O desvio padrão é aproximadamente 9,48. O CV é 9,48 dividido por 89,6 vezes 100, resultando em 10,58%. A conclusão imediata seria que a Linha A é mais estável. Mas note algo importante: a Linha B tem uma média menor e um desvio padrão absoluto maior que a Linha A. O CV corrigiu essa distorção e revelou que, proporcionalmente, a Linha B varia mais em relação à sua própria média. Sem o CV, você poderia ficar com a impressão errada de que as duas linhas são similares porque os desvios padrão absolutos são próximos.
Alternativas e quando trocar de ferramenta
Se seus dados incluem valores negativos, o CV perde completamente o sentido. Saldos bancários, variações de temperatura em escalas arbitrárias, índices com base zero deslocada. Nesses casos, use o coeficiente de dispersão de Pearson ou simplesmente analise os dados com métodos robustos como mediana e MAD (median absolute deviation). Para séries temporais com tendência clara, o CV também engana. Uma série com tendência crescente vai apresentar CV artificialmente alto, mesmo que a variabilidade relativa ao longo do tempo seja constante. Nesse caso, remova a tendência primeiro com diferenciação ou des sazonalização, e só aí calcule o CV sobre os resíduos. Outra alternativa muito útil em análises de risco financeiro é o índice de Sharpe, que é essencialmente um CV ajustado ao retorno livre de risco. Ele compara o prêmio de risco em relação à volatilidade, dando uma medida mais significativa quando o objetivo é avaliar desempenho relativo em carteiras.

Resumo prático para não errar na hora de usar
Calcule sempre a média e o desvio padrão primeiro, verifique se a média é significativamente diferente de zero antes de confiar no CV. Use correções para amostras pequenas. Desconfie de dados com outliers e transforme ou remova antes do cálculo. Estabeleça limites de aceitação baseados no seu domínio, não em padrões genéricos. E se os dados tiverem tendência, remove-a antes de analisar a variabilidade relativa. O coeficiente de variação é uma ferramenta comum, mas subutilizada na maioria dos relatórios que eu vejo. Ela resolve um problema real de forma elegante, desde que você respeite suas limitações. Quando bem aplicado, ele economiza horas de discussão sobre estabilidade de processos porque transforma dispersão absoluta em uma medida comparável. Quando mal aplicado, ele cria falsa sensação de controle. A diferença entre um e outro é saber exatamente o que está fazendo antes de rodar o cálculo.
Galeria
-

PPT - MEDIDAS DE DISPERSÃO PowerPoint Presentation, free download - ID ... -
Aula Introdutria Autoria de Prof Carlos Alberto Caio -

Medidas de dispersión
