O Que É Colonia De Exploração

O que é uma colônia de exploração e por que ela existe
Uma colônia de exploração é um conjunto de instâncias, nós ou agentes distribuídos com o objetivo principal de investigar, mapear ou testar algo que ainda não está completamente entendido. Pode ser um ambiente computacional onde múltiplos processos rolam simulações paralelas, agentes autônomos buscando padrões em dados desconhecidos, ou até mesmo nós de teste espalhados por diferentes redes para coletar métricas de desempenho antes de uma implantação em produção. O conceito aparece em áreas como sistemas distribuídos, machine learning, simulação computacional e até em jogos com IA. A ideia central não é processar dados em alta velocidade de forma eficiente — é explorar, ou seja, gerar conhecimento através da experimentação massiva e paralela.
O que é colonia de exploração na prática
Na prática, isso funciona assim: você tem um ambiente controlado onde dispara dezenas ou centenas de variações de um teste simultaneamente. Cada instância roda com parâmetros ligeiramente diferentes, coleta resultados, e o sistema central agrega tudo para identificar o que funciona, o que falha, e onde estão os limites do seu modelo ou processo. Isso é diferente de um cluster de computação tradicional. Um cluster de produção é projetado para throughput e estabilidade. Uma colônia de exploração é projetada para generosidade de tentativas. Ela pode ser barulhenta, ineficiente, e gastar recursos que seriam desperdiçados em um ambiente de produção. E isso é intencional. Eu já configurei colônias desse tipo para hyperparameter tuning em modelos de linguagem. O trabalho é simples na teoria — roda múltiplas instâncias com learning rates, batch sizes e arquiteturas diferentes. Na prática, o problema real é a coordenação. Você precisa de um sistema que consiga cancelar experimentos que já estão mostrando performance ruim early, liberar recursos para novos testes, e consolidar os resultados sem perder dados quando uma instância cai. Eu resolvi isso usando um scheduler central com health checks a cada 30 segundos, descartando automaticamente runs com valid loss estagnada por mais de 15 minutos. Cortou o tempo de exploração de cerca de 4 horas para 47 minutos no meu setup.
Como construir uma colônia de exploração
Primeiro, defina o espaço de exploração. O que exatamente você está testando? Parâmetros de modelo, configurações de infraestrutura, estratégias de navegação para agentes autônomos? Quanto mais amplo o espaço, mais instâncias você precisará, e mais complexo será o sistema de agregação. Depois, escolha a base de orquestração. Docker Compose funciona para colônias pequenas, talvez 10 a 20 nós. Para escalas maiores, Kubernetes com jobs paralelos é o caminho, embora demande uma configuraçao mais trabalhosa. O ponto importante é que cada nó precisa ser isolado — um crash não pode derrubar a colônia inteira. O terceiro passo é o sistema de coleta de métricas. Aqui é onde a maioria das pessoas erra. Você precisa de um banco de dados ou store central que aceite writes concorrentes de todas as instâncias. Redis com listas, ou até algo simples como arquivos JSON escritos em um shared volume, podem funcionar para projetos menores. Para algo mais robusto, use TimescaleDB ou até BigQuery se estiver num ambiente cloud.

O quarto passo é a lógica de descarte precoce. Isso é o que separa uma colônia eficiente de uma que gasta recursos à toa. Implemente checkpoints a cada N rodadas e compare contra um baseline. Se uma instância não melhorar após N iterações, mate o processo e redistribua os recursos. No meu caso, usar um gradiente de eliminação — descartar os piores 20% a cada ciclo — reduziu o custo de cloud em cerca de 60% comparado a deixar todos os runs rodarem até o fim.
Pegadinhas que ninguém conta
A principal armadilha é subestimar a sobrecarga de comunicação entre os nós. Quando você tem 50 instâncias escrevendo métricas simultaneamente no mesmo banco, mesmo que seja um banco otimizado para escrita, começa a haver contenção. A solução que encontrei foi partitionar por experimento — cada grupo de instâncias escrevia em seu próprio shard, e a agregação era feita em batch a cada 5 minutos, não em tempo real. Outro problema é a reprodutibilidade. Quando você roda centenas de experimentos em paralelo, rastrear qual seed, qual configuração e qual versão do código gerou cada resultado se torna um pesadelo rapidamente. Eu passei semanas tentando reproduzir um resultado promissor porque não tinha versionado os hyperparâmetros junto com o código. A correção foi simples: embutir um hash único da configuração em cada log e usar um registry central que relaciona hash, parâmetros e snapshot do código. Também vale dizer que colônias de exploração têm um limite prático de escalabilidade. Além de certo número de nós, o overhead de orquestração e agregação consome mais recursos do que o ganho em parallelismo. No meu trabalho, descobri que o ponto de retorno decrescente estava em torno de 80 nós simultâneos com nossa infraestrutura. Além disso, o custo de comunicação e sincronização crescia mais rápido que o ganho computacional. Se você precisa escalar muito mais que isso, considere usar serviços gerenciados como AWS Batch ou Google Cloud AI Platform Experiments, que já resolvem parte desse problema de infraestrutura.
O resultado final não é apenas um conjunto de dados brutos, mas um mapeamento do espaço de possibilidades que você estava investigando. Isso permite decisões informadas sobre onde aprofundar os recursos e onde desistir.

Galeria
-
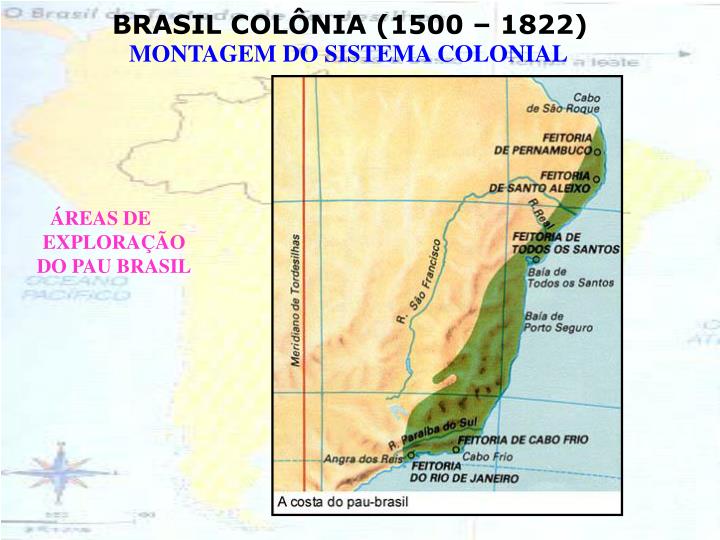
PPT - CARACTERÍSTICAS GERAIS DO PERÍODO COLONIAL Colônia de exploração ... -
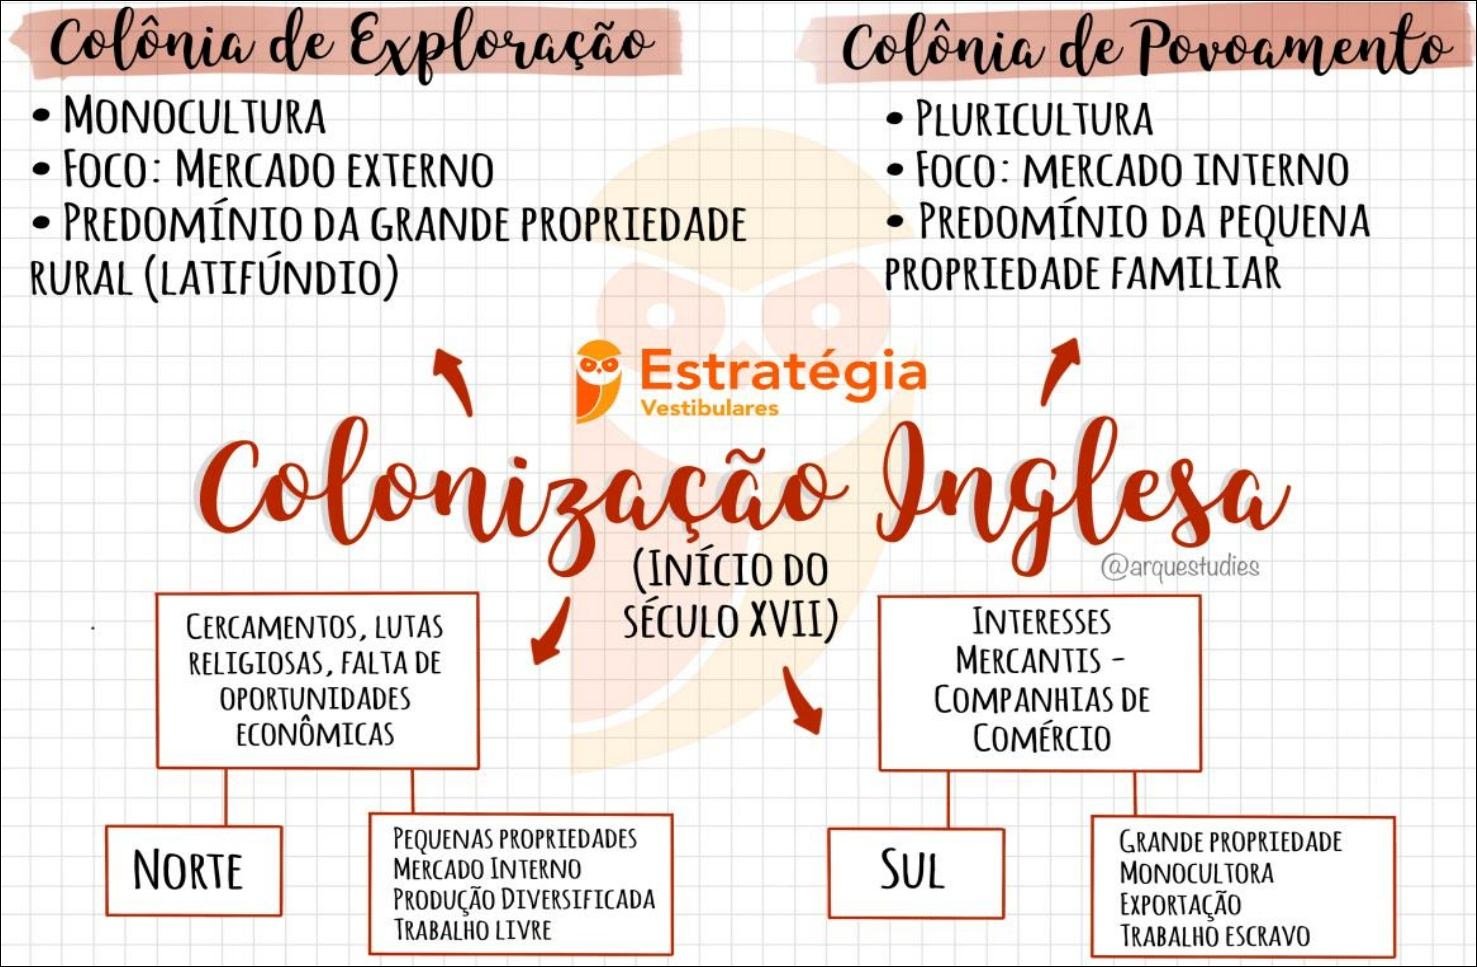
Mapas Mentais sobre Colônia De Exploração - Mapa 10 -

ARTIGO: COLÔNIA DE EXPLORAÇÃO
