O Que É Data Scientist

A realidade do trabalho
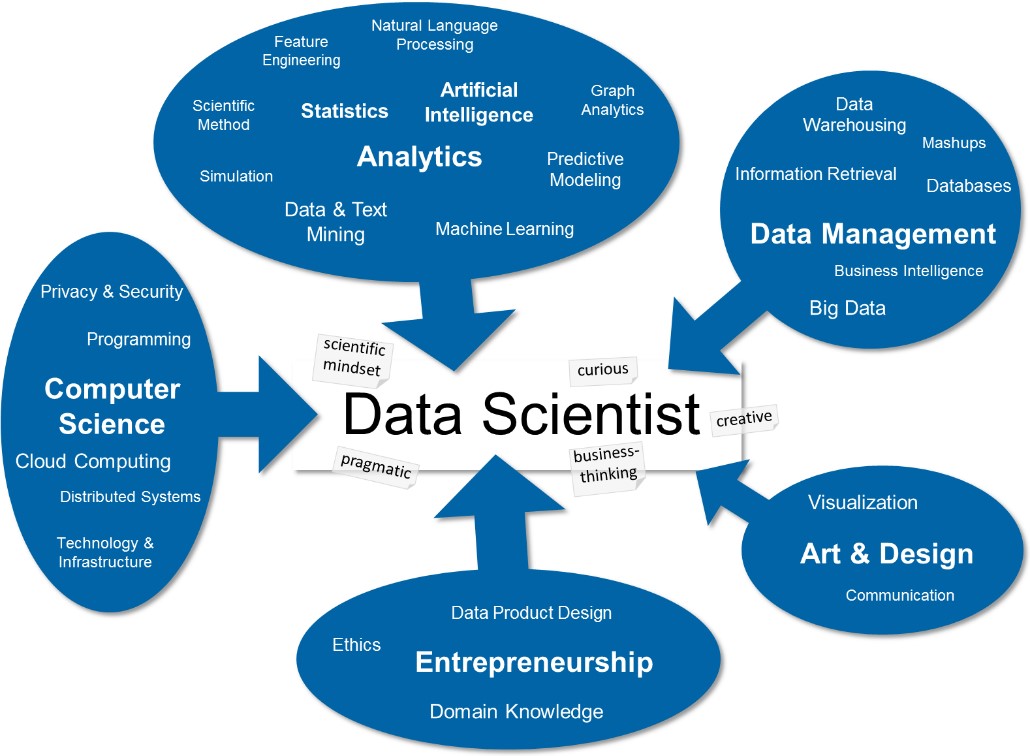
O papel de data scientist existe porque empresas precisam transformar dados brutos em decisões que não sejam chute. A maior parte do tempo é gasto limpando planilhas sujas, negociando com stakeholders que não sabem o que querem, e treinando modelos que vão ser ignorados depois. O título soa glamouroso, mas a rotina diária envolve SQL, Python, e uma quantidade absurda de paciência. A definição superficial costuma misturar estatística, programação e negócios em um único pacote. Na prática, cada empresa define o cargo de forma diferente. Em algumas, você passa o dia inteiro construindo APIs de ML. Em outras, você é um analista de dados com cursos extras no currículo. O que importa é entender o que o trabalho realmente exige antes de entrar nessa área.
o que é data scientist
Data scientist é o profissional que aplica métodos estatísticos, algoritmos de machine learning e análise de dados para extrair informações úteis de conjuntos estruturados e não estruturados. O cerne da profissão não é o modelo em si, mas a capacidade de formular a pergunta certa, coletar os dados adequados, validar as conclusões e comunicar os resultados de forma que pessoas não técnicas consigam agir sobre eles. Muitos iniciantes acreditam que dominar Python e saber treinar uma rede neural já basta. Isso está longe de ser verdade. A habilidade mais subestimada é a engenharia de features — transformar dados brutos em variáveis que realmente ajudam o modelo a generalizar. Sem isso, mesmo o algoritmo mais sofisticado vai falhar miseravelmente. Outro ponto que ninguém explica direito: a maioria dos projetos de data science morre na fase de deploy. Você passa três semanas afinando um modelo com 97% de acurácia, constrói o pipeline inteiro, e na hora de colocar em produção percebe que a infraestrutura da empresa não suporta latência baixa ou que o time de engenharia se recusa a integrar com o seu código por falta de documentação. Esse é o tipo de problema que aparece só depois que você já gastou semanas de trabalho.
O que o dia a dia realmente parece
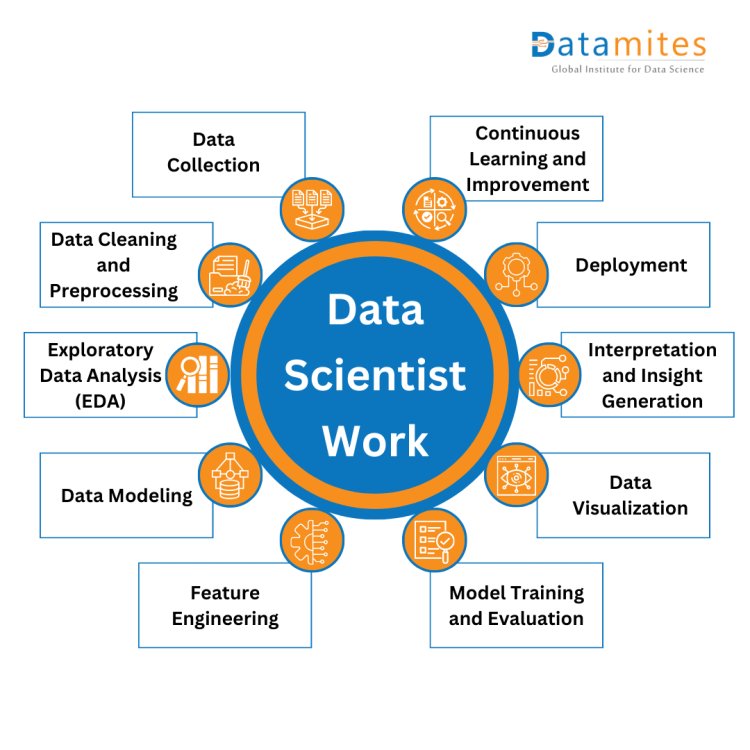
Um ciclo típico começa com uma pergunta de negócio mal formulada. O stakeholder pede "um modelo de churn" sem definir o que considera churn, qual horizonte temporal ou qual custo de falso positivo versus falso negativo é aceitável. O primeiro passo do data scientist é traduzir isso em algo mensurável. Se você pular essa etapa, o modelo vai ser tecnicamente impecável e completamente inútil. Depois vem a exploração dos dados. Análise exploratória não é só rodar um pandas profiling e torcer. É identificar vazamento de dados, distribuições truncadas, valores ausentes que não são aleatórios. Lições aprendidas da forma mais dolorosa possível: dados ausentes raramente são ausentes de verdade. Geralmente significam que o sistema de coleta tem um bug ou que um campo específico é ignorado sistematicamente por um grupo de usuários. Tratar isso comoMissing Completely At Random (MCAR) quando na verdade é Missing Not At Random (MNAR) pode enviesar completamente o resultado. Na fase de modelagem, a armadilha clássica é otimizar a métrica errada. Acurácia é quase sempre uma péssima escolha para datasets desbalanceados. F1-score, ROC-AUC, ou métricas de negócio direto (como receita perdida por falso positivo) são escolhas muito mais honestas. Um modelo que prevê perfeitamente a classe minoritária mas erra 60% da majoritária pode ter alta acurácia geral e ser terrivelmente inútil na prática.
Quando chega a hora de validar, holdout simples não é suficiente se os dados têm dependência temporal ou agrupamento. Splittings aleatórios padrão criam data leakage indireto quando padrões sazonais ou de grupo estão presentes. O workaround que eu uso hoje é temporal split ou group-aware cross-validation, dependendo da estrutura. Em um projeto recente de previsão de demanda, o splitting aleatório tradicional dava 94% de performance em validação cruzada e o modelo caía para 61% em produção. O problema era que os dados de treinamento e validação vinham de períodos sobrepostos com sazonalidade idêntica. Ao mudar para uma validação temporal estrita, a queda foi previsível desde o início e consegui ajustar as expectativas do negócio antes do deploy.
Ferramentas que realmente importam
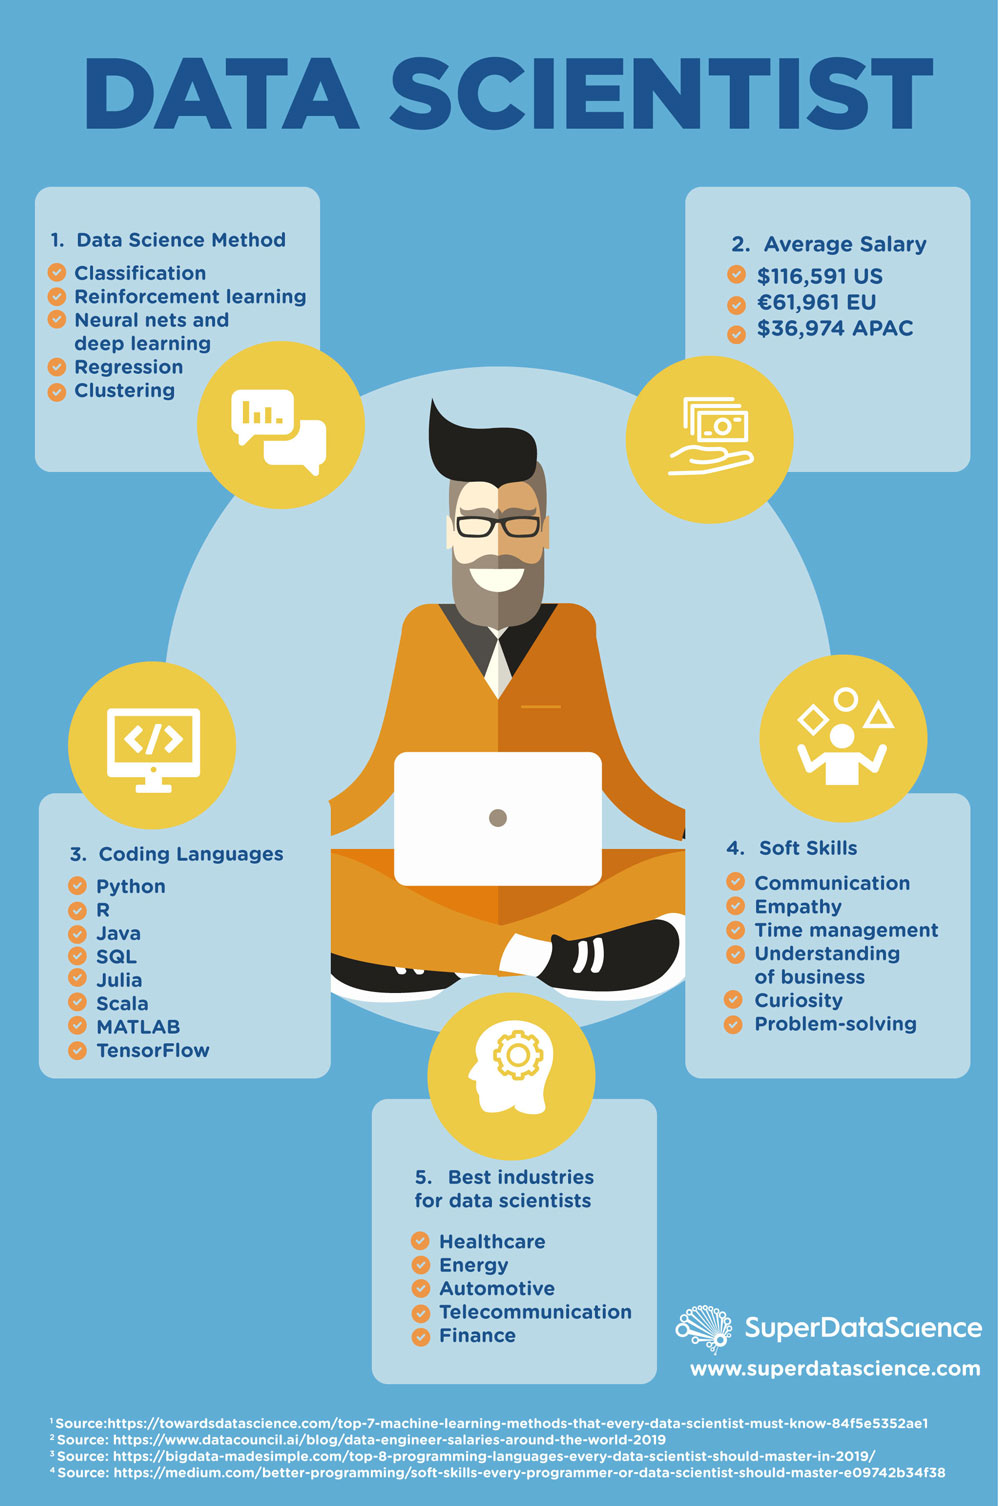
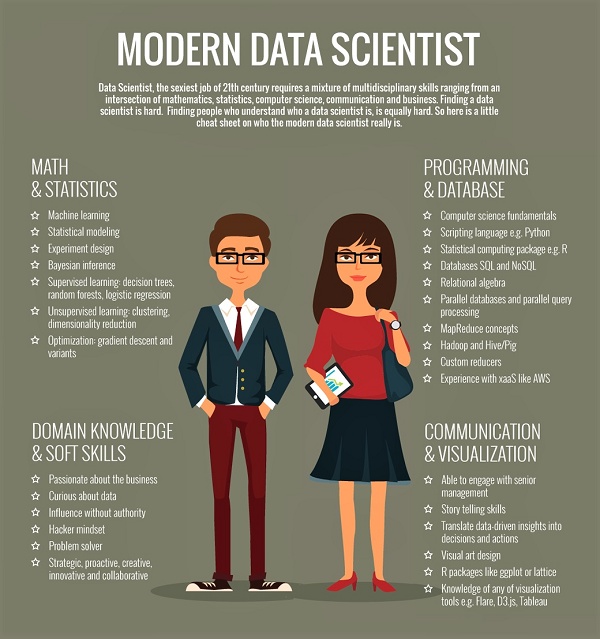
Python domina o mercado.bibliotecas como pandas, scikit-learn, e numpy são obrigatórias. Para modelos mais avançados, PyTorch ou TensorFlow são úteis, mas em muitos cenários empresariais o gradiente boosting do XGBoost ou LightGBM resolve 90% dos problemas com menos dor de cabeça. SQL é não negociável. Se você não consegue escrever queries complexas com CTEs, window functions e joins otimizados, vai depender de outra pessoa para acessar os dados e isso limita drasticamente sua autonomia. Versionamento de código com Git é básico, mas versionamento de dados com DVC ou similar é o diferencial que poucos dominam. Dados mudam, modelos evoluem, e sem rastreabilidade você perde dias tentando reconstruir qual versão de qual dataset gerou qual resultado. Para deploy, FastAPI se tornou o padrão prático para APIs de inferência. Flask ainda funciona, mas FastAPI oferece validação automática com Pydantic, async nativo, e documentação OpenAPI gerada gratuitamente. Containerização com Docker é quase obrigatória hoje em dia, e saber usar containers leves de Alpine ou distroless pode reduzir o tempo de build e o footprint em produção significativamente.
O que ninguém te conta
O salário varia enormemente dependendo da indústria e da localização. No Brasil, um data scientist júnior pode começar entre R$ 4.000 e R$ 8.000, enquanto um sênior com experiência em MLops e negócios pode ultrapassar R$ 20.000 mensais. Nos Estados Unidos, a faixa vai de USD 80.000 a USD 160.000+, com níveis de staff e principal podendo chegar a USD 250.000+. O problema é que essas faixas não refletem a exigência real: o mercado está saturado de candidatos com bootcamp no currículo e vazio de profissionais que realmente sabem entregar valor em produção. A barreira de entrada aparente é baixa. Qualquer um pode fazer um curso online, subir um projeto no GitHub e se candidatar. A barreira real é muito mais alta: saber when not to use machine learning. Muitas vezes, uma regra de negócio simples ou uma query SQL bem escrita resolve o problema com menos manutenção, menor risco e custoZERO de treinamento. Eu vi um time perder duas semanas desenvolvendo um classificador complexo para um problema que era resolvido perfeitamente por uma regra if/else baseada em três campos já disponíveis no banco de dados. A lição é que o melhor modelo é aquele que você não precisa construir. Outra verdade desconfortável: a área está em uma correção de expectativa pós-hype. Em 2017-2020, todo mundo precisava de um data scientist. Hoje, as empresas estão mais interessadas em ML engineers e analytics engineers que conseguem colocar pipeline em produção de forma sustentável. O foco mudou de "construir o modelo mais bonito" para "entregar valor de forma confiável e repetível". Isso não significa que a função desapareceu, mas redefine o que é esperado do profissional.
Caminho prático para entrar na área
Se você está começando do zero, a prioridade deve ser matemática básica aplicada: probabilidade, estatística descritiva, e álgebra linear. Sem isso, você vai copiar código sem entender por que funciona. Depois, domine Python e SQL antes de tocar em frameworks de deep learning. Projects reais valem mais que certificados. Um portfólio com três projetos bem documentados, incluindo o problema de negócio, a abordagem, as limitações e o resultado prático, impressiona mais do que dez cursos completos sem aplicação. Contribuir com projetos open source ou fazer freelancing em plataformas como Upwork ajuda a construir experiência prática com dados de verdade — sujos, incompletos e com prazos apertados. Nada prepara melhor para o mercado real do que lidar com um cliente que não sabe explicar o que precisa e um dataset que faltam 40% das colunas esperadas. A leitura recomendada não é aquela lista genérica de livros famosos. Os livros técnicos são bons, mas o que realmente faz diferença é ler post-mortems de projetos de ML falhados, documentação de engenharia de empresas como Netflix e Uber, e relatórios de erros de produção. O aprendizado mais valioso vem dos casos em que tudo deu errado, não dos tutoriais que mostram o caminho perfeito.
Galeria
-

Anatomy Of A Data Scientist Infographic - #Anatomy #data #Infographic # ... -
What a Successful Data Scientist Needs to Know? -
Chegou a Era do cidadão Data Scientist | Go2web
