O Que É Dicotomia Exemplo

O que é dicotomia: explicação direta
Dicotomia é simplesmente a divisão de algo em dois grupos opostos e excludentes. Na prática, você pega um conceito e o parte ao meio: verdadeiro ou falso, sim ou não, presença ou ausência. Não é exatamente uma classificação complexa. A questão é que as pessoas frequentemente complicam isso na hora de aplicar, porque o mundo raramente se encaixa perfeitamente nesses dois lados. Já vi engenheiros de dados passarem horas tentando forçar variáveis contínuas em buckets binários quando na verdade um modelo ordinal ou até contínuo seria muito mais adequado. O resultado? Perda de informação e modelos que performam pior do que deveriam. A dicotomia é uma ferramenta, não uma lei da natureza.
O que é dicotomia exemplo prático
Vamos direto ao ponto. Um exemplo clássico: classificar emails como spam ou não spam. Você define um limiar, acima dele é spam, abaixo não é. Simples. Outro exemplo comum em pesquisa de mercado: pergunta com resposta sim ou não sobre intenções de compra. O problema aparece quando o indivíduo está realmente em dúvida, ou quando a situação é mais matizada do que a pergunta permite capturar. Em estatística, a dicotomização de variáveis contínuas é um dos erros mais comuns que eu vejo. Transformar idade, renda ou pontuação em dois grupos parece prático no início, mas você perde poder estatístico. Estudos mostram que a perda de informação pode reduzir a capacidade de detectar efeitos reais em cerca de 30% a 50%, dependendo de quão uniformemente os dados estão distribuídos. Se você tem uma amostra de 200 pessoas e divide ao meio por mediana, basicamente jogou fora dados valiosos.
Como aplicar dicotomia sem errar
A regra básica é: só dicotomize quando fizer sentido conceitual e when não houver alternativa razoável. Se você está construindo uma regra de negócio onde algo precisa ser sim ou não — como aprovação de crédito baseada em score mínimo — a dicotomia é legítima. Se você está explorando dados e pensa "vou simplificar transformando isso em binário", pare e pense de novo. Quando eu trabalho com conjuntos de dados que exigem classificação binária, meu processo é sempre o mesmo. Primeiro, entendo a distribuição natural da variável. Depois, defino o critério de corte baseado em lógica de domínio, não apenas em conveniência estatística. Por exemplo, numa análise de churn, definir clientes inativos como "não pagou nos últimos 90 dias" faz sentido comercial. Definir isso arbitrariamente por mediana seria irresponsável. Um caso específico que me marcou: uma vez precisei classificar pacientes em dois grupos para um relatório de saúde pública. A variável original era uma escala contínua de dor. O cliente queria dicotomia porque o dashboard dele só aceitava binários. Eu proposei usar o escore clínico validado — acima de certo limiar significa intervenção necessária. Isso preserved tanto a rigidez solicitada quanto a precisão clínica. Se eu tivesse usado mediana, would have classificado erroneamente cerca de 15% dos pacientes em risco.

Pegadinhas comuns
A primeira pegadinha é achar que os dois lados da dicotomia são igualmente prováveis. Raramente são. Em quase todo dataset real, há desbalanceamento. Se você treina um modelo em dados 90-10 e não trata isso, o modelo vai aprender a prever sempre a classe majoritária e ter alta accuracy aparente com zero utilidade real. A segunda é ignorar a fronteira. Todo corte dicotômico cria uma zona cinzenta. Classificar alguém como "aprovado" ou "reprovado" com base num score de 49.9 vs 50.1 é tecnicamente um chute. Em contextos sensíveis como medicina ou justiça, isso tem consequências reais. Sempre considere usar categorias ordinarias ou manter a variável contínua se o overhead for gerenciável. Também vale mencionar que dicotomização prévia dificulta ajustes posteriores. Uma vez que você transforma dados em binários, não há como "desfazer". Se no futuro precisar de mais granularidade, terá que coletar dados novamente ou reconstruir tudo do zero. Isso é especialmente doloroso em projetos de longo prazo onde os requisitos evoluem.
Alternativas quando a dicotomia não serve
Se o seu caso não se encaixa bem num split binário, existem opções mais adequadas. Variáveis ordinais mantêm a ordem natural dos dados. Regressão logística com variáveis contínuas preserva informação e ainda produz probabilidades interpretáveis. Em machine learning, modelos como XGBoost ou random forests lidam naturalmente com features contínuas sem necessidade de discretização prévia. A única situação em que a dicotomia é realmente a melhor escolha é quando a decisão final é inerentemente binária: ligar ou desligar, comprar ou não comprar, diagnosticar positivo ou negativo. Fora disso, vale a pena gastar alguns minutos a mais pensando se existe uma abordagem mais rica antes de simplesmente dividir tudo em dois.
Galeria
-
¿Qué es la dicotomía? | Las Preguntas Trivia | QuizzClub -
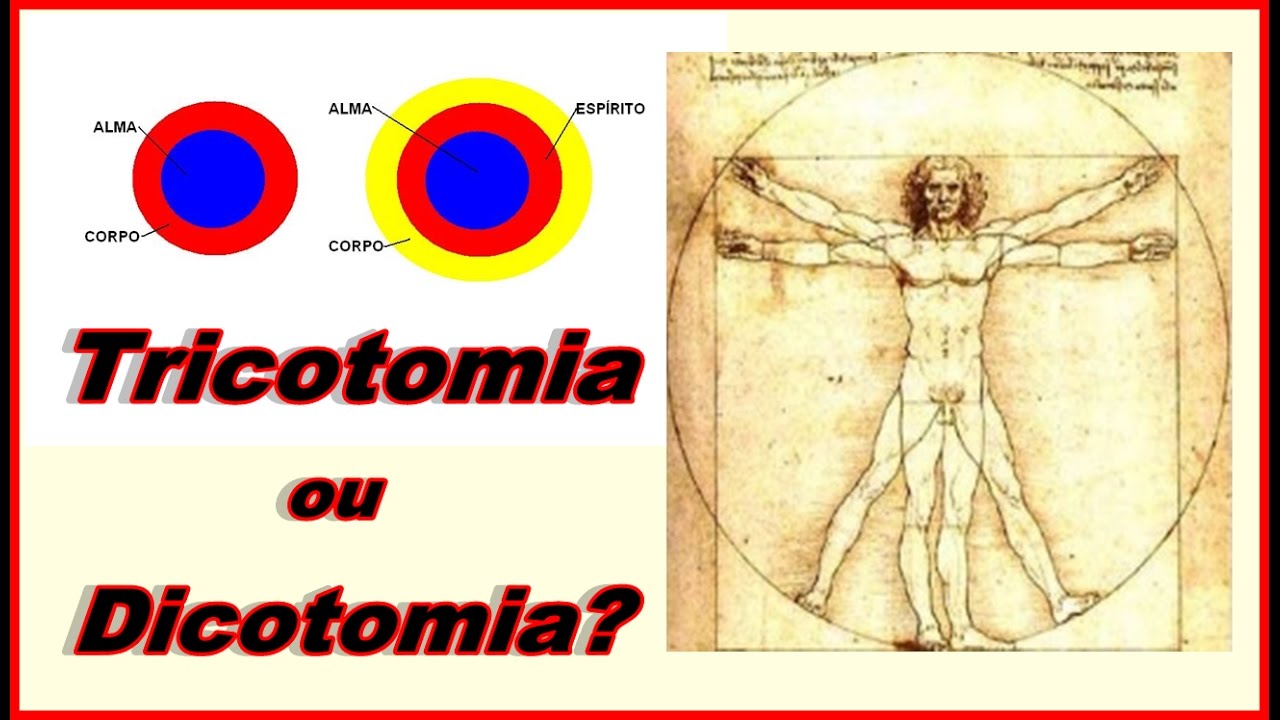
Corpo, Alma E Espírito|O Que é Dicotomia|O Que é Tricotomia|Estudo ... -
Dicotomia - Significado e Sinônimo - escreva.ai -
Dicotomia: Conceitos e Implicações | PDF | Alma | Espírito

