O Que E Disponibilidade
Disponibilidade em sistemas não é o que você pensa
A maioria das pessoas quando ouve falar em disponibilidade imagina algo relacionado a uptime de 99,9% ou aquele monitor verde no dashboard. Mas na prática, o conceito é muito mais chato e menos glamouroso do que parece. Disponibilidade mede basicamente a fração de tempo em que um sistema responde corretamente quando alguém tenta usá-lo. Simples assim. Não tem mágica. O problema é que calcular isso direito exige entender o que conta como indisponibilidade, e aí já começa o primeiro campo minado. Uma requisição que tarda 30 segundos pode ser considerada bem-sucedida tecnicamente, mas do ponto de vista do usuário final, é tão ruim quanto um erro 500. Minha equipe já passou por isso anos atrás com um sistema de pagamentos. Tínhamos 99,95% de disponibilidade medido pelo lado do servidor, mas 40% dos usuários reclamavam que não conseguiam finalizar compras. O gargalo não era o servidor cair, era o timeout da biblioteca de conexão que não estava configurada direito. Quando ajustamos o retry com backoff exponencial e aumentamos o timeout de rede de 5 para 15 segundos, a taxa de sucesso no checkout subiu para 96%. A disponibilidade real medida pelo usuário final era outra completamente diferente da que nosso monitoramento mostrava.
o que e disponibilidade
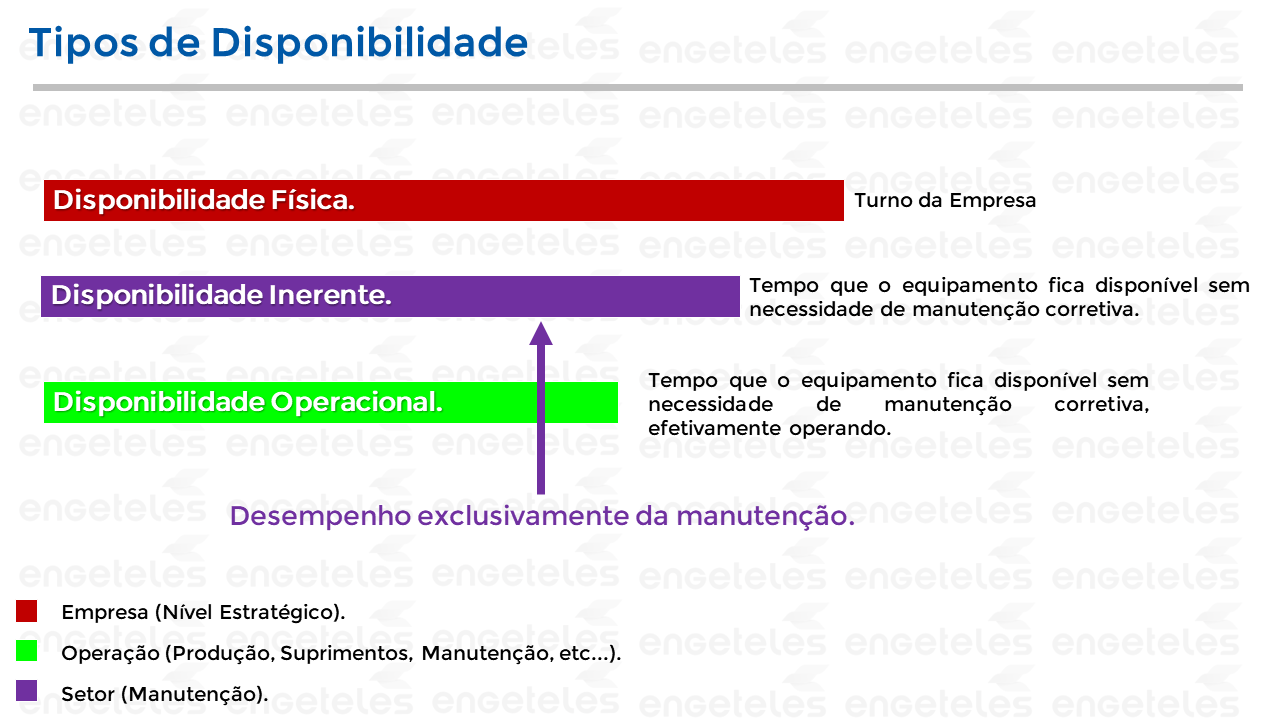
Na prática, disponibilidade é a proporção de tempo em que um serviço está funcional dividido pelo tempo total observado. A fórmula clássica é tempo de operação válida dividido pelo tempo total. Se um sistema fica no ar por 8760 horas num ano e fica indisponível por 8 horas, a disponibilidade é 99,91%. Isso se traduz em aproximadamente uma indisponibilidade de 8 horas por ano, distribuídas em quantas quedas forem necessárias. O cálculo parece simples mas esconde armadilhas perigosas. Primeiro, você precisa definir o que é indisponibilidade. Erros 5xx contam? E requests com latência acima de um threshold? E partes do sistema que caem mas não são críticas para a funcionalidade principal? A resposta padrão do mercado é que sim, tudo conta, mas isso depende do contexto. Um banco online que perde a funcionalidade de extrato mas mantém transferências ativas está disponível em 80% ou 100%? Depende de quem pergunta. Outro ponto que todo mundo erra é confundir disponibilidade com confiabilidade. Disponibilidade é sobre tempo no ar. Confiabilidade é sobre frequência de falhas. Você pode ter um sistema disponível 99,9% mas que cai cinco vezes por dia, ou um sistema que cai uma vez por ano e fica três horas no chão. Os dois têm a mesma disponibilidade mas percepções totalmente diferentes de qualidade. Usuários preferem o segundo caso, mesmo que a porcentagem seja igual.
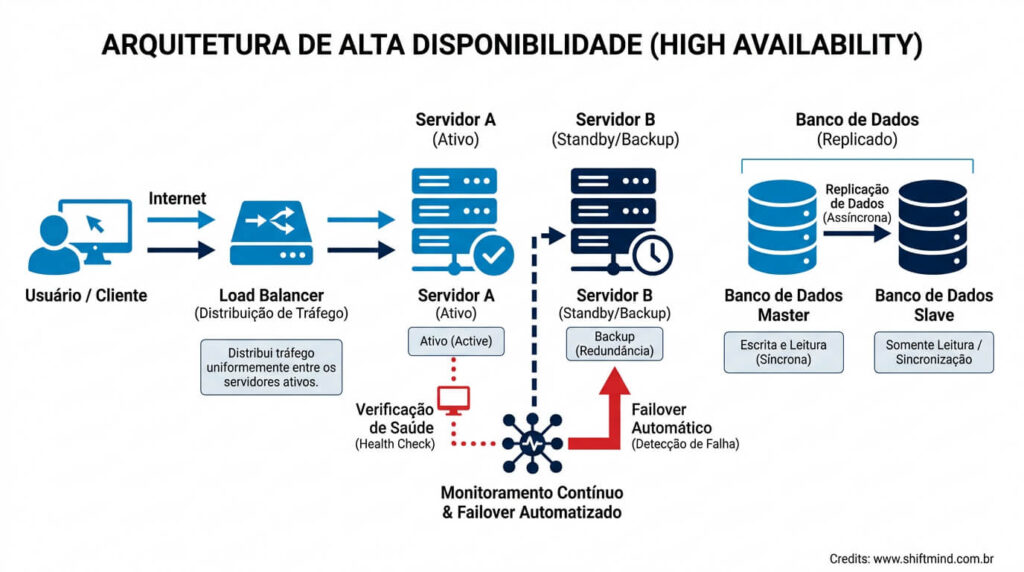
Para garantir disponibilidade mínima, o padrão da indústria usa redundância. Réplicas Ativo-Ativo, onde duas instâncias processam requisições simultaneamente, oferecem a melhor proteção contra falhas de hardware. Mas isso aumenta custo operacional em cerca de 40-60% porque você precisa de load balancer, sincronização de dados em tempo real e monitoramento de lag entre réplicas. Se o orçamento é mais apertado, o modelo Ativo-Standby funciona, mas o failover típico leva entre 30 segundos e 2 minutos, o que já conta como indisponibilidade mensurável nos cálculos. Aqui vai um insight que pouca gente considera: disponibilidade alta pode mascarar problemas de performance que surgem sob carga. Testamos isso numa migração de banco MySQL para PostgreSQL. A disponibilidade caiu de 99,97% para 99,89% porque queries lentas travavam conexões do pool. O sistema estava tecnicamente no ar o tempo todo, mas 15% das requisições levavam mais de 8 segundos para responder. Do ponto de vista do usuário, isso era equivalente a uma queda. Aprendemos a medir disponibilidade com percentis de latência além de apenas status code. Se você está começando agora, comece medindo disponibilidade do lado do cliente, não do servidor. Coloque umHealth Check num endpoint simples que retorne 200 em menos de 200ms a cada 30 segundos. Isso vai te dar uma visão muito mais fiel do que os Dashboards tradicionais de CPU e memória mostram. Ferramentas como Uptime Robot, Pingdom ou até um script caseiro com curl resolvem para projetos pequenos. Para ambientes maiores, Prometheus com alertas de SLI já entrega resultado confiável sem complicação.

Uma limitação importante que precisa ser dita: disponibilidade de 99,99% (quatro noves) exige investimento significante. Custo de infraestrutura sobe para 3x ou 4x o preço de uma instalação única. Se o seu sistema não processa transações financeiras sensíveis ao milissegundo, o ROI de quatro noves quase nunca justifica o gasto. Três noves (99,9%) com boa observabilidade e plano de recuperação documentado entrega experiência muito melhor para a maioria dos casos do que quatro noves mal monitorados. O que ninguém te conta é que a maior parte das quedas de disponibilidade não vem de bugs no código, mas de mudanças mal testadas em infraestrutura. Atualização de certificado SSL que expira, configuração de DNS propagada errado, deploy de nova versão com connection string quebrada. Por isso a disponibilidade máxima que você pode esperar depende tanto dos seus processos de deploy quanto da arquitetura em si. Scripts de rollback automatizado e canary deployment reduzem drasticamente a janela de risco em comparação com deploys manuais. Para projetar disponibilidade desde o início, defina SLA com stakeholders antes de construir. Entender exatamente o que é aceitável vs inaceitável evita otimizações desnecessárias. Um sistema interno de RH que funciona 99,5% das vezes atende muito bem. Um e-commerce que não processa pagamento por 10 minutos por hora de pico já gera perda real de receita. Trave isso como requisito antes de decidir a arquitetura.
A disponibilidade se mede em dinheiro também. Cada minuto de indisponibilidade custa de R$500 a R$50 mil dependendo do negócio. Calcular o custo horário do seu sistema ajuda a priorizar onde investir em redundância. Não adianta ter quatro noves no banco de dados principal se a API gateway continua sendo um single point of failure na mesma jornada do usuário. Quando o sistema finalmente cai, o tempo médio para recuperação (MTTR) importa tanto quanto a taxa de disponibilidade bruta. Equipes com runbooks atualizados e automação de failover recuperam em minutos. Sem preparação, o mesmo problema pode durar horas. Documente procedimentos de emergência e teste regularmente. Isso separa equipes que resolvem rápido daquelas que descobrem o problema pela primeira vez durante o incidente.
Galeria
-

O que é a Disponibilidade e como calcular na manutenção -

O que é Alta Disponibilidade ou High Availability? Entenda! -

ALTA DISPONIBILIDADE: o que é e como você pode alcançá-la -
Os 3 Tipos de Disponibilidade Industrial (Segundo a NBR 5462) - ENGETELES
