O Que É Engenharia De Dados
O que é engenharia de dados na prática
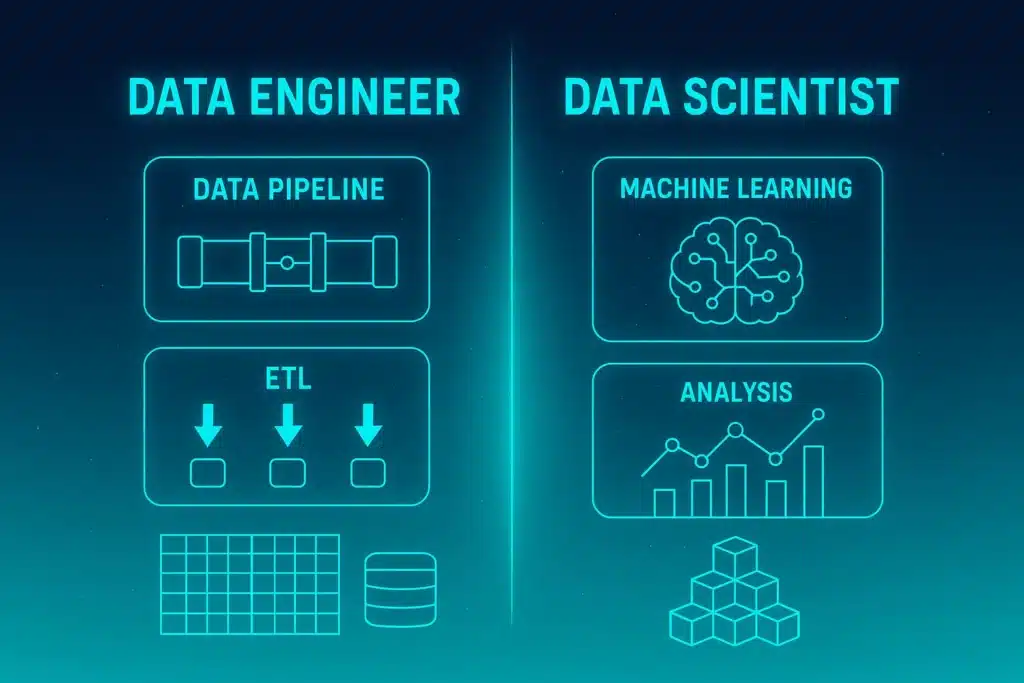
Engenharia de dados é o trabalho de construir e manter a infraestrutura que permite que dados brutos se tornem algo útil para análise, machine learning ou tomada de decisão. Não é mágica. É basicamente extrair dados de várias fontes, limpá-los, transformá-los, carregá-los em um lugar onde possam ser consultados com consistência, e fazer tudo isso de forma automatizada e repetível. A distinção mais comum que as pessoas fazem é entre engenharia de dados e ciência de dados. O cientista de dados quer modelos, previsões, insights. O engenheiro de dados garante que os dados cheguem até ele sem estarem quebrados, duplicados ou com campos ausentes de formas imprevisíveis. As duas funções se sobrepõem, mas não são a mesma coisa.
O que é engenharia de dados: definição técnica
No nível técnico, engenharia de dados envolve pipelines de ETL (extrair, transformar, carregar) ou ELT, orquestração de tarefas, modelagem de dados, governança básica, qualidade de dados e, cada vez mais, pipelines em tempo real com ferramentas como Kafka ou equivalentes cloud-native. O engenheiro escolhe as tecnologias, define o fluxo, monitora falhas e resolve quando algo para de funcionar no meio da noite. Aqui vai um problema real que eu enfrentei há algum tempo. Tivemos um pipeline de extração de dados de uma API de CRM que começava a retornar campos com formatação inconsistentemente. Às vezes o campo "data_criacao" vinha em ISO 8601, às vezes em formato americano (MM/DD/YYYY), e em alguns registros vinha como string nula literal ao invés de null real. O jobs de transformação quebrava silenciosamente porque o schema inferido mudava entre runs. A solução que funcionou foi criar uma camada de validação e padronização no início do pipeline, usando uma library de esquema rígido com fallback para valores default. Também implementei um check de drift de schema que dispara alerta antes do job falhar. Isso reduziu incidentes noturnos de cerca de três por semana para quase zero em dois meses. O que poucas pessoas mencionam ao explicar o que é engenharia de dados é que grande parte do trabalho não é construir o pipeline bonito. É lidar com a realidade de que fontes de dados nunca respeitam contratos. APIs mudam sem aviso. Arquivos CSV vêm com BOM invisível. Bancos legados têm colunas que foram renomeadas mas ninguém atualizou a documentação. O engenheiro de dados gasta muito mais tempo resolvendo esses problemas do que projetando arquiteturas elegantes.
As camadas do trabalho
Na prática, o fluxo se divide em algumas camadas que todo projeto séguero precisa considerar, ainda que de forma simplificada. Extração. Coletar dados das fontes. Pode ser batch (uma vez por dia, por hora) ou streaming (contínuo). Fontes comuns incluem bancos relacionais, APIs REST, arquivos em storage, logs de aplicação, mensageria. Transformação. Aqui é onde a maior parte do valor é criado. Limpeza, deduplicação, enriquecimento, agregação, ajuste de fuso horário, normalização de categorias. Ferramentas variam desde scripts Python simples até frameworks como dbt, Spark ou Airflow com macros.

Armazenamento. Escolher onde os dados transformados vão parar. Data warehouse (BigQuery, Snowflake, Redshift), data lake (S3 com Parquet), ou algo híbrido. A escolha impacta custo e performance de consulta diretamente. Orquestração. Gerenciar dependências entre tarefas, retries, escalonamento. Airflow é o padrão da indústria, mas Prefect, Dagster e até workflows serverless no AWS Step Functions também são usados regularmente. Consumo. Dashboards, modelos de ML, APIs de dados, relatórios. A engenharia de dados termina quando o dado chega pronto para quem vai usar.
Pegadinhas que ninguém conta
Começar um projeto de engenharia de dados com ferramentas complexas é um erro comum. Muita gente instala Spark, configura cluster Kubernetes, orquestra com Airflow num domingo à noite e na segunda-feira descobre que precisava apenas de um script Python rodando no cron com um backup para S3. Complexidade desnecessária custa dinheiro e tempo de manutenção. Você pode começar simples e escalar depois, não o contrário. Outro ponto que gera dor: documentação que não reflete a realidade. Schema registries, catálogos de dados, READMEs atualizados. Eu já vi pipelines inteiros caírem porque alguém mudou o nome de uma coluna em uma tabela fonte e ninguém atualizou o dicionário de dados. Manter documentação viva exige processo, não intenção. Automatize a geração de metadados sempre que possível. Testes de dados também são negligenciados. Um pipeline sem testes de qualidade é uma bomba-relógio. Checar nulidades, valores fora de range, contagem de linhas consistente, referências integrais — tudo isso pode ser implementado com tools como Great Expectations, dbt tests ou checks customizados. O custo de implementar testes básicos é baixo comparado ao custo de descobrir que os dados estão errados depois que alguém já construiu um dashboard com eles.
Ferramentas e escolhas
Não existe ferramenta certa para tudo. A escolha depende do volume, da latência exigida, do orçamento e da maturidade da equipe. Para batch em escala média, o combo Airflow + Python + Postgres ou BigQuery funciona na maioria dos casos. Para streaming, Kafka combinado com Flink ou Spark Streaming é o caminho padrão. Data lakes modernos usam formatos columnares como Parquet ou Delta Lake em storage objeto. dbt se tornou praticamente obrigatório para transformação em data warehouses cloud. Ele troca SQL por um modelo de versionamento, testes embutidos e documentação automática. O aprendizado é razoável para quem já sabe SQL, mas tem limitações: não substitui processamento distribuído pesado e depende da performance do warehouse subjacente. Para equipes menores ou startups, soluções serverless como AWS Glue, Azure Data Factory ou GCP Cloud Composer reduzem a sobrecarga operacional mas aumentam o custo por execução. Em alguns cenários, o custo pode ser 3x a 5x maior que uma solução self-hosted equivalente após 12 meses. Vale a pena calcular isso antes de decidir.

O lado que ninguém mostra
Engenharia de dados é 40% construção, 30% manutenção, 20% investigação de bugs e 10% convencer outras pessoas de que o que você está construindo é útil. Monitoramento é essencial. Alerts bem configurados salvam sono. Você precisa saber quando um pipeline falhou antes que alguém te acorde mandando mensagem no Slack. A cultura de dados também importa. Se a equipe de produto ou análise não entende o que o pipeline faz, vai cobrar prazos irreais e questionar resultados sem contexto. Comunicação clara sobre o que é e o que não é possível entregar faz diferença no dia a dia. O campo está evoluindo rápido. Data meshes, Lakehouses, e ferramentas de auto-orchestration estão mudando o que se espera de um engenheiro de dados. O core permanece o mesmo: transformar dados brutos em algo confiável e acessível. O resto é detalhe técnico que muda a cada dois anos.
Galeria
-
Engenharia de dados: o que é, o que faz e como iniciar na área -

#1 - O que é Engenharia de Dados e por que ela importa? -
Engenharia de Dados na prática — O que realmente importa em 2026

