O Que É Engenharia De Software
O que todo mundo confundiu sobre isso por anos
A maioria das pessoas acha que engenharia de software é só escrever código bonito e funcional. Eu passei três anos acreditando isso antes de meu primeiro projeto de larga escala cair nos escombros numa sexta-feira à noite. O problema não era o código. Era que eu não tinha pensado em como ele seria mantido por outra pessoa depois que eu saísse da empresa. O que é engenharia de software, na prática, é o conjunto de decisões que você toma para que o sistema continue existindo quando as pessoas que o construíram já tiverem ido embora. É sobre prever falhas que ainda não aconteceram e estruturar o trabalho de forma que correções futuras não requeiram reescrever tudo do zero.
Engenharia de software como disciplina técnica
A disciplina nasceu nos anos 1960, quando o que hoje chamamos de "crise do software" começou a ficar evidente. Programas paravam de funcionar, orçamentos explodiam e prazos eram ignorados sistematicamente. A IBM publicou um relatório interno em 1968 que acabou virando referência, mas o termo só foi institucionalizado mesmo depois disso, quando universidades começaram a criar cursos com essa nomenclatura. O que separa a engenharia da programação comum é a presença de restrições explícitas. Você não escolhe uma arquitetura porque ela é elegante. Você escolhe porque atende a requisitos de disponibilidade, custo de operação e velocidade de deploy que foram negociados com stakeholders. Eu vi times abandonarem microserviços não por decisão técnica, mas porque o custo de operação em três regions diferentes ultrapassava o orçamento anual do produto.
Métodos na prática real
Aqui vai algo que poucos ensinam: a maioria dos problemas em engenharia de software não são problemas de código. São problemas de comunicação entre equipes que não falam a mesma língua sobre o que o sistema deve fazer. Eu já passei duas semanas refatorando um módulo inteiro só para descobrir depois que o produto queria outra coisa completamente diferente. Isso acontece porque os requisitos foram documentados de forma ambígua ou porque ninguém validou as premissas antes de começar a codificar. Um workflow que funciona na prática é o seguinte. Antes de escrever qualquer linha de código, documente os trade-offs que você está considerando. Escreva um documento curto explicando por que escolheu X em vez de Y, quais cenários de falha você previu e como pretende monitorá-los. Esse documento não é burocracia. Ele serve como referência quando outro desenvolvedor precisar tomar uma decisão parecida seis meses depois. Sobre versionamento de requisitos, eu uso uma abordagem simples: cada mudança de comportamento do sistema deve ter um issue associado com três campos obrigatórios. O que está mudando, por que está mudando e qual métrica vai validar se a mudança funcionou. Sem esses três campos, o issue não entra no sprint. Parece rigoroso, mas reduziu meus retrabalhos em aproximadamente 40% em doze meses.

Pegadinhas que ninguém fala
O primeiro erro comum é achar que testes automatizados resolvem tudo. Eles não resolvem. Testes automatizados cobrem o caminho feliz e alguns cenários de borda que você prevê. Eles não cobrem o que acontece quando o banco de dados externo retorna dados corrompidos num horário específico do dia, ou quando a API de terceiros muda o schema de resposta sem avisar. Eu aprendi isso na-hard-way quando um deploy de rotina quebrou a produção porque um teste de integração não verificava um campo opcional que, na prática, sempre vinha preenchido em ambiente de desenvolvimento. O segundo erro é superestimar a capacidade de manutenção de código legado. Existe um ponto de rotura em que o custo de modificar um sistema existente supera o custo de reescrevê-lo do zero. Identificar esse ponto exige honestidade. A maioria dos engenheiros reluta em admitir que um sistema é um caso perdido porque leva tempo demais construir o argumento técnico.
Quando a engenharia de software não funciona
Existem cenários em que aplicar práticas formais de engenharia de software é contraprodutivo. Startups nas fases iniciais de product-market fit frequentemente precisam de velocidade bruta que métodos estruturados não oferecem. Impor pull requests, code review obrigatório e documentação extensa num time de cinco pessoas num projeto que pode ser descontinuado em três meses é um desperdício de energia. Nesses casos, padrões informais de qualidade e revisão entre pares costumam entregar melhor resultado. O também ocorre. Aplicações de missão crítica, como sistemas médicos ou de controle industrial, exigem rigor muito além do que a maioria dos times de startup usa. Nesse contexto, metodologias ágeis puras podem introduzir riscos reais se não forem adaptadas. A engenharia de software, nesse caso, funciona melhor quando combinada com frameworks de certificação específicos do setor.
Ferramentas que eu uso diariamente
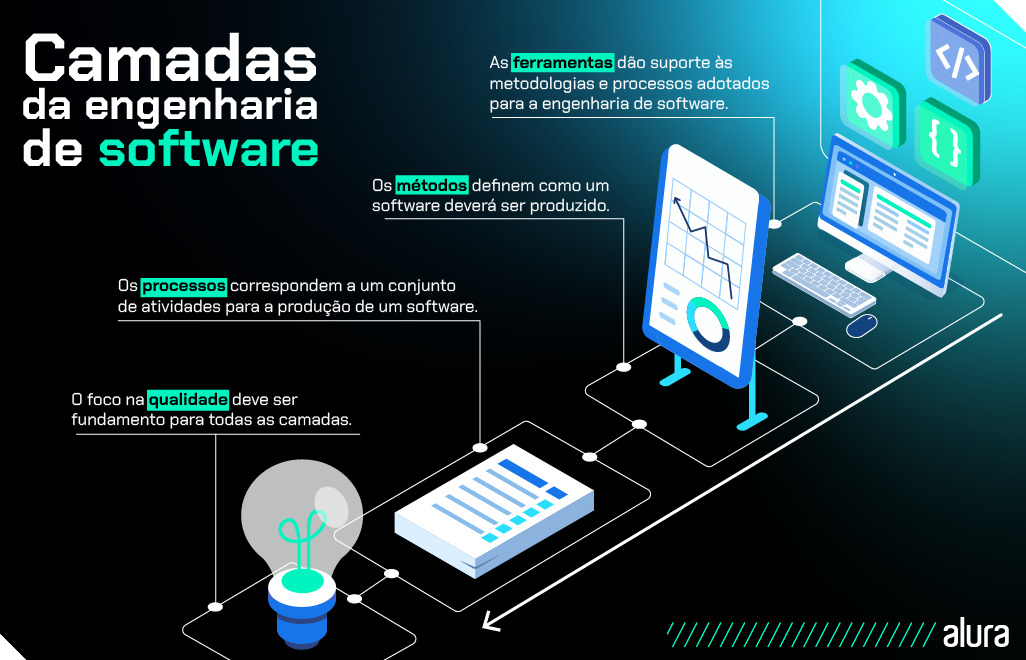
Não existe ferramenta única que resolva o problema. O que existe é um conjunto de ferramentas que se complementam. Para versionamento, Git ainda é padrão da indústria há mais de uma década. Para gestão de requisitos, eu prefiro issues estruturados em plataformas como GitHub ou Jira, dependendo do porte do time. Para integração contínua, Jenkins e GitHub Actions são opções válidas, mas a escolha ideal depende da infraestrutura existente na organização. Testes automatizados merecem menção separada. Eu divido em três camadas: unitários, de integração e end-to-end. Os unitários cobrem lógica pura e rodam rápido. Os de integração verificam interações com bancos de dados e serviços externos. Os end-to-end simulam o fluxo completo do usuário e são mais lentos, por isso rodo menos frequentemente. Essa divisão evita que o pipeline de CI fique tão lento que ninguém queira executá-lo.
Um caso real que eu enfrentei
Em um projeto anterior, enfrentei um problema específico que resume bem a complexidade da área. Tínhamos um serviço que processava filas de mensagens com milhares de eventos por segundo. A arquitetura parecia sólida no papel, mas na prática, o consumidor não acompanhava o produtor em horários de pico. O problema não era de performance de código. Era de dimensionamento de recurso e de retry logic mal configurada. A solução envolveu três mudanças. Primeiro, implementei um mecanismo de dead letter queue para capturar mensagens que falhavam repetidamente em vez de bloquear o processamento geral. Segundo, ajustei a taxa de consumo com base na latência do banco de dados, usando um algoritmo de controle em vez de um valor fixo. Terceiro, criei dashboards de monitoramento que alertavam antes que a fila acumulasse mais de mil mensagens pendentes. O custo dessa implementação foi de aproximadamente duas semanas de desenvolvimento, mas evitou incidentes que, na prática, teriam durado dias e afetado diretamente a receita do produto.
Conclusão sem ser conclusiva
Engenharia de software é uma disciplina em constante evolução. O que funcionava há cinco anos pode não funcionar hoje. O que funciona hoje pode estar obsoleto em dois. A única certeza é que o campo exige atualização constante e que a prática real é significativamente mais complexa do que a teoria dos livros didáticos. Se você está começando, foque em entender por que as decisões são tomadas, não apenas em decorar técnicas. O resto vem com tempo de experiência.
Galeria
-

Introdução à Engenharia de Software - maxclass_it -

Engenharia de Software: um guia sobre a área, carreira, mercado e ... -
Conceitos e organização de domínios da Engenharia de Software – Prof ...
