O Que É Estatística Inferencial
O que fazer quando você não tem dados de toda a população
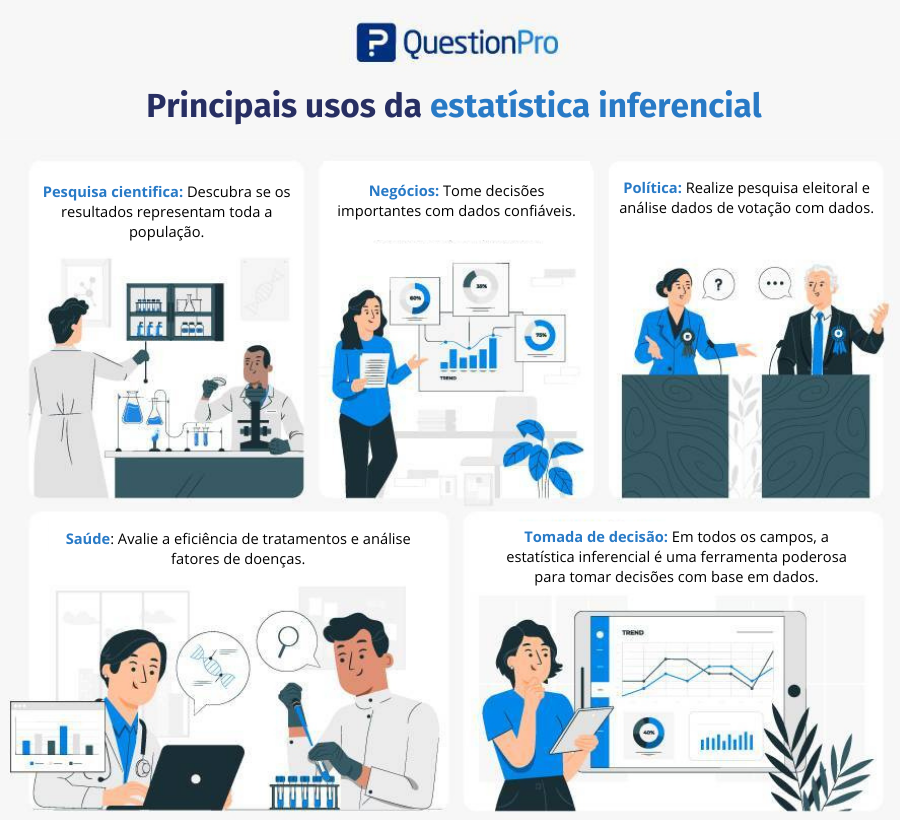
Você coleta amostras. Precisa tirar conclusões sobre o todo. Esse é o dia a dia da estatística inferencial, e entender o que é estatística inferencial de verdade significa aceitar que você está trabalhando com incerteza o tempo todo, não com certezas. A diferença entre descrever o que você tem e tentar generalizar para algo maior é exatamente o que separa a estatística descritiva da inferencial. Nada mais. No papel, o conceito é simples: usar dados de uma amostra para fazer afirmações sobre uma população maior. Na prática, envolve escolher testes, verificar pressupostos, calcular intervalos de confiança e lidar com o fato de que quase nunca você vai saber se sua conclusão está certa ou errada com 100% de certeza. O que você consegue afirmar é probabilístico. Se sua amostra tem 347 respondentes e a proporção observada é 0,62 com IC 95% de 0,57 a 0,67, você está dizendo que o parâmetro populacional provável está naquele intervalo, não que ele está exatamente em 0,62. A ferramenta central aqui é o teste de hipótese, mas ele não existe isolado. Intervalo de confiança, valores-p, poder do teste, tamanho de efeito, correções para múltiplas comparações, robustez a violações de pressupostos. Tudo isso entra no mesmo guarda-chuva. Quando alguém pede para "fazer uma inferência", na realidade você está decidindo qual técnica se encaixa no desenho do seu estudo, qual distribuição assumir e quão conservador quer ser.
Como escolher o caminho certo, antes de abrir o software
A primeira coisa que eu vejo as pessoas errando é pular para o teste sem mapear o desenho. Variable type matters a lot. Variável contínua versus categórica, amostras independentes versus pareadas, tamanho de amostra disponível, presença de outliers, nível de mensuração. Cada combinação aperta um botões diferente no menu de opções. Suponha que você está comparando médias de dois grupos independentes. O caminho óbvio é o teste t de Student, mas só se a normalidade for razoável e as variâncias homogêneas. Se a amostra for pequena, digamos menos de 30 por grupo, e os dados estiverem assimétricos, o teste t pode entregar um valor-p enganoso. Nesse cenário, eu costumo ir para o teste de Mann-Whitney ou usar bootstrap para construir o IC de forma não paramétrica. O bootstrap, aliás, resolve muitos problemas de forma simples: você reamostra com reposição mil vezes, calcula a média em cada reamostra e pega os percentis 2,5 e 97,5. Em vez de depender da distribuição teórica, você deixa os dados falarem. Quando a variável é categórica e você quer ver associação entre duas variáveis, a tabela de contingência e o qui-quadrado de Pearson entram na conversa. Mas cuidado com células com expectativa menor que 5. Nesse caso, o qui-quadrado tende a inflar o estatístico. A correção de Yates ajuda em tabelas 2x2, mas para tabelas maiores eu prefiro o teste exato de Fisher, mesmo que ele demore mais no computação.
Um problema real que eu enfrentei e como resolvi
Recentemente, lidava com um conjunto de dados de satisfação do cliente com escala Likert de 1 a 5, coletado de duas filiais diferentes, com tamanhos desiguais: 812 respondentes na filial A e 203 na filial B. Os dados eram ordinal, não continuos, e a distribuição era fortemente assimétrica, com moda em 4. O instinto seria jogar um teste t ou até ANOVA, mas isso seria incorreto do ponto de vista medida. Eu não fiz isso. Em vez disso, tratei a variável como ordinal, usei o teste de Mann-Whitney para comparação de duas amostras independentes e calculei o intervalo de confiança bootstrap para a diferença de medianas. Para medir o tamanho do efeito, calculei o rank-biserial correlation, que é mais informativo que só o valor-p. O resultado mostrou uma diferença estatisticamente significativa, mas o tamanho do efeito era pequeno, algo em torno de 0,12. Ou seja, havia diferença, mas pouco impacto prático. Sem o rank-biserial, alguém poderia terminar achando que o achado era relevante do ponto de vista de negócio, o que não era o caso.

Erros comuns que custam tempo e credibilidade
O erro mais frequente que eu vejo é confundir significância estatística com significância prática. Um valor-p de 0,03 com tamanho de amostra grande pode ser trivial na vida real. Sempre apresente efeito e IC junto com o valor-p. Outra armadilha é a prática de p-hacking, onde você testa múltiplas hipóteses e variantes de modelo até encontrar algo abaixo de 0,05. Se você faz meia dúzia de testes exploratórios sem correção, a taxa de erro tipo I dispara. A correção de Bonferroni é demais em muitos casos, mas a de Benjamini-Hochberg para controle de false discovery rate costuma ser mais razoável em contextos exploratórios. Outro problema comum é ignorar pressupostos e tratar o teste como uma caixa preta. Robustez varia muito. O teste t é surpreendentemente resistente a violações de normalidade com amostras grandes, graças ao teorema central do limite, mas não confie cegamente nisso em amostras pequenas. Homocedasticidade também importa. Se as variâncias forem muito diferentes, use a versão de Welch do teste t, que ajusta os graus de liberdade e evita falsos positivos.
O que a inferência não resolve e quando abandonar a abordagem
Estatística inferencial depende de amostragem probabilística para generalização válida. Se seus dados vêm de convenience sampling, como respostas online voluntárias, qualquer inferência para uma população maior é problemática. Você pode fazer estimativas descritivas úteis para aquele grupo, mas extrapolar exige cuidado extremo. Amostragem não-probabilística não viola as fórmulas, mas invalida a interpretação populacional dos resultados. Outro cenário em que a inferência clássica falha redondamente é quando a estrutura dos dados viola independência. Dados longitudinais, medidas repetidas, clusters, hierarquias. Nesses casos, usar testes que assumem independência leva a erros padrão subestimados e valores-p artificialmente pequenos. A solução não é forçar um teste tradicional, mas modelar a dependência. Modelos mixtos, GEE, ou pelo menos clustering robusto nos erros padrão resolvem parte do problema. Se você não consegue modelar a estrutura, pelo menos ajuste os erros padrão para o nível agregado correto.
Dicas diretas para quem está começando
Relate sempre tamanho de amostra, método de estimação do IC, teste utilizado, valor-p, tamanho do efeito e pressupostos verificados. Sem essas informações, o resultado não é reproduzível. Comece com simulações simples para entender o comportamento dos testes no seu contexto específico. R ou Python com pacotes como statsmodels e scipy resolvem rapidamente. Para bootstrap, 1.000 a 5.000 reamostras são suficientes na maioria dos casos práticos, o que leva segundos em máquina comum. Se o objetivo é previsão e não generalização, considere que modelos preditivos como regularização ou florestas aleatórias podem ser mais adequados do que testes de hipótese tradicionais. Inferência e predição são objetivos diferentes e exigem ferramentas diferentes. Confundir os dois gera relatórios bonitos que não respondem à pergunta certa. A área também evoluiu bastante com abordagens bayesianas, que entregam distribuições posteriores em vez de valores-p pontuais. Em muitos casos, um intervalo de credibilidade de 95% é mais intuitivo de interpretar do que um IC frequentista, especialmente para tomadores de decisão que não têm formação estatística. A escolha entre frameworks não é apenas técnica, é sobre como você quer comunicar incerteza.

Galeria
-

O Que é Estatística Inferencial - RETOEDU -

O Que é Estatística Inferencial - RETOEDU -

Estatistica Inferencial Vs Descritiva Pesquisa DESCRITIVA: O Que é E
