O Que É Falso Cognatos

O problema das palavras que parecem iguais mas não são
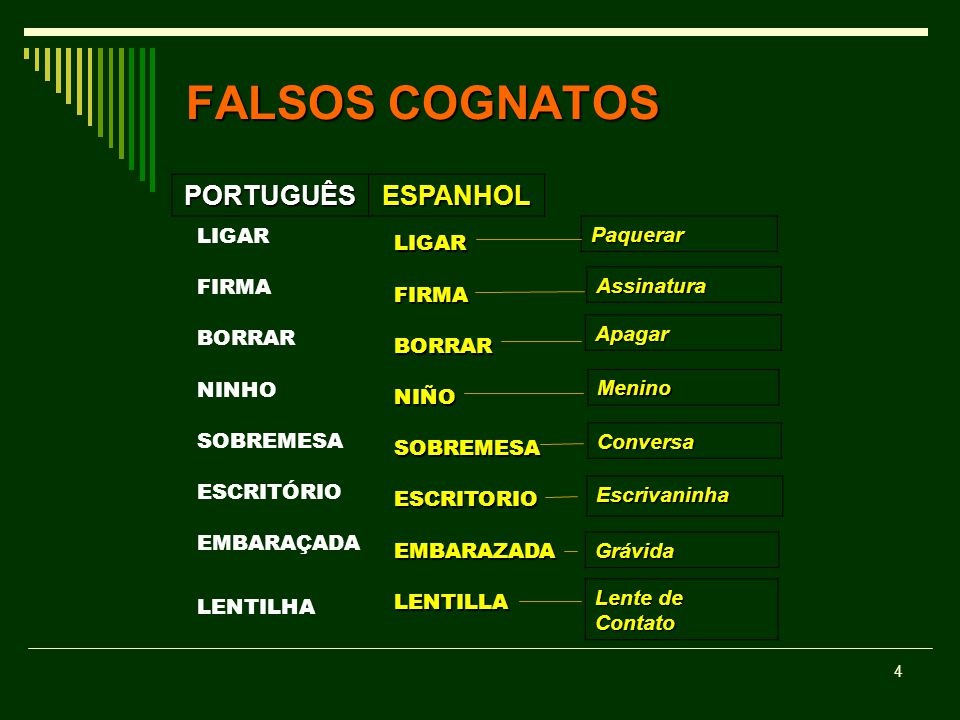
Todo mundo que trabalha com tradução ou aprende línguas românicas tropeça nisso no começo. A palavra existe em duas línguas com a mesma grafia, mas o significado é completamente diferente. Isso é um falso cognato. Não é um cognato verdadeiro porque os dois termos não compartilham etimologia comum relevante, apesar da aparência enganosa. Eu passei anos corrigindo traduções de manuais técnicos e contratos jurídicos, e os falsos cognatos sempre causavam os erros mais caros. Em 2018, traduzi um documento de engenharia do espanhol para o português onde a palavra embarazada aparecia no contexto de uma especificação de transporte. O tradutor automático tinha colocado "embaraçada". O sentido real era "grávida", mas o contexto era sobre embarque de cargas, então a palavra significativa era embarcar — e o termo no original era embarcado, como em "carga embarcada". O erro não estava na tradução em si, mas na suposição automática de que todas as palavras semelhantes eram cognatos válidos. O verdadeiro mecanismo dos falsos cognatos envolve dois processos separados. A maioria das pessoas acha que se trata apenas de palavras parecidas com significados diferentes, mas o problema é mais fundo. Falso cognatos podem ser do tipo ortográficos, onde a grafia é idêntica ou muito próxima, ou do tipo fonológicos, onde a pronúncia se assemelha mas a escrita difere. Há ainda os que chamamos de "semi-cognatos" — palavras que compartilham uma raiz etimológica remota mas desenvolveram sentidos tão distintos que não podem mais ser usadas como equivalências.
Veja esta lista que eu mantenho atualizada para minha equipe: Spanhol-Português: embarazada grávida (não "embaraçada")
exito sucesso (não "excitação") mapache quati (não "mapache"; em algumas regiões brasileiras usa-se para outro animal) pelado careca / sem dinheiro (não "pelado" no sentido de esfolado)

acto ato (grafia diferente, mas pronúncia semelhante ao português "ativo" — cuidado com "acto médico") chuva nona semana de gestação (não confundir com "chuva" em português) Inglês-Português:
actually atualmente / de fato (não "ativamente") conservative conservador (partido político, não "conservacionista") fabric tecido (não "fábrica")
pressure pressão (correto aqui, mas "press" como abreviação de pressure é armadilha) sympathy simpatia (sentimento, não "empatia") assist ajudar (não "assistir" no sentido de ver)
eventually eventualmente (no sentido de "por fim", não "caso ocorra o evento") confused confuso (estado mental, não "comigo fundido" — armadilha para falantes de espanhol que dizem "confundido") Français-Português:
passer passar (tempo / veículo) — OK, este é cognato válido chaude quente (mas "chover" é differente; "chaude" pode causar confusão com "chova") préférence preferência (cognato válido aqui, mas "préfet" prefeito, não "prefeito")
magasin loja (não "magazine" = revista; armadilha clássica) attendre esperar (não "atender"; "attendre" é esperar, "écouter" é atender/ouvir) O que ninguém te conta sobre falsos cognatos é que eles não são distribuídos aleatoriamente. Eles se concentram em áreas específicas do vocabulário. Administração, direito e medicina têm a maior densidade de armadilhas porque são campos onde empréstimos linguísticos ocorreram em períodos históricos diferentes. Uma palavra pode ter entrado no português via latim eclesiástico e no espanhol via árabe, ou vice-versa, criando esse choque semântico.

Meu método de trabalho é simples e funciona há mais de quinze anos. Antes de qualquer tradução, faço uma varredura de palavras que se parecem com a língua-alvo. Uso uma combinação de dicionários etimológicos e listas de falsos cognatos validadas. O Dictionnaire étymologique de l'espagnol e o Dicionário Etimológico da Língua Portuguesa do Cândido Figueiredo são referências básicas. Para inglês, o Oxford Etymological Dictionary resolve a maioria das dúvidas em menos de trinta segundos por palavra. O problema prático é que ferramentas automatizadas de detecção ainda são ruins nisso. O DeepL e o Google Traductor melhoraram muito, mas eles ainda cometem erros sistemáticos com falsos cognatos de alto risco. Eu já vi o Google Tradutor traduzir carpet (tapete, em inglês) como "carpete" e assumir que era a palavra portuguesa quando o contexto era de piso. Em outro caso, sensible foi traduzido como "sensível" num contrato onde significava "perceptível" — diferença que muda completamente a interpretação jurídica. Uma tática que eu adotei e que reduz drasticamente a taxa de erro é a técnica de substituição contextual reversa. Em vez de confiar na tradução direta, eu substituo a palavra suspeita pelo sinônimo mais genérico possível na língua fonte, faço a tradução desse sinônimo, e depois verifico se o sentido se mantém. Se current aparece num texto técnico e eu traduzir como "corrente", faço a pergunta: isso faz sentido no contexto? Às vezes "current" significa "atual" (como em "current version"), e a substituição por "present" revela o equívoco antes dele chegar ao cliente.
A desvantagem deste método é que ele adiciona tempo ao processo. Uma revisão cuidadosa de falsos cognatos em um documento de mil palavras leva entre vinte e cinco e quarenta minutos extras, dependendo da densidade de termos ambíguos. Para textos curtos, isso é aceitável. Para documentos longos como contratos de vinte páginas, o tempo pode dobrar. Minha recomendação prática é usar automação apenas para a primeira varredura e deixar a revisão humana para as palavras identificadas como problemáticas. Outra armadilha que muitos traduzidores encontram é o falso cognato tripartite — uma palavra que parece igual em três línguas mas tem três significados diferentes. O caso clássico é library (inglês) / biblioteca (espanhol e português). Em inglês, "library" pode ser tanto o edifício quanto o software de gerenciamento de livros de uma editora. Em espanhol, "biblioteca" tem o mesmo duplo sentido, mas em português moderno o uso técnico para "biblioteca de funções" em programação é amplamente aceito, enquanto em contextos mais formais ainda se prefere "repositório" ou "coleção". A decisão de qual termo usar depende do registro do texto, não apenas da equivalência literal. Para quem quer consultar falsos cognatos com frequência, existem listas atualizadas pela Associação Brasileira de Tradutores e pelo Instituto Camões que são gratuitas. A lista do Camões, especificamente, organiza os termos por par de línguas e indica o nível de risco de cada um — algo que facilita priorizar quais palavras merecem atenção redobrada durante a tradução.
O ponto mais importante que preciso deixar claro é que falsos cognatos não são um problema que se resolve com leitura passiva. Você pode ler um texto inteiro em espanhol e não perceber que está interpretando mal uma palavra até que alguém aponte o erro. A consciência dos falsos cognatos se constrói com exposição ativa e correção imediata. Leitura passiva cria a ilusão de compreensão. Trabalho ativo com glossários e revisões cruzadas é o que realmente fixa o conhecimento. Se você está começando agora, não tente decorar listas inteiras. Comece com os vinte falsos cognatos mais perigosos do par de línguas que você trabalha. Aprenda a identificar o padrão de cada um. Depois, expanda gradualmente. O cérebro humano é muito bom em detectar padrões quando eles são repetidos em contextos variados, mas lista de cem palavras sem prática de aplicação não leva a lugar nenhum em termos de retenção a longo prazo.

Galeria
-
O Que São Falsos Cognatos | PDF

