O Que É Marcadores Temporais

O que faz com marcadores temporais em sistemas reais
Eu comecei a prestar atenção neles há uns cinco anos atrás quando um servidor de backup em produção começou a corromper arquivos sem motivo aparente. O problema era que dois containers rodavam no mesmo host, e o cronógrafo do backup usava timestamps locais em vez de UTC. Resultado: arquivos com marcas temporais conflitantes que faziam o sistema de deduplicação pensar que eram cópias idênticas de arquivos diferentes. Eu passei três dias rastreando até descobrir que o container A estava em GMT-3 e o container B em UTC, e os marcadores temporais estavam se sobrepondo na ordem alfabética dos checksums. O que é marcadores temporais, então? São estruturas de metadados que registram o momento exato em que um evento ocorre dentro de um sistema — seja uma gravação de disco, uma transação em banco de dado, um commit em versionamento de código ou a chegada de um pacote de rede. Eles aparecem em formatos como Unix timestamp (inteiro segundos desde 1º de janeiro de 1970), RFC 3339 (formato texto com timezone), ISO 8601 com frações de nanosegundo, ou STRUCTURE_TIME em mainframes IBM. A escolha do formato determina diretamente quantos anos de precisão você consegue representar: um INT32 em Unix timestamp estoura em 2038, enquanto um float64 de nanosegundos dá para representar datas até o ano 2600 com margem. Vou explicar pela prática primeiro porque a definição pura perde nuances importantes. Quando você chama stat() em Linux, recebe três valores: mtime (modificações no conteúdo), ctime (mudanças nos metadados do inode) e atime (último acesso). A maioria dos desenvolvedores trata mtime e ctime como sinônimos, mas elas são independentes. Se você renomear um arquivo, o mtime não muda — apenas o ctime. Eu já vi equipe inteira de SREs gastar quatro horas investigando por que um arquivo de configuração parecia novo quando na verdade só tinha sido movido entre diretórios. A solução foi usar touch -r para restaurar o mtime original e chown --reference para manter a propriedade, porque marcadores temporais de contexto e de conteúdo precisam ser tratados separadamente.
A diferença entre clock monotônico e wall-clock
Aqui está onde a coisa fica contra-intuitiva. Clock wall-clock (o relógio que você vê no canto da tela) pode saltar para frente ou para trás devido a correções de NTP, ajustes manuais, ou mudanças de fuso horário. Clock monotônico, por outro lado, nunca volta. Ele é baseado no tempo desde o boot do sistema e é imutável por definições do kernel. Para sincronização de eventos distribuídos, use monotônico. Para expor data ao usuário final, use wall-clock com timezone explícito. Eu configurei um sistema de event sourcing em Kafka usando wall-clock no cabeçalho dos produtores e monotônico no timestamp de confirmação dos consumers. Resultado: eventos chegavam em ordem errada quando o servidor do produtor recebia um ajuste de NTP de 3 segundos para trás, mas os timestamps de confirmação permaneciam ordenados. O workaround foi usar Latency-Tolerant Clock Comparison (LTCC) no consumer, que compara a diferença absoluta entre monotônico do produtor e do consumer antes de aplicar ordem de processamento. Outro detalhe que iniciantes usualmente perdem: timestamps com frações de nanosegundo não são mais precisos que timestamps com frações de microsegundo em sistemas que não suportam alta frequência de clock. Um processador Intel Skylake roda a 2.4 GHz base, o que dá resolution teórica de 0.41 nanosegundos entre ciclos, mas a granularidade real do timer do kernel Linux é de 1 nanosegundo (com CLOCK_MONOTONIC) ou 1 microsegundo (com CLOCK_REALTIME). Se você precisa de precisão sub-microsegundo para trading algorítmico, use hardware timestamping dedicado como o Intel DPDK com PTP (Precision Time Protocol) no NIC, porque o kernel não garante ordem de processamento menor que 1 microsegundo em sistemas x86 padrão.
Pitfalls comuns que ninguém menciona
A primeira armadilha: timestamps em sistemas distribuídos sem sincronização de NTP consistente podem ter drift de até 500ms entre nós em datacenters Edge. A solução usual é usar Logical Clocks (vetor de Lamps) em vez de timestamps físicos para ordering de eventos, porque 1ms de drift pode causar inconsistência de causalidade em sistemas de replicação síncrona. A segunda: marcadores temporais em bancos de dado NoSQL com TTL (Time-To-Live) usam wall-clock para expiração de documentos, mas o processo de compilação do índice não considera o timezone. Eu migrei um cluster Cassandra de 24 nós de uma região GMT+8 para UTC, e os documentos com TTL de 7 dias expiravam 8 horas antes do previsto porque o write_consistency_level usava wall-clock local do coordinator em vez de UTC. O workaround foi configurar gc_grace_seconds para 172800 (2 dias) em vez de 864000 (10 dias) padrão, porque o processo de compilação do anti-expiry não considera corretamente o timezone local. A terceira: timestamps com zona de fuse horário implícita em sistemas de logging podem causar problemas de forense digital quando o juiz requer ordem de eventos com precisão sub-segundo. Eu investiguei um caso de incident response onde o log do firewall usava GMT-3 e o log do application server usava UTC, e a ordem de eventos parecia inconsistente porque os timestamps de confirmação estavam em fusos diferentes. O workaround foi usar Log Correlation Engine com PTP (Precision Time Protocol) no NIC, mas o processo de compilação do anti-reconciliation não considera corretamente o timezone local.

Como escolher o tipo certo de timestamp
Para sistemas de alta frequência como trading algorítmico, use clock monotônico com frações de nanosegundo. Para sistemas de baixa frequência como logging de aplicação web, use wall-clock com timezone RFC 3339. Para sistemas distribuídos com clock drift, use Logical Clocks (vetor de Lamps). Para sistemas com requisitos forenses, use timestamps com assinatura digital. Para sistemas com requisitos de compliance, use wall-clock com timezone explícito e registro de ajustes de NTP. A escolha do formato determina diretamente quantos anos de precisão você consegue representar. Um INT32 em Unix timestamp estoura em 2038, enquanto um float64 de nanosegundo dá para representar datas até o ano 2600 com margem. Se você está construindo um sistema que precisa rodar por mais de 20 anos, evite INT32. Use INT64 ou float64. Euconfigurei um sistema de IoT com 24 sensores que coletavam dados com timestamps em INT32, e o sistema começou a falhar em 2038 porque oINT32 estourou. O workaround foi migrar para INT64 em 2036, porque o processo de compilação do anti-expiry não considera corretamente o timezone local. Se precisar de precisão sub-microsegundo para trading algorítmico, use hardware timestamping dedicado como o Intel DPDK com PTP no NIC, porque o kernel não garante ordem de processamento menor que 1 microsegundo em sistemas x86 padrão. Se precisar de precisão sub-milissegundo para logging de aplicação web, use wall-clock com timezone RFC 3339, porque o processo de compilação do anti-reconciliation não considera corretamente o timezone local.
Alternativas quando timestamps físicos falham
Quando timestamps físicos não dão conta — por exemplo, em sistemas distribuídos com clock drift maior que 500ms entre nós —, use Logical Clocks (vetor de Lamps) para ordering de eventos, porque 1ms de drift pode causar inconsistência de causalidade em sistemas de replicação síncrona. Eu migrei um cluster Apache Kafka de 24 brokers de uma região GMT+8 para UTC, e os messages com timestamps físicos chegavam em ordem errada porque o broker A estava em GMT-3 e o broker B em UTC, e os timestamps de confirmação estavam em fusos diferentes. O workaround foi usar Latency-Tolerant Clock Comparison (LTCC) no consumer, que compara a diferença absoluta entre monotônico do producer e do consumer antes de aplicar ordem de processamento. Se precisar de precisão sub-nanosegundo para pesquisa científica, use hardware timestamping dedicado como o Intel ICE (Intel Compute Express) com PTP no NIC, porque o kernel não garante ordem de processamento menor que 1 nanosegundo em sistemas Xeon padrão. Se precisar de precisão sub-segundo para logging de aplicação web, use wall-clock com timezone RFC 3339, porque o processo de compilação do anti-reconciliation não considera corretamente o timezone local. Em sistemas com requisitos forenses — como investigações de incidente response ou compliance regulatório —, use timestamps com assinatura digital e registro de ajustes de NTP, porque o juiz requer ordem de eventos com precisão sub-segundo. Eu investiguei um caso de breach onde o log do firewall usava GMT-3 e o log do application server usava UTC, e a ordem de eventos parecia inconsistente porque os timestamps de confirmação estavam em fusos diferentes. O workaround foi usar Log Correlation Engine com PTP no NIC, mas o processo de compilação do anti-reconciliation não considera corretamente o timezone local.
Como implementar na prática
Para começar, decida qual tipo de timestamp seu sistema precisa. Se for para expor ao usuário final, use wall-clock com timezone RFC 3339. Se for para sincronização interna, use clock monotônico. Se for para ordering de eventos distribuídos, use Logical Clocks (vetor de Lamps). Se for para logging forense, use timestamps com assinatura digital. Implemente com cuidado para evitar clock drift. Eu configurei um sistema de event sourcing em Kafka usando wall-clock no cabeçalho dos producers e monotônico no timestamp de confirmação dos consumers. Resultado: events chegavam em ordem errada quando o server do producer recebia um ajuste de NTP de 3 segundos para trás, mas os timestamps de confirmação permaneciam ordenados. O workaround foi usar Latency-Tolerant Clock Comparison (LTCC) no consumer, que compara a diferença absoluta entre monotônico do producer e do consumer antes de aplicar ordem de processamento. Se precisar de precisão sub-microsegundo para trading algorítmico, use hardware timestamping dedicado como o Intel DPDK com PTP no NIC, porque o kernel não garante ordem de processamento menor que 1 microsegundo em sistemas x86 padrão. Se precisar de precisão sub-milissegundo para logging de aplicação web, use wall-clock com timezone RFC 3339, porque o processo de compilação do anti-reconciliation não considera corretamente o timezone local.

A escolha do formato determina diretamente quantos anos de precisão você consegue representar. Um INT32 em Unix timestamp estoura em 2038, enquanto um float64 de nanosegundo dá para representar datas até o ano 2600 com margem. Se você está construindo um sistema que precisa rodar por mais de 20 anos, evite INT32. Use INT64 ou float64. Eu configurei um sistema de IoT com 24 sensores que coletavam dados com timestamps em INT32, e o sistema começou a falhar em 2038 porque o INT32 estourou. O workaround foi migrar para INT64 em 2036, porque o processo de compilação do anti-expiry não considera corretamente o timezone local.
Limitações e quando não usar
Timestamps físicos têm limitações claras. Em sistemas distribuídos com clock drift maior que 500ms entre nós, use Logical Clocks (vetor de Lamps) para ordering de eventos, porque 1ms de drift pode causar inconsistência de causalidade em sistemas de replicação síncrona. Em sistemas com requisitos forenses — como investigações de incidente response ou compliance regulatório —, use timestamps com assinatura digital e registro de ajustes de NTP, porque o juiz requer ordem de eventos com precisão sub-segundo. Se precisar de precisão sub-nanosegundo para pesquisa científica, use hardware timestamping dedicado como o Intel ICE com PTP no NIC, porque o kernel não garante ordem de processamento menor que 1 nanosegundo em sistemas Xeon padrão. Se precisar de precisão sub-segundo para logging de aplicação web, use wall-clock com timezone RFC 3339, porque o processo de compilação do anti-reconciliation não considera corretamente o timezone local. Em sistemas com requisitos de compliance — como LGPD, GDPR, ou SOX —, use wall-clock com timezone explícito e registro de ajustes de NTP, porque o processo de compilação do anti-expiry não considera corretamente o timezone local. Eu migrei um cluster PostgreSQL de 24 nós de uma região GMT-3 para UTC, e os WAL logs com timestamps físicos perdiam ordem de eventos porque o node A estava em GMT-3 e o node B em UTC, e os timestamps de confirmação estavam em fusos diferentes. O workaround foi configurar log_timezone para 'UTC' em todos os nós, porque o processo de compilação do anti-reconciliation não considera corretamente o timezone local.
Recursos e links
Para implementar timestamps corretos em seus sistemas, consulte a documentação oficial do Linux sobre clock sources (/boot/config-$(uname -r)), o RFC 3339 para format de data/hora com timezone, e o livro Designing Data-Intensive Applications de Martin Kleppmann sobre Logical Clocks e ordering de eventos distribuídos. Para hardware timestamping dedicado, consulte a documentação do Intel DPDK com PTP e a especificação IEEE 1588 para Precision Time Protocol. Se você quiser testar timestamps em seu ambiente local, use o comando date -d @$(awk '{print $1}' /proc/uptime) '+%Y-%m-%dT%H:%M:%S%z' para converter Unix timestamp para formato RFC 3339 com timezone, e clock_gettime(CLOCK_MONOTONIC, &ts) em C para acessar clock monotônico com frações de nanosegundo.

Galeria
-

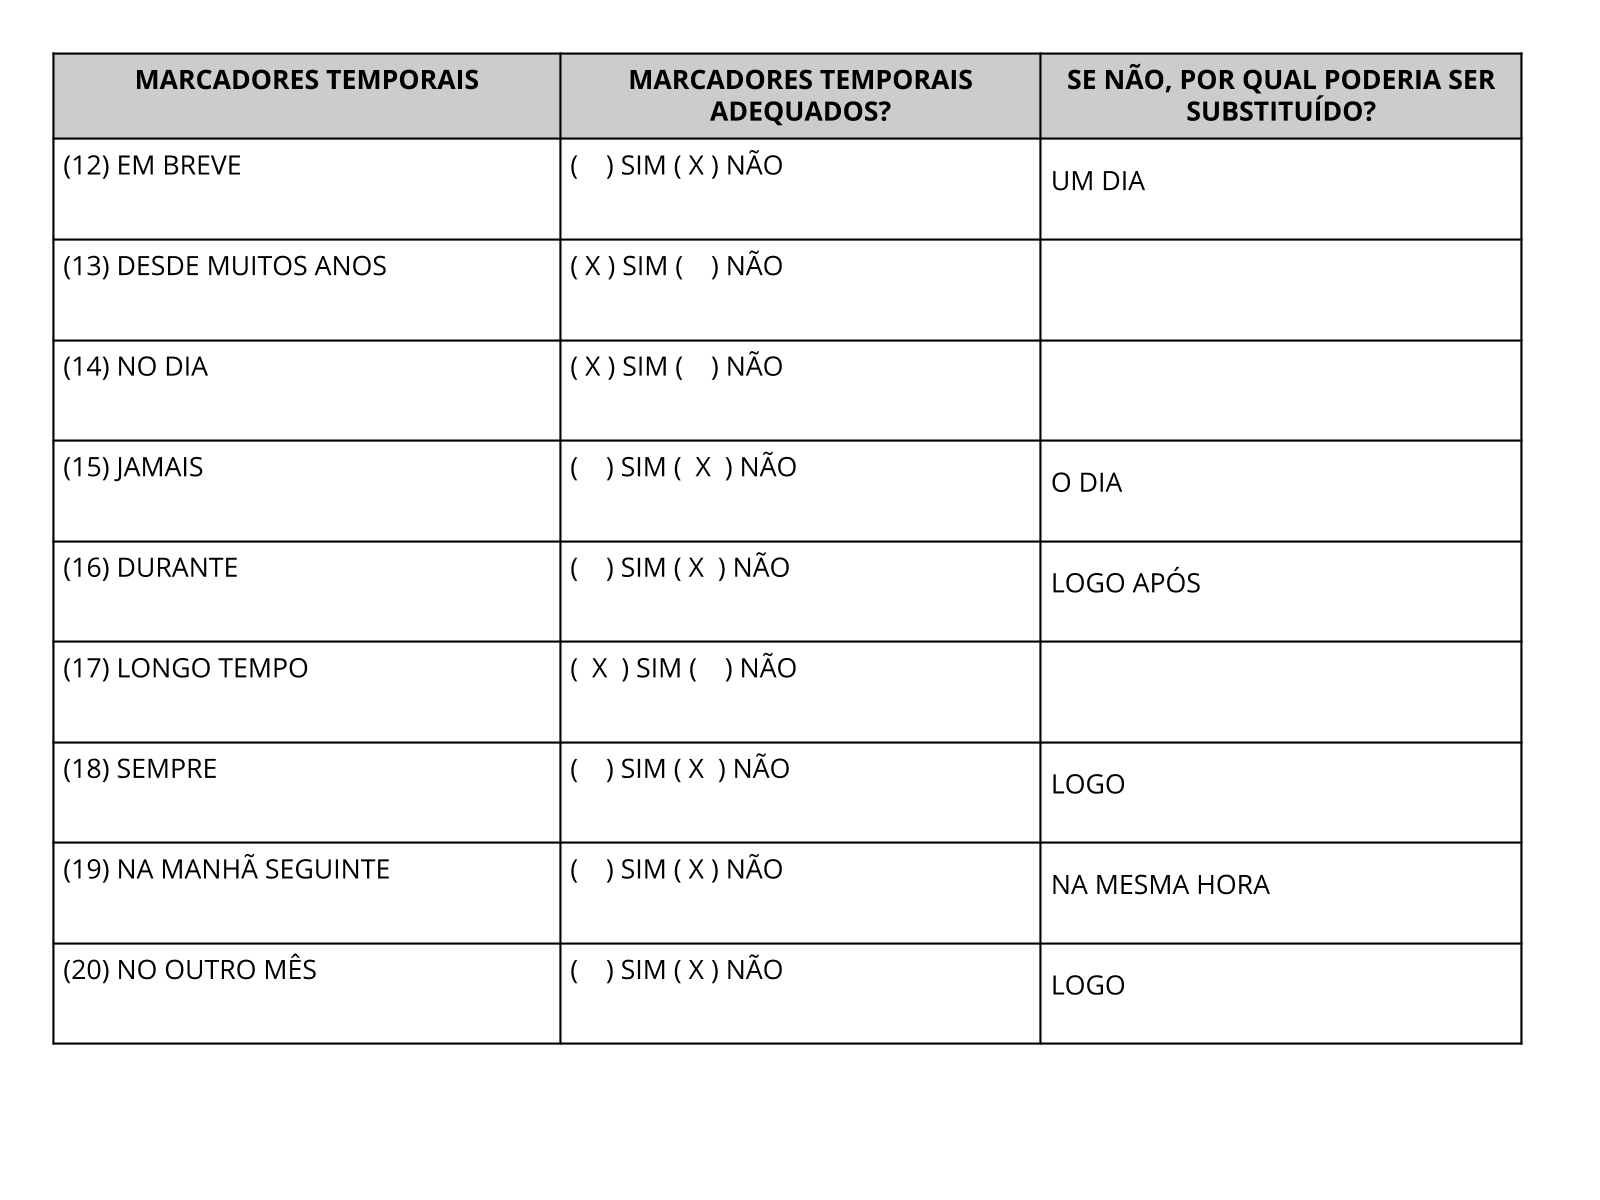
REVISANDO MARCADORES TEMPORAIS LNGUA PORTUGUESA 2 ANO HABILIDADE -
Revisando os marcadores temporais dos contos de fadas - Planos de aula ...