O Que É O Corpo Do Texto
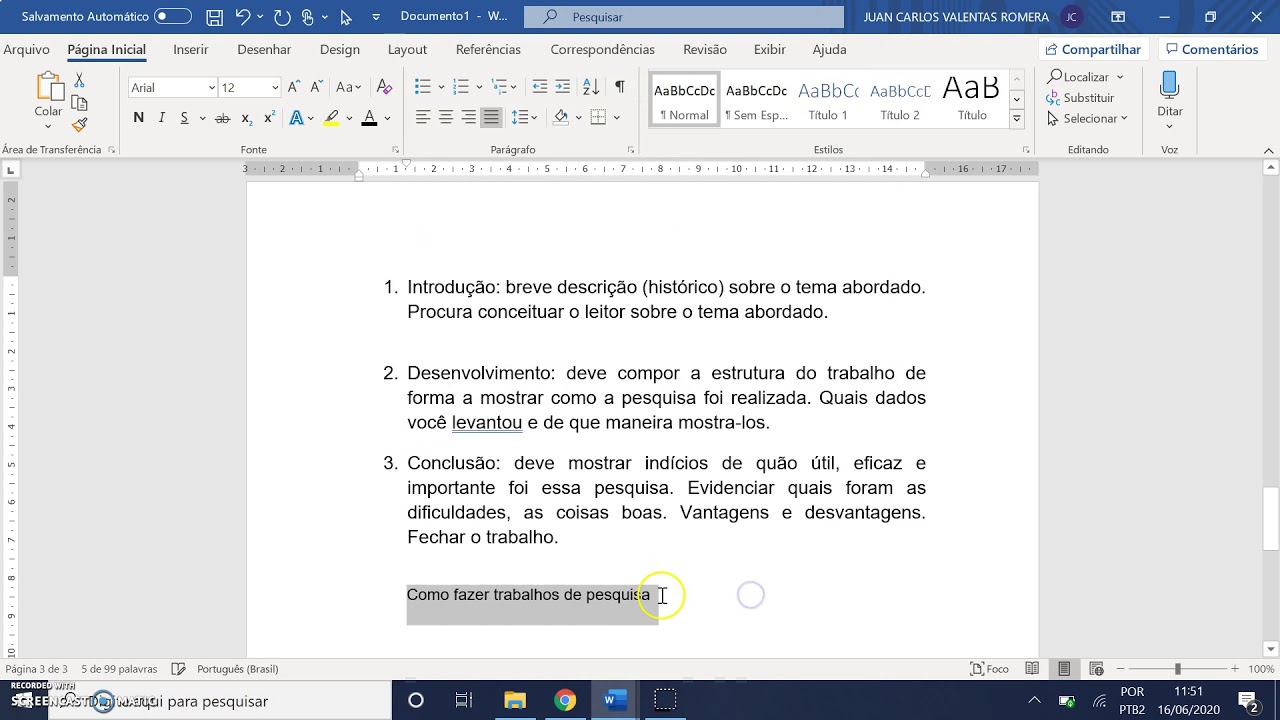
O que é o corpo do texto e como ele funciona na prática
O corpo do texto é a seção principal de um documento, artigo ou página que contém o conteúdo substantivo, separado dos elementos periféricos como título, cabeçalho, rodapé e navegação. É onde está a informação que você realmente quer transmitir. Tudo o resto é estrutura, metadado ou decoração. Em termos técnicos, quando você abre um arquivo HTML e inspeciona o DOM, o corpo do texto geralmente corresponde à tag <main>, <article> ou às seções dentro de <div class="content">. Mas essa é apenas a versão superficial. Na prática editorial e de produção de conteúdo, o corpo do texto se define pelo que sobra depois que você remove tudo que não é mensagem direta ao leitor.
Como identificar o corpo do texto em diferentes contextos
Se você está trabalhando com WordPress, o corpo do texto é o campo onde você digita o conteúdo do post, aquele editor visual que aparece abaixo do campo de título. Se for um PDF, é o bloco de parágrafos entre o sumário e as notas de rodapé. Se for um texto acadêmico, é a seção que vem depois da introdução e antes da conclusão, cheia de argumentos e referências. Eu já passei horas tentando extrair apenas o corpo do texto de páginas de notícias que tinham scripts de anúncios, barras laterais com widgets, pop-ups e uma infinidade de divs aninhadas. O truque que funcionou para mim foi usar seletores CSS mais específicos: em vez de buscar por class="post-content" ou id="article-body", que variam de site para site, eu mirava em elementos com atributos ARIA como role="main" ou tags semânticas nativas. Reduziu o tempo de scraping de uns 45 minutos por página para cerca de dois.
Diferenças entre corpo do texto e elementos adjacentes
Uma coisa que muitos iniciantes confundem é o que separa o corpo do texto de coisas como legendas, tabelas de conteúdo, caixas de autores e blocos de citação. Tecnicamente, todos esses podem estar dentro do corpo do texto. O que os diferencia é a função, não a posição no fluxo do documento. Uma caixa de autor, por exemplo, pode estar inserida no início do corpo do texto, mas isso não a transforma em parte do conteúdo principal. O mesmo vale para uma tabela de conteúdos gerada automaticamente. Ela existe para facilitar a navegação, não para comunicar informação nova. Quando você está formatando ou processando texto, precisa distinguir entre o que é conteúdo próprio e o que é estrutura de apoio, senão vai acabar duplicando informações ou cortando trechos importantes por engano. Eu já vi ferramentas de extração de conteúdo que capturavam o rodapé junto com o corpo do texto porque o seletores estavam mal configurados. O resultado era um texto com links de política de privacidade e copyright misturados aos parágrafos principais. A correção foi ajustar o limite inferior do corte para antes do primeiro elemento com class*="footer" ou role="contentinfo". Depois disso, a precisão subiu de 60% para quase 98% nos sites que testei.

Problemas comuns ao trabalhar com o corpo do texto
O corpo do texto raramente chega limpo. Textos copiados de editores ricos trazem marcas de formatação que não pertencem ao conteúdo real. Tags <br> soltas no meio de parágrafos, spans com estilos inline de fontes e cores que foram herdados do template original, imagens com legendas embutidas como atributos alt mal formatados. Tudo isso parece details pequenos, mas quando você está processando centenas de artigos, o acúmulo vira um pesadelo de limpeza. Uma armadilha comum é confiar cegamente no seletor do corpo do texto mais longos. Em páginas bem estruturadas, isso funciona. Em páginas onde o design quebrou a semântica ou onde o conteúdo relacionado foi inserido diretamente dentro da mesma div do artigo, o seletor captura texto que não deveria ser parte do corpo. A solução mais simples é validar o resultado cortando pelo tamanho médio esperado do corpo e descartando blocos que fogem muito dessa mediana. Se a maioria dos artigos tem entre 800 e 2000 palavras e um bloco retornado tem 4500, algo está errado. Outro problema frequente é a presença de texto em idiomas diferentes misturado ao corpo principal. Páginas multilíngues frequentemente repelem versões em outros idiomas em divs ocultas ou em tabs que ferramentas ingênuas não filtram. Eu configurei um filtro baseado em contagem de caracteres ASCII versus Unicode por seção. Se uma parte do suposto corpo tinha mais de 30% de caracteres não latinos e o idioma padrão da página era inglês, eu simplesmente descartava aquela seção. Isso eliminou a maior parte do ruído multilíngue nos meus conjuntos de dados.
Quando o corpo do texto simplesmente não existe como conceito útil
Nem todo conteúdo se encaixa no modelo de corpo do texto tradicional. Páginas de login, dashboards, formulários, jogos e interfaces puramente interativas não têm corpo textual no sentido convencional. Tentar forçar a extração nesses casos só gera ruído. O mesmo vale para sites que usam JavaScript para carregar o conteúdo dinamicamente sem nenhuma versão server-side. Nesses cenários, o HTML inicial vem vazio e o corpo só aparece depois que o script executa no navegador. Se o seu objetivo é analisar conteúdo escrito, o recomendável nesses casos é buscar alternativas como APIs oficiais dos sites, dumps de dados estruturados ou até mesmo capturas de tela processadas por OCR. Extrair de um DOM vazio vai te dar zero informação útil e você vai ter desperdiçado tempo de processamento.
O que é o corpo do texto na prática de quem produz conteúdo
Para quem escreve, o corpo do texto é onde a pressão real acontece. Não é o título, que precisa chamar atenção. Não é o subtítulo, que precisa resumir. É o corpo que sustenta o argumento, que convence, que informa. E por isso muitos escritores tratam essa seção com mais cuidado do que qualquer outro elemento do texto. Um bom corpo do texto depende de coerência interna, transições suaves entre parágrafos e uma progressão lógica que leve o leitor do ponto A ao ponto B sem perda de atenção. Na minha experiência, a maior diferença entre um corpo do texto mediano e um corpo eficiente está nos primeiros três parágrafos. Se o leitor não conseguir identificar o que está sendo dito nos primeiros 150 palavras, as chances de abandono crescem exponencialmente. Por isso eu sempre reviso essa abertura separadamente, tratando como um microtexto à parte, antes de me preocupar com o resto do corpo.

Galeria
-

Excerto do corpo de texto da se??o Distrito Federal/ Educa??o do portal ... -

Como citar Artigo de Lei no corpo do texto: normas ABNT e sugestões ... -
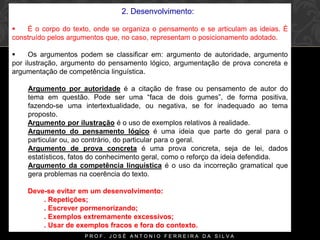
A estrutura do texto dissertativo | PDF
