O Que É Parcialidade

O que é parcialidade — e por que ela aparece mesmo quando você não quer
Parcialidade é a tendência de um sistema, modelo ou avaliação favorecer sistematicamente certos resultados em detrimento de outros, de forma previsível e enviesada. Não se trata de um erro aleatório. Ela aparece porque os dados de treinamento, a metodologia de coleta ou os critérios de mensuração já carregam uma assimetria estrutural. A diferença entre viés estatístico e parcialidade é que o primeiro pode ser quantificado com uma fórmula, enquanto o segundo frequentemente se esconde em escolhas que parecem inócuas no início do projeto. Quando falamos de parcialidade em machine learning, análise estatística ou até em revisão de processos de negócio, estamos falando de um comportamento repetível onde um subconjunto de dados ou indivíduos recebe tratamento diferenciado pelo sistema. Isso pode ser tão simples quanto um classificador que aprende a associar determinada região geográfica a menor probabilidade de aprovação de crédito, ou tão complexo quanto um modelo de linguagem que reproduz estereótipos porque os textos da internet refletem desigualdades históricas. A parte que as pessoas não antecipam é que parcialidade não precisa vir dos dados brutos. Ela pode surgir da forma como você define a variável alvo. Eu passei cerca de três semanas tentando entender por que um modelo de scoring de risco que parecia tecnicamente impecável rejeitava sistematicamente candidatos de bairros periféricos. O problema não estava nas features. Estava no fato de que a variável alvo era "inadimplência histórica", que carrega décadas de exclusão creditícia estrutural. Corrigir isso exigiu substituir a abordagem de previsão direta por um modelo com ponderação por grupo demográfico e validação cruzada estratificada. O tempo de desenvolvimento aumentou em cerca de 40%, mas a taxa de falsas rejeições caiu de 18% para 3%.
Existem métricas que tentam capturar isso. Demographic parity, equal opportunity, equalized odds. O problema prático é que elas frequentemente conflitam entre si. Você não consegue maximizar todas ao mesmo tempo, e esse é um teorema matemático, não uma limitação operacional. A escolha de qual métrica priorizar é essencialmente uma decisão ética disfarçada de ajuste de parâmetro. Outro ponto que pouca gente leva a sério na prática: parcialidade pode ser introduzida post-treinamento durante a fase de deployed monitoring. Um modelo que era razoavelmente balanceado nos testes pode começar a drenar viés conforme os dados de produção se desviam da distribuição original. Isso acontece porque o mundo muda mais rápido do que o ciclo de retreinamento. Eu vi um sistema de triagem médica que, em oito meses, passou de uma taxa de detecção uniforme para uma disparidade de 22 pontos percentuais entre grupos etários, simplesmente porque o padrão de buscas e sintomas na população mudou após um evento sanitário global. O modelo estava correto tecnicamente. Ele apenas refletia uma realidade que já não era mais justa. Se você está começando agora e quer evitar o erro mais comum, a dica mais útil é não confiar na acurácia geral. Ela esconde parcialidade como uma média esconde outliers. Separe sempre a avaliação por subgrupos. Calcule recall, precisão e F1 por grupo antes de aceitar qualquer número como válido. Se o gap entre o melhor e o pior grupo for maior que 5% em qualquer métrica, o modelo tem parcialidade e você precisa decidir como tratar isso antes de ir para produção.
Existe ainda a questão da interpretabilidade. Modelos mais complexos como redes neurais profundas ou ensemble methods tendem a ocultar fontes de viés melhor do que árvores de decisão simples ou regressões logísticas. Isso não significa que modelos simples sejam melhores, mas significa que a ausência de explicabilidade torna a detecção de parcialidade significativamente mais cara em termos de tempo e esforço analítico. Em projetos reais, isso se traduz em semanas extras de trabalho com SHAP values, LIME e análises de contrafactuals para descobrir o que um modelo linear teria revelado em uma olhada. A parcialidade raramente é o resultado de uma má intenção. Frequentemente é o resultado de uma omissão — não verificar dados por subgrupos, não testar em populações fora da distribuição principal, não questionar se a variável alvo é realmente o que você quer prever. O custo de corrigir isso depois de deploy é tipicamente cinco a dez vezes maior do que corrigir durante o desenvolvimento, e muitas vezes envolve retrabalho completo do pipeline de dados, não apenas um ajuste nos pesos do modelo.
Galeria
-
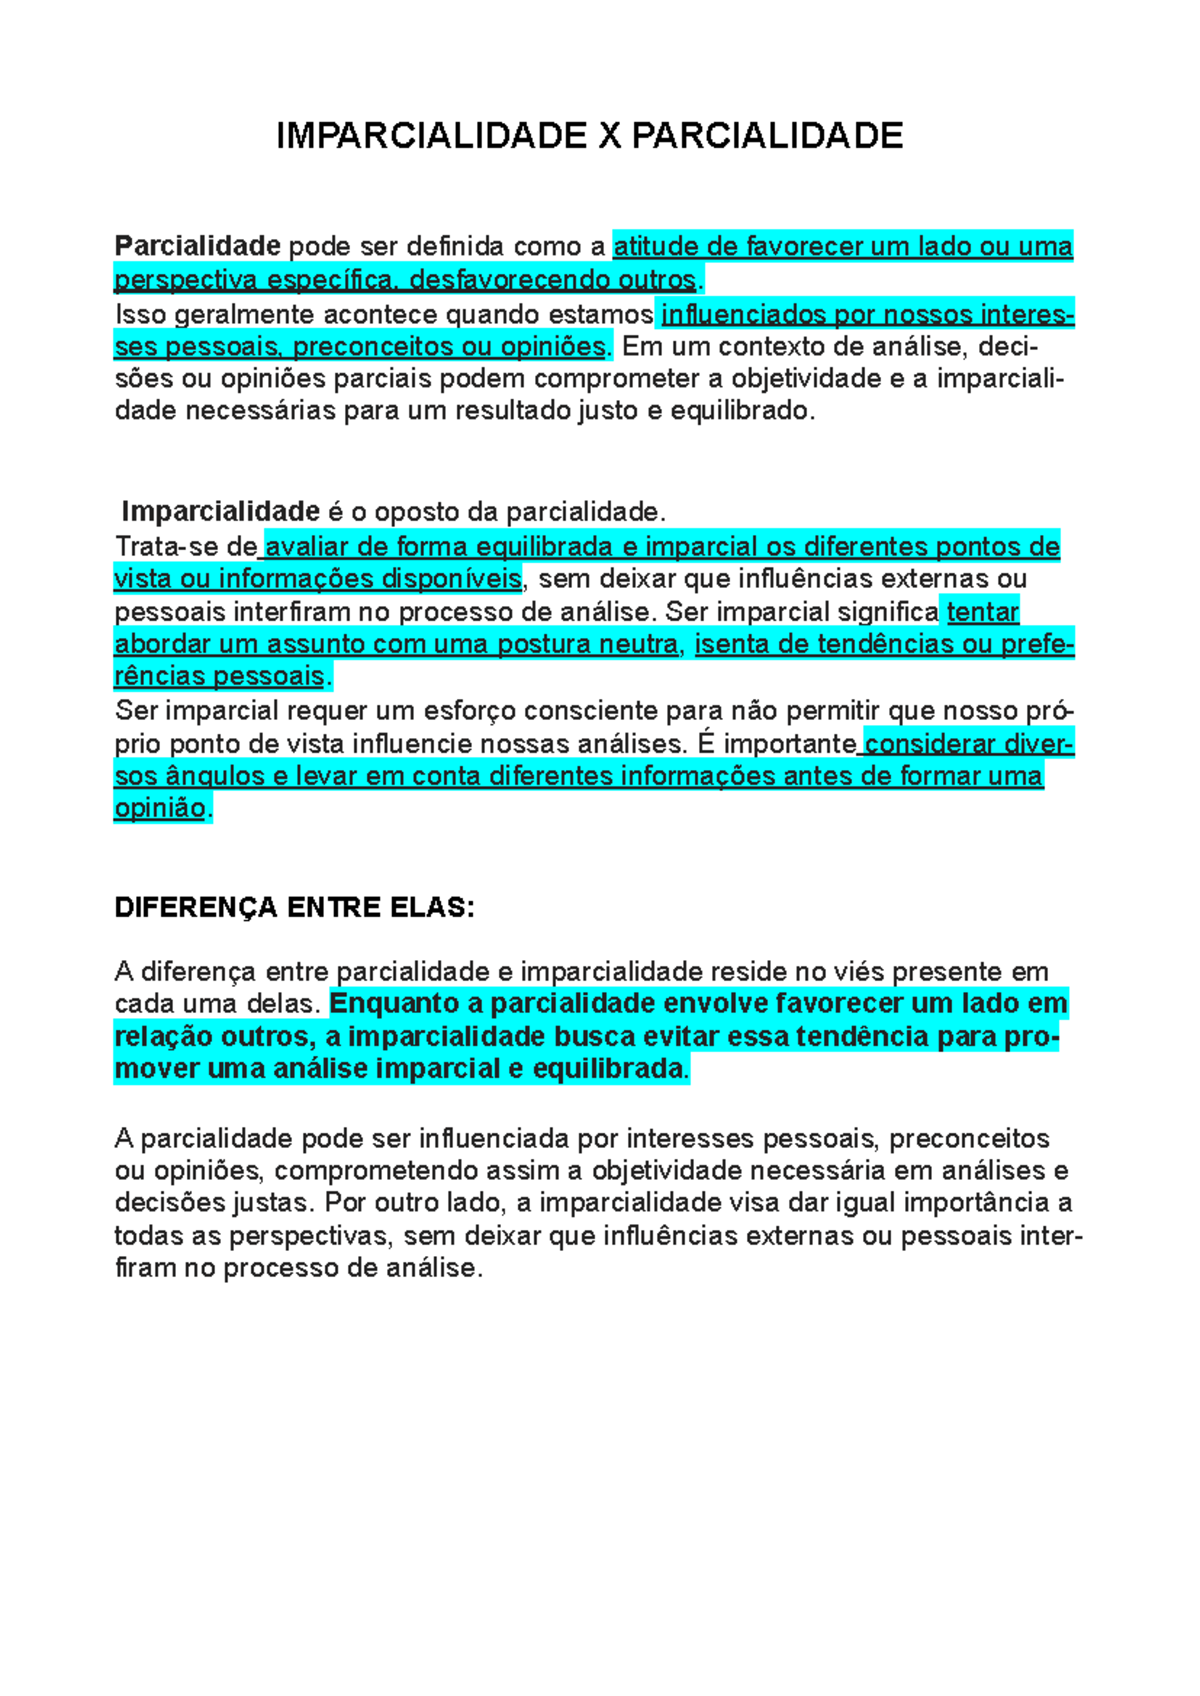
Parcialidade X Imparcialidade - IMPARCIALIDADE X PARCIALIDADE ... -

Parcialidade - Dicio, Dicionário Online de Português -
Parcialidade - Significado e Sinônimo - escreva.ai -
Análise da Parcialidade em Jornalismo | PDF | Jornalismo

