O Que É Parcialmente
Executing Tasks Partially: What It Actually Looks Like in Practice
Partial execution is simply when a process completes a portion of its intended work and stops, either intentionally or because it hit some kind of boundary. It happens constantly across different domains. You see it in batch processing where only some files in a folder get handled. You see it in web scraping when a session drops mid-request. You see it in distributed databases when a query gets split across nodes and one node times out while the others finish fine. The technical term most people use is partial completion, though in different industries you might hear partial fulfillment, partial transaction, partial write, or incremental execution depending on the context. The core idea stays the same: the system did something, but not all of something.
O que é parcialmente e por que isso importa no dia a dia
A maioria das pessoas acha que "parcial" significa algo temporário — que vai ser concluído depois. Na prática, raramente é esse o caso. O que eu vi acontecer na maioria dos projetos que trabalhei é que resultados parciais ficam parados indefinidamente. Um job de ETL que processou 60% dos registros fica assim, sem alertas, sem flag de erro, só esperando alguém notar que os números não batem. E ninguém nota. O problema real não é a execução parcial em si. O problema é que a maioria das ferramentas não te avisa quando algo foi executado parcialmente. Um processo retorna exit code 0. Os logs mostram sucesso. Mas os dados estão incompletos. Você acaba confiando em informação que nunca foi totalmente processada. Eu trabalhei numa pipeline que rodava todos os dias às 3 da manhã. Por seis meses, ninguém percebeu que aproximadamente 40% dos registros de uma tabela de transações não estavam sendo escritos no data warehouse. Os workers intermediários falhavam silenciosamente por pressão de memória, mas o orquestrador marcava tudo como concluído. O problema só apareceu quando fizemos um check de checksum entre a fonte e o destino. A discrepância era de 840 mil linhas. Só paramos pra consertar quando um relatório executivo mostrou números que não fechavam com a planilha financeira.
A solução que implementamos foi simples mas não óbvia para quem não tinha vivido isso antes: adicionar contagem de registros em cada etapa do pipeline e comparar source vs. destination com um threshold de tolerância. Se a diferença fosse maior que 0,1%, um alert ia direto pro Slack. Esse check leva cerca de 3 segundos extras na execução e já nos salvou de pelo menos sete incidentes semelhantes nos dois anos seguintes.

Como identificar e lidar com execução parcial
A primeira coisa que você precisa fazer é verificar se o resultado final contém todas as entradas que o processo deveria ter tratado. Em jobs de processamento de dados, isso significa contar registros na entrada e na saída. Em APIs, significa verificar se todos os ids solicitados retornaram resposta. Em web scraping, significa confirmar que nenhuma página foi pulada por timeout ou redirecionamento inesperado. O que a maioria das pessoas não faz é implementar verificação pós-execução. Elas confiam no status do processo. Status "sucesso" não significa nada se o processo não foi desenhado para validar seu próprio output. Dentro do seu fluxo, você pode adicionar pontos de verificação. Se estiver trabalhando com arquivos, guarde um hash de cada arquivo processado. Se for banco de dados, conte linhas antes e depois da operação. Se for requisição HTTP em lote, mantenha um log de todas as respostas e filtre por status diferentes de 200. Leva alguns minutos a mais de implementação, mas elimina a maior parte dos problemas que surgem semanas depois.
Um detalhe que quase ninguém menciona: execução parcial pode ser feature, não bug. Sistemas como Apache Spark, Kafka consumers e diversos frameworks de machine learning são projetados para lidar com falhas parciais e retomar apenas o que não foi concluído. O problema é que muitos desenvolvedores usam essas ferramentas sem entender o mecanismo de checkpoint. Quando algo falha, o sistema recupera automaticamente, mas você perde a visibilidade do que exatamente foi retryado e por quê. Eu recomendo habilitar logging detalhado de checkpoint desde o início. Depois que o job roda trinta vezes sem problema, ninguém lembra de configurar isso.
Quando execução parcial funciona e quando ela não funciona
Execução parcial funciona bem em cenários onde os dados são idempotentes — ou seja, onde processar os mesmos dados duas vezes não causa problemas. Batch jobs, sincronização de dados, indexação de buscas. Nesses casos, rodar parcialmente e completar depois é perfeitamente aceitável. Não funciona bem em transações financeiras, contratos que precisam de atomicidade completa, ou qualquer situação onde metade do processo gerou efeitos colaterais que a outra metade precisa considerar. Se você processou pagamento para metade dos clientes e a segunda metade depende desse resultado, você tem um problema, não um inconveniente. O limitante mais comum é a falta de instrumentação. Ferramentas modernas de monitoramento como Prometheus com exporters customizados, Datadog APM, ou até mesmo logs estruturados com ELK stack conseguem capturar padrões de execução parcial se você configurar os métricos certos. Mas configurar esses métricos exige trabalho upfront que muitas equipes pulam porque o problema não aparece imediatamente.
Se você está começando do zero e quer algo mais simples que implementar toda essa instrumentação, uma abordagem prática é usar um wrapper que registre timestamp de início, timestamp de fim, contagem de entradas e contagem de saídas. Comparação posterior revela rapidamente se houve perda de dados. Funciona para a maioria dos casos do dia a dia sem exigir infraestrutura complexa.
Galeria
-
Parcialmente - Significado e Sinônimo - escreva.ai -
Parcialmente - sinônimos, pronúncia, significado, exemplos | OpenTran -
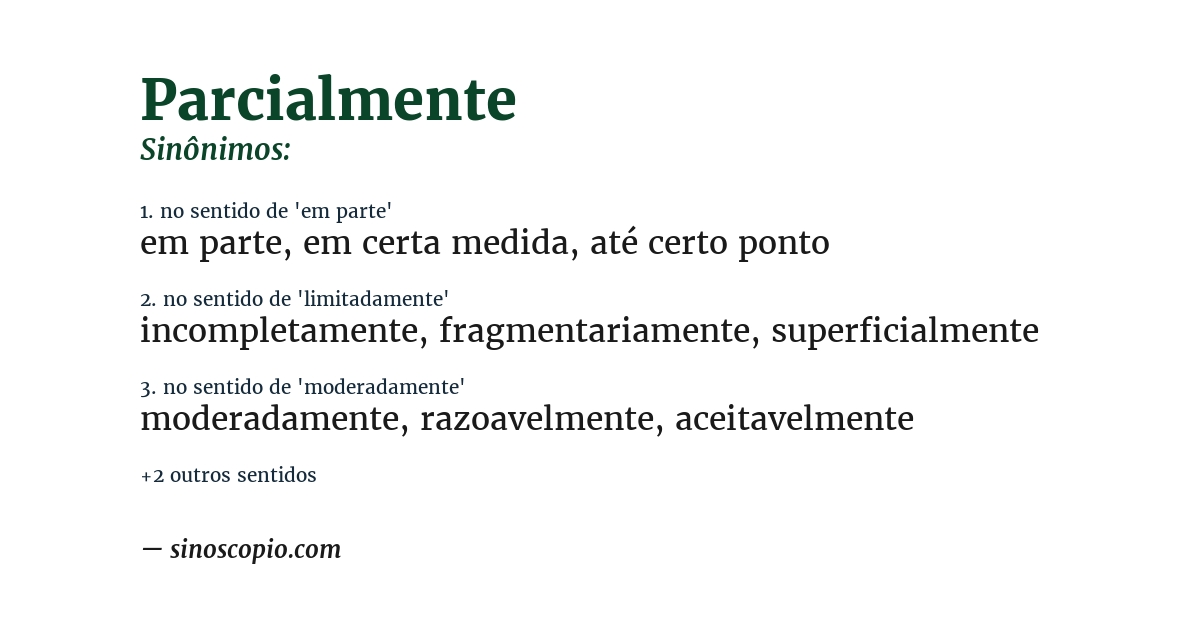
Sinônimos de Parcialmente [por sentido] - Sinoscópio
