O Que É População Em Estatistica

O conceito de população em estatística e por que todo mundo erra nisso
Quando você entra num projeto de pesquisa ou numa análise de dados, a primeira coisa que precisa definir é qual é o seu universo. População, em estatística, é simplesmente o conjunto completo de todos os elementos que você está interessado em estudar. Não é um termo vago. É uma delimitação precisa. Se você quer saber a média de salários dos engenheiros civis que trabalham em São Paulo, a população são TODOS os engenheiros civis que trabalham em São Paulo, não uma amostra deles, não os que aparecem numa lista do CREA, todos mesmo. O problema é que na prática isso parece simples até você ter que medir algo real. Aí descobri que nunca existe uma lista completa. Vou dar um exemplo concreto porque esse é o erro que mais vejo acontecer e que mais quebra projetos.
o que é população em estatistica
Trabalhei numa pesquisa eleitoral interna há alguns anos. O cliente queria estimar a intenção de voto num município com cerca de 180 mil habitantes. A população, na teoria, era clara: todos os eleitores elegíveis do município. Na prática, o Tribunal Superior Eleitoral tinha a lista, mas ela estava desatualizada por seis meses, com óbitos não removidos e mudanças de endereço pendentes. Se você sorteasse aleatoriamente da lista oficial, cerca de 4% a 7% dos contatos não existiam mais no endereço informado. Isso altera a margem de erro de forma silenciosa. A solução que funcionou foi tratar a população estatística como um constructo, não como uma lista física. Eu defini a população alvo como "eleitores elegíveis com residência fixa no município no momento da pesquisa", e depois ajuste o desenho amostral com pesos de ajuste pós-estratificação baseados nos dados do Censo do IBGE por setores censitários. A amostra foi sorteadas dentro de setores, e cada respondente era ponderado pelo inverso da probabilidade de seleção, corrigida pela proporção estimada de elegibilidade no setor. O resultado final tinha um erro amostral real muito mais próximo do que um sorteio ingênuo mostraria. Isso mostra que definir população exige duas coisas: uma definição conceitual e uma definição operacional. A conceitual é o que você quer estudar. A operacional é como você consegue acessar esses elementos no mundo real. Elas quase nunca são idênticas. Ogap entre elas se chama erro de cobertura, e é uma das fontes de viés mais difíceis de detectar porque você nem sempre sabe que está acontecendo.
Tipos de população que você realmente encontra no dia a dia
População finita é aquela com um número contável de elementos. Todas as empresas de um setor, todos os alunos de uma universidade num certo ano. População infinita ou muito grande é quando o número é tão grande que fazer tratamento finito não faz diferença prática. Em produção industrial, por exemplo, se você tem uma linha que produz 50 mil peças por dia e quer estimar a taxa de defeito, a população pode ser tratada como efetivamente infinita para fins de cálculo amostral. O número de peças que você inspeciona é desprezível em relação ao total. Tem ainda a população acessível. Essa é a que você realmente consegue contactar. Em pesquisas online, a população acessível são as pessoas que estão numa plataforma específica. Elas quase nunca coincidem com a população-alvo. Quem não tem acesso à internet, quem não usa determinado app, quem não responde a links de pesquisa — tudo isso é parte da população real que simplesmente não entra no recrutamento. Esse viés de seleção é constante e raramente é comunicado nos relatórios. Outro ponto que as pessoas esquecem: a população muda com o tempo. Se você está estudando renda familiar e coleta dados em janeiro versus julho, a população de pessoas no mesmo domicílio já é diferente. Crianças nascidas, adultos que se mudaram, idosos que faleceram. Pesquisas transversais capturam um instante. Pesquisas longitudinais tentam acompanhar indivíduos, mas aí o risco de perda de acompanhamento (attrition) redefine a população a cada onda.

Como definir a população na prática, sem perder tempo
A sequência que eu uso é básica, mas evita a maioria dos erros. Primeiro, você escreve a população-alvo em uma frase. Ela precisa conter quatro elementos: unidade estatística, características de inclusão, geografia e período temporal. Algo como: "Todos os moradores de domicílios particulares permanentes, com idade igual ou superior a 18 anos, residentes no Município do Rio de Janeiro, entre 1º de janeiro e 31 de dezembro de 2024." Depois, você encontra o frame amostral. Esse é o contato real com a população. Pode ser o cadastro municipal, a lista telefônica, o registro escolar, o sistema de saúde pública. Se não existe frame, você usa amostragem por conglomerados ou por etapas, definindo áreas primárias, setores e unidades finais. No Brasil, o IBGE oferece Quadros de Domicílios e Setores Censitários exatamente para isso. Usar esses quadros reduz drasticamente o erro de cobertura comparado a listar manualmente. Aqui vai algo contra-intuitivo que pouca gente leva a sério: o tamanho da população importa menos do que o tamanho da amostra em populações grandes. Se sua população tem 1 milhão de elementos e você quer uma margem de erro de 2% com confiança de 95%, a amostra necessária é cerca de 2.401 respondentes. Se a população for 10 milhões, a amostra sobe para 2.402. A diferença é de uma unidade. Em populações acima de 100 mil, o fator de correção para população finita já é irrelevante para a precisão. O erro comum é acreditar que precisa de uma amostra proporcional ao tamanho do universo. Não precisa. Precisa de uma amostra proporcional ao nível de precisão que você exige.
Outro detalhe técnico que as pessoas perdem: probabilidade de seleção igual não é o mesmo que representação. Em estratificação desproporcional, você pode superamostrar um grupo pequeno para garantir estabilidade nas estimativas desse subgroup. Depois aplica-se pesos para corrigir a proporção original. Isso é padrão em pesquisas eletrais e de saúde pública, mas gera confusão quando interpretado sem contexto. Uma subamostra de 600 pessoas numa estrato que representa 5% da população não significa que 600 é suficiente para o — significa que 600 é suficiente para o estrato, e o peso compensa a sub-representação.
Erros comuns que destroem a validade da sua pesquisa
O primeiro erro é confundir população com amostra nas conclusões. Você encontra que 70% dos entrevistados preferem o produto X e generaliza para "70% da população prefere o produto X". Só é válido se o desenho amostral foi probabilístico, com probabilidade de seleção conhecida e não nula para todos os elementos. Se foi uma pesquisa por conveniência, como um formulário online divulgado nas redes sociais, a generalização não tem fundamento estatístico. O segundo erro é ignorar o efeito de desenho. Amostragem complexa, com clustering e estratificação, aumenta o erro padrão em relação a uma amostra aleatória simples do mesmo tamanho. O fator de efeito de desenho (deff) pode variar de 1,1 a 2,5 dependendo da estrutura. Se você calcula a margem de erro usando a fórmula de população finita sem considerar o deff, subestima o erro real. Ferramentas como o R com a biblioteca survey ou o Stata com comandos de peso e strato resolvem isso rapidamente. Um terceiro erro, mais sutil: definir a população depois de ver os dados. Isso é p-hacking disfarçado de definição populacional. Você cruza os dados, vê que um segmento específico se comporta de jeito interessante, e então redefine a população para incluir apenas esse segmento, ignorando que essa decisão foi guiada pelos próprios dados. A correção é registrar a definição populacional antes de qualquer análise exploratória. Se precisar ajustar, faça em rodadas separadas e trate a análise ajustada como confirmatória, não exploratória.

Quando a abordagem de população não funciona
Vou ser direto: há cenários onde definir população é impossível ou inútil. Em estudos qualitativos, o conceito de população não se aplica da mesma forma. Amostragem qualitativa busca informação, não representatividade. Você seleciona participantes por relevância para a questão de pesquisa, não por probabilidade de seleção. Forçar a lógica de população e amostragem probabilística aqui gera distorção sem benefício. Em dados administrativos massivos, como registros de prontuários eletrônicos de um sistema de saúde único, a "população" é todo o conjunto de registros disponíveis. Nesse caso, não há amostragem — você trabalha com a população inteira. Mas isso não elimina o viés. Registros incompletos, diagnósticos faltando, pacientes atendidos fora do sistema público: o viés de informação permanece mesmo sem erro amostral. Tratar dados administrativos como sinônimo de população completa é outro erro frequente. Para quem trabalha com pequenas populações, como todas as escolas de uma rede municipal com 47 unidades, a inferência tradicional perde sentido. Testes de hipótese e intervalos de confiança pressupõem extrapolação para um universo maior. Quando você estuda a população inteira, a pergunta certa é descritiva, não inferencial. Descreva o que você tem. Não tente generalizar para "todas as escolas do estado" usando fórmulas de erro amostral.
O que você precisa ter anotado antes de começar qualquer pesquisa
Um documento simples que eu recomendo: a ficha de definição populacional. Ela deve conter população-alvo, frame amostral, critérios de inclusão e exclusão, período de referência, método de seleção, cálculo do tamanho amostral com justificativa, e plano de tratamento de não-resposta. Isso leva cinco minutos para escrever e evita semanas de retrabalho quando alguém questiona a validade dos resultados. O cálculo do tamanho amostral depende de três parâmetros: nível de confiança, margem de erro e variabilidade esperada. Para proporções, a variabilidade máxima ocorre quando p = 0,5. Se você tem informação prévia, use a proporção estimada. Para médias, precisa do desvio padrão populacional ou de uma estimativa pilot. Se não tiver nenhuma estimativa, conduza um estudo piloto com 30 a 50 elementos para calibrar os parâmetros antes do estudo principal. Isso custa pouco e evita amostras subdimensionadas ou excessivamente grandes. A não-resposta merece atenção separada. Se sua taxa de resposta cai para 40%, a amostra efetiva é menor do que o planejado e o viés potencial aumenta. A comparação entre respondedores e não-respondedores, quando possível, revela se há diferenças sistemáticas. No projeto eleitoral que citei, fiz uma análise de comparação entre os setores com maior taxa de não-resposta e os com menor taxa, usando dados censitários como referência. Setores com baixa renda e alta mobilidade residencial tinham não-resposta significativamente maior, e o ajuste por pesos corrigiu esse desbalanceamento antes da estimação final.
A definição de população é o alicerce. Se ela estiver mal construída, todo o resto — amostragem, cálculo amostral, análise, interpretação — carrega o viés consigo. Não adianta usar ferramentas sofisticadas depois. A precisão final da sua pesquisa nunca será maior do que a precisão com que você definiu o que está estudando.

Galeria
-
Fundamentos e Aplicações da Estatística: População, Amostra e Variáveis ... -
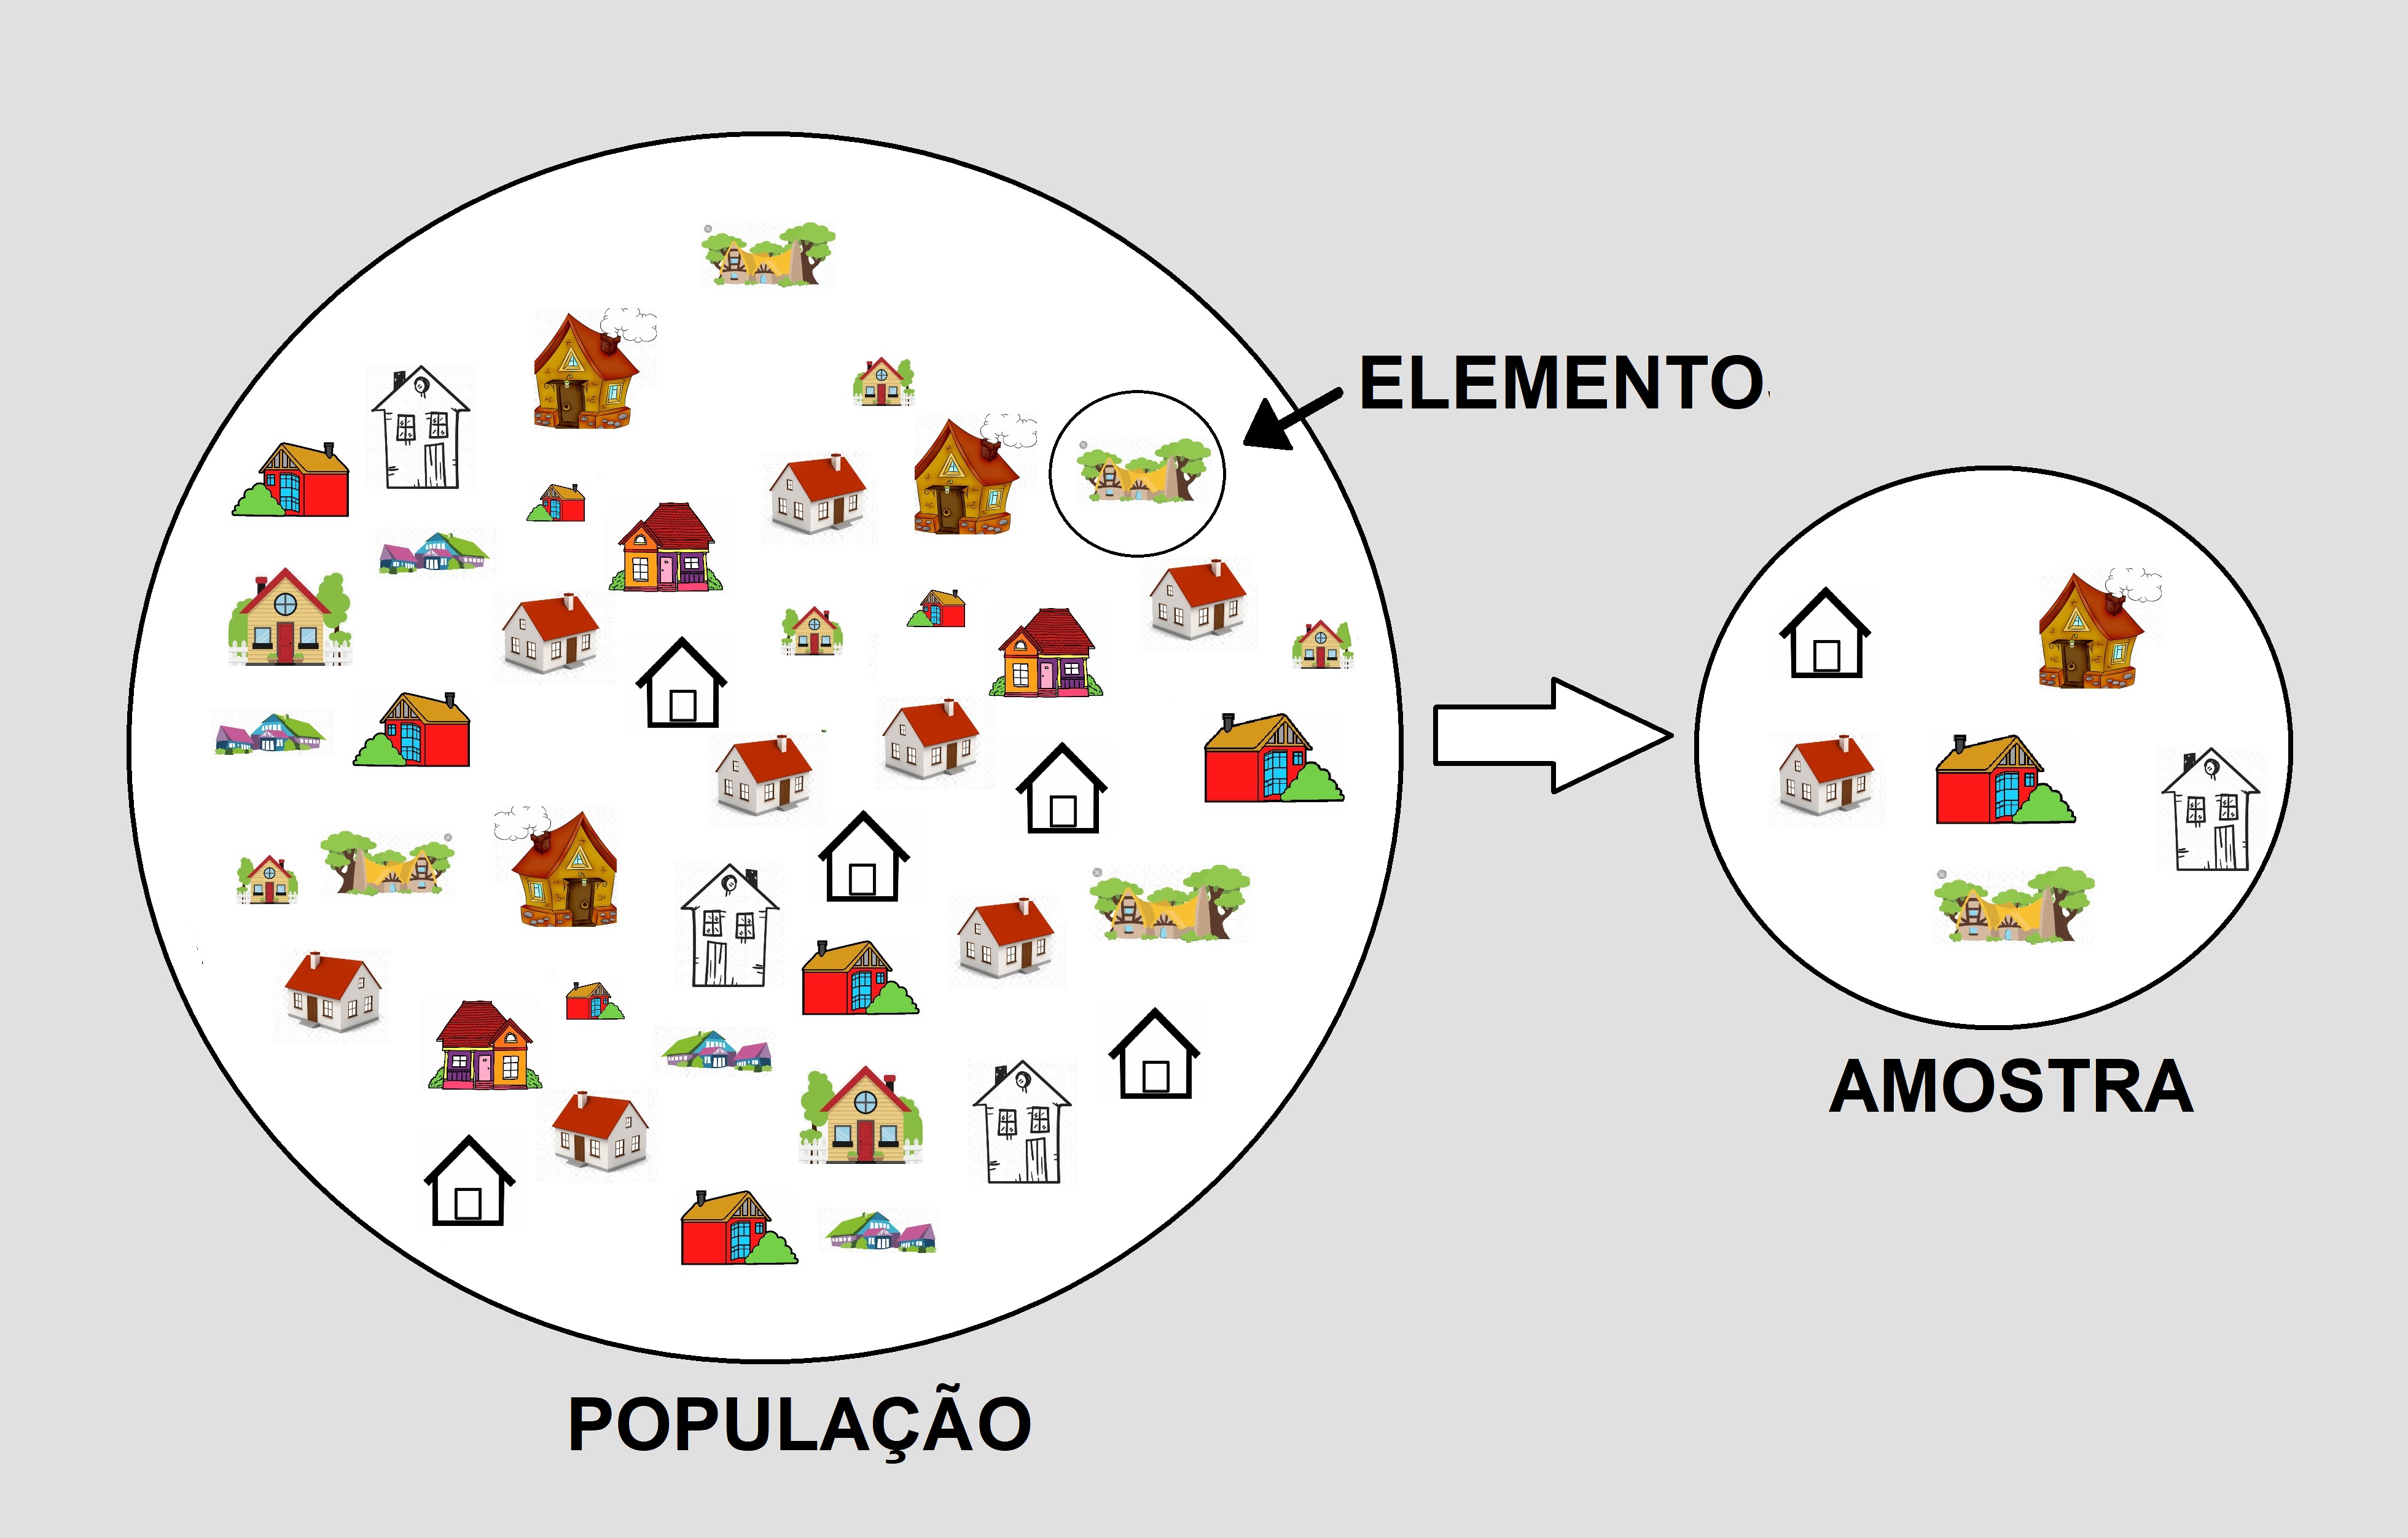
População E Amostra Exemplos - FDPLEARN
