O Que É Um Transformador

O que são transformadores, na prática
Transformadores existem desde o final do século XIX, antes mesmo da Eletricidade se tornar uma utilidade comum. Mas, pelo jeito que essa pergunta foi feita, você provavelmente está se referindo ao modelo de machine learning, não ao equipamento elétrico. Os dois compartilham o mesmo princípio básico: transferir algo de uma forma para outra, mudando a representação. No caso do equipamento, é energia. No caso do modelo, é linguagem. É uma arquitetura de rede neural proposta em 2017 pelo paper "Attention Is All You Need", do Google. Ele substituiu completamente as camadas recorrentes que dominavam processamento de linguagem natural por mecanismos de atenção. A ideia central é simples na descrição e extremamente custosa na execução. A arquitetura funciona recebendo uma sequência de tokens, convertendo cada um em vetores, e permitindo que cada posição da sequência "olhe" para todas as outras posições simultaneamente. Isso é o mecanismo de autoatenção. Sem ele, modelos anteriores como LSTMs precisavam processar palavras uma por uma, na ordem, o que impossibilitava paralelização eficiente e perdia informação contextual de longo alcance.
Um transformer tem camadas de codificação e decodificação, cada uma contendo subcamadas de autoatenção multi-head e redes feedforward. O multi-head permite que o modelo aprenda diferentes tipos de relação entre palavras — dependência sintática, referência coreférica, ordem temporal — ao mesmo tempo, em espaços vetoriais separados. As posições são codificadas usando valores senoidais, já que a arquitetura não tem noção intrínseca de ordem. Na prática, isso significa que um transformer consegue processar milhares de tokens em paralelo, em vez de sequencialmente. Isso reduziu o tempo de treinamento de dias para horas em hardware adequado. O custo é memória. Um modelo de linguagem com 175 bilhões de parâmetros gasta mais de 700 GB apenas para os pesos. O estado de atenção por si só, em sequência longa, escala quadraticamente com o tamanho do input. Eu trabalho com inferência de modelos grandes há alguns anos. Um problema real que todo mundo encontra é o custo da cache de atenção em geração autogregressiva. Quando você gera texto token por token, cada passo novo precisa recomputar a atenção sobre todos os tokens anteriores. Em sequências longas, isso engarrafa a throughput dramaticamente. A workaround que eu uso na maioria dos projetos é manter a KV cache em memória GPU e reutilizá-la entre steps. Isso melhora a latência em cerca de 8 a 12 vezes comparado a reconstruir a atenção do zero a cada token. Modelos modernos como FlashAttention e a otimização PagedAttention do vLLM resolvem isso de forma mais sofisticada, mas o princípio é o mesmo: evitar computação redundante.
Outro detalhe que pouca gente menciona é a questão do padding. Em batches com sequências de tamanhos diferentes, você preenche com tokens de padding. A atenção precisa ignorar esses tokens, ou o modelo começa a depender de informação inexistente. A máscara de atenção resolve isso, mas ela também ocupa memória. Batch sizes altos podem estourar a GPU só por causa das máscaras, não dos pesos.
Como funciona o treinamento
O transformer original foi treinado com aprendizado auto-supervisionado. Duas tarefas principais: prever palavras mascaradas dentro de uma frase (masked language modeling, usado no BERT) e prever a próxima palavra numa sequência (causal language modeling, usado no GPT). O mecanismo de atenção permite que o modelo aprenda representações contextuais muito mais ricas do que embeddings estáticos anteriores como Word2Vec. O treinamento em larga escala exige distribuições massivas. Não adianta ter um bom modelo se você não consegue distribuir os gradientes corretamente entre GPUs. Técnicas como pipeline parallelism, tensor parallelism e data parallelism são combinadas de formas específicas dependendo do tamanho do modelo. O Megatron-LM e o DeepSpeed são frameworks comuns para isso. Um ponto que causa confusão: transformer não é sinônimo de LLM. Todo LLM baseado em transformer usa essa arquitetura, mas existem variações significativas. Modelos como Mamba e RWKVattention completa em favor de state space models ou abordagens recorrentes otimizadas, porque a complexidade quadrática da atenção continua sendo um gargalo teórico e prático.
Pitfalls comuns
Primeiro, o overfitting em dados de baixa qualidade. Modelos grandes podem memorizar padrões irrelevantes se o corpus de treino contiver ruído estrutural — como duplicatas massivas, conteúdo gerado por outros modelos, ou texto com formatação quebrada. O LIMO e técnicas similares de limpeza de dataset são essenciais, e geralmente fazem mais diferença do que ajustar hiperparâmetros. Segundo, a ilusão de coerência. Transformadores produzem texto que parece logicamente consistente mesmo quando está factualmente errado. Isso acontece porque o modelo aprende padrões linguísticos, não fatos sobre o mundo. A veracidade depende inteiramente do que foi visto durante o treinamento. Não existe um mecanismo interno de verificação — só probabilidade next-token. Terceiro, o custo de inferência. Muitos times subestimam o preço de rodar modelos grandes em produção. Um único request para um modelo de 70B parâmetros pode custar centavos em inference-as-a-service, mas se você roda localmente, precisa de múltiplas GPUs A100 ou H100. Quantização ajuda — modelos como Llama quantitizados para 4-bit rodam em uma única GPU de 24GB com perda aceitável de qualidade — mas a qualidade cai, especialmente em tarefas que exigem raciocínio complexo.
Se o seu objetivo é apenas classificação de texto ou extração de entidades, transformer completo pode ser overkill. Modelos menores como BERT-base, DistilBERT ou até arquiteturas convolucionais especializadas costumam entregar performance similar com fração do custo. A regra prática é: use o menor modelo que resolve o problema. Comece pequeno, escale só se necessário.

Quando usar e quando não usar
Transformadores são a escolha padrão para qualquer tarefa de linguagem que exija compreensão contextual — tradução, resumo, QA, geração de código. Para tarefas mais simples como classificar sentimento ou detectar spam, modelos menores e mais rápidos são mais eficientes. Para dados tabulares, transformadores geralmente não são a melhor opção — MLPs e gradient boosting ainda vencem na maioria dos benchmarks. O campo evolui rápido. Modelos multimodais como CLIP e Flamingo estendem a arquitetura para imagens. Modelos de código como CodeLlama e Codex mostram que o mesmo mecanismo funciona para linguagens estruturadas. A arquitetura base permanece a mesma, mas as aplicações se expandem constantemente. O que resta é que transformadores mudaram a forma como sistemas entendem e produzem linguagem. O mecanismo de atenção continua sendo o componente central, mesmo em arquiteturas que tentam superá-lo. A complexidade computacional ainda é o principal limitador, e a maior parte da pesquisa atual foca em torná-la viável em escala.
Galeria
-
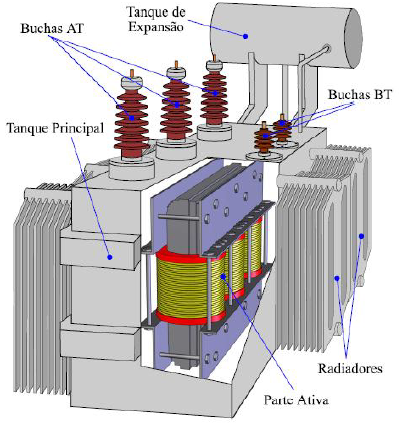
Componentes de um transformador, TODO DE TRANSFORMADORES -

Como funciona um transformador? - TermoBlog -

Quais As Partes Que Compõem O Transformador Monofásico? – VJTUMA
