O Que É Uniformemente
O que significa distribuir uniformemente
A distribuição uniforme, conhecida como distribuição U(a,b), é uma das mais simples do mundo estatístico. Ela atribui a mesma probabilidade a todos os valores dentro de um intervalo fechado [a, b]. A função densidade de probabilidade é constante nesse intervalo e zero fora dele. Nada mais longe da complexidade que a gente encontra no dia a dia. Muita gente confunde "uniforme" com "aleatório". Eles não são a mesma coisa. Aleatoriedade indica imprevisibilidade. Uniformidade indica igualdade de probabilidade entre os valores possíveis. Você pode gerar números aleatórios que não são uniformes — como a distribuição normal, onde valores perto da média são mais frequentes — e pode ter distribuição uniforme sem surpresa alguma.
o que é uniformemente aplicado na prática
Na prática, usar uma distribuição uniforme é comum em simulações de Monte Carlo, testes A/B com alocação igualitária, e geração de variáveis pseudorretomadas para bootstrap. Mas o problema real que as pessoas encontram não é o conceito em si, e sim a implementação. Um detalhe que ninguém conta nos manuais: geradores de números pseudoaleatórios de boa qualidade, como o Mersenne Twister, podem produzir sequências que parecem uniformes em amostras pequenas, mas apresentam correlações perceptíveis em dimensões mais altas. O problema ficou famoso como o "cubo de esferas" (lattice structure) em testes de uniformidade multivariada. Se você estiver usando valores uniformes para integrar integrais multidimensionais, essa estrutura pode enviesar seu resultado significativamente. Eu já perdi meio dia caçando um viés em uma simulação de Monte Carlo porque estava gerando pontos uniformes usando rand() do C, que tem período curto e padrões cíclicos visíveis quando projetado em duas ou três dimensões. A solução foi trocar para o PCG64 ou para o algoritmo xorshift128+, que são trivialmente fáceis de implementar e muito superiores para fins de simulação.
Como calcular probabilidades com distribuição uniforme contínua
Para uma variável X ~ U(a, b), a probabilidade de X cair em um subintervalo [c, d], onde a c
d b, é simplesmente (d - c) / (b - a). A área sob a curva — que é um retângulo de altura 1/(b-a) — fala por si só. A média é (a + b) / 2, a variância é (b - a)² / 12, e o desvio padrão é (b - a) / 12. Um erro comum é esquecer que a uniformidade se aplica ao espaço amostral contínuo, e não a categorias discretas. Quando você distribui uniformemente entre 1 e 1000, cada número inteiro tem probabilidade 1/1000. Mas se o espaço for contínuo entre 0 e 1, a probabilidade de qualquer ponto específico é exatamente zero. Isso parece paradoxal até você se acostumar.
Distribuição uniforme discreta versus contínua
A versão discreta é ainda mais direta. Cada um dos n valores possíveis recebe probabilidade 1/n. É o que acontece quando você lança um dado justo ou sorteia um nome de uma lista com reposição. Não há graduação, não há peso, cada resultado empata em probabilidade. A versão contínua exige que a gente pense em termos de densidade, não de probabilidade pontual. A integral da função densidade sobre qualquer intervalo dá a probabilidade de a variável cair naquele intervalo. A função de distribuição acumulada é linear: F(x) = (x - a) / (b - a) para x entre a e b.
Erros comuns e armadilhas
Um dos maiores erros que eu vejo gente cometer é tratar um gerador de números pseudoaleatórios como se fosse verdadeiramente uniforme. Software estatístico como R, Python (numpy.random), e Stan usa algoritmos modernos que passam em testes como o Diehard e o TestU01, mas limites existem. Se você está rodando milhares de simulações com seeds diferentes e colando os resultados depois, pode acabar com autocorrelação sutil entre lotes que distorce intervalos de confiança. Outro problema frequente é a confusão entre randomização uniforme e randomização estratificada. Em testes A/B, alocar usuários uniformemente para dois grupos funciona bem em teoria. Na prática, com turnover de usuários e efeitos de dia da semana, uma alocação puramente uniforme pode gerar desbalanceamento nas coortes. A solução mais simples é uso de randomização estratificada ou bloqueada, garantindo equilíbrio em subgrupos-chave.
Quando não usar distribuição uniforme
Há cenários em que a uniformidade é claramente inadequada. Se você está modelando tempo até falha de componentes, a exponencial é mais natural. Para medições com erros acumulaos, a normal se aplica. Para dados com caudas pesadas, considere a log-normal ou a Cauchy. Usar uniforme por preguiça de escolher uma distribuição mais adequada produz modelos que parecem inocentes mas geram previsões completamente desconectadas da realidade. A distribuição uniforme também quebra quando o domínio não é bem definido. Se você precisa simular algo em um intervalo aberto ou semiaberto, cuidado com valores de fronteira. Geradores baseados em float podem produzir exatamente 0.0 ou 1.0, o que em alguns contextos — como sampling logarítmico ou inversão da CDF para distribuições com suporte infinito — gera erros numéricos silenciosos.
Implementação prática em código
Em Python, a forma padrão é numpy.random.uniform(a, b, size). Em R, runif(n, min=a, max=b). Em JavaScript, Math.random() retorna U(0, 1) e basta multiplicar por (b - a) e somar a. Para geração criptograficamente segura, use o módulo secrets do Python ou crypto.getRandomValues() do navegador, que usam geradores baseados em hardware e são uniformes o suficiente para segurança, embora mais lentos. Se você precisa de uniformidade em alta dimensão — digamos, amostragem para integração numérica em 10+ dimensões — pense em sequências quasi-ubiformes como Halton ou Sobol. Elas cobrem o espaço de forma mais eficiente que amostragem puramente aleatória e convergem mais rápido para integrais multidimensionais. O custo é que não são estritamente independentes, o que pode ser problema em simulações que exigem independência.
o que é uniformemente resolvido: um exemplo real
Recentemente precisei calibrar um modelo de precificação onde cada um de mil cenários de mercado precisava ser amostrado com igual probabilidade. A abordagem ingênua de sortear uniformemente entre os parâmetros deu resultados muito piores do que o esperado porque as caudas da distribuição real dos dados eram muito mais longas do que o intervalo uniforme capturava. A correção foi mapear os valores uniformes pela função quantil (inversa da CDF) da distribuição empírica dos dados históricos. O processo ficou mais lento, cerca de 40% mais demorado na fase de geração de cenários, mas a calibração do modelo melhorou drasticamente. A lição prática: distribuição uniforme é uma ferramenta poderosa, mas geralmente serve como peça intermediária num pipeline maior, não como resposta final.

Galeria
-
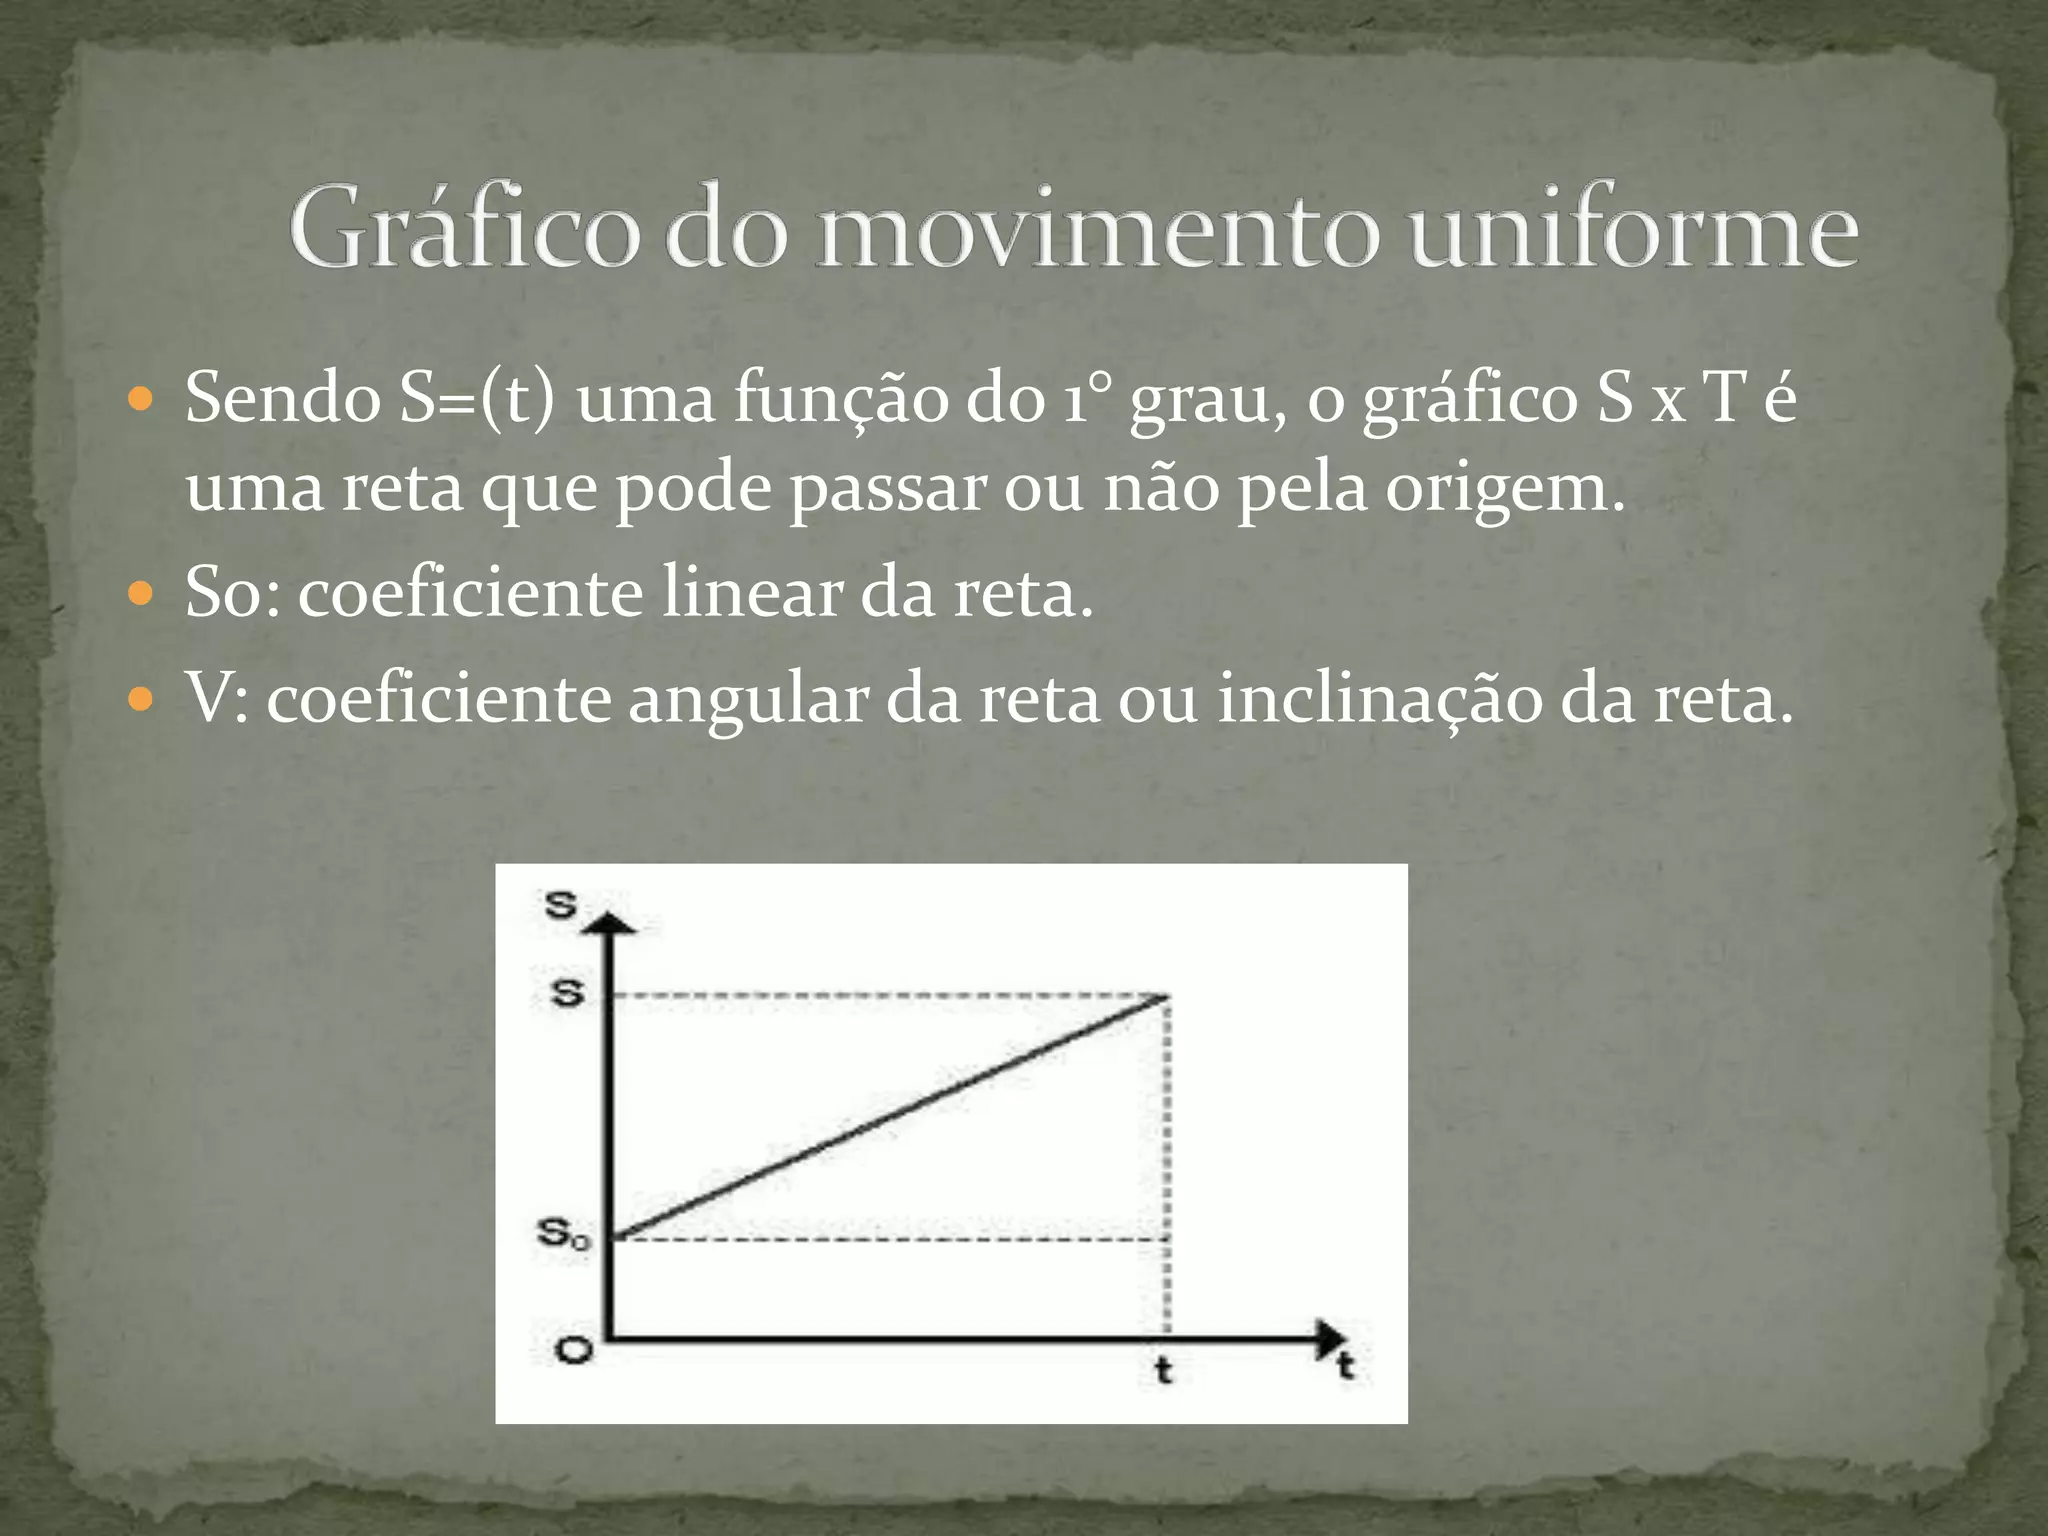
Movimento uniforme, uniformemente variado e | PPTX -

Movimento Uniformemente Variado - Física
