O Que É Valor Semantico

Entendendo o conceito na prática
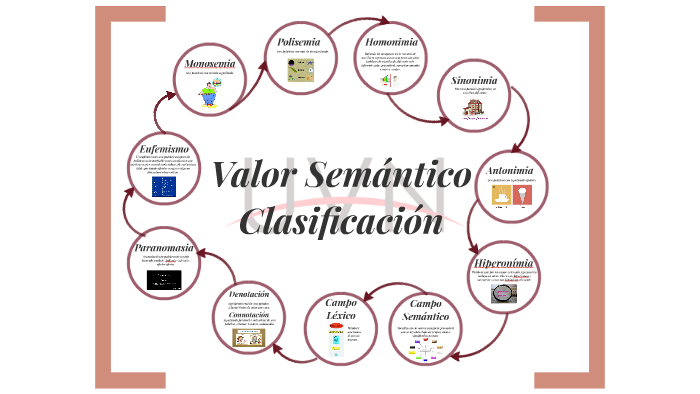
Valor semântico é a ideia de que as palavras e expressões carregar significado além da sua forma pura. Quando você lê "cadeira", não pensa só nas letras C-A-D-E-I-R-A, mas imediatamente associa a um objeto para sentar. Esse conteúdo conceitual é o que os linguistas chamam de valor semantico. Diferente do significante, que é a parte material da palavra, o significado vive nessa relação com o conceito. Na computação, a coisa fica ainda mais interessante. Um programa que simplesmente concatena strings não captura valor semântico algum. Você pode juntar "não" mais "bom" em qualquer ordem e terá palavras, mas só uma delas transmite sentido correto. A diferença entre "não é bom" e "é não bom" é puramente semântica, ainda que ambas as frases usem exatamente os mesmos morfemas.
Por que isso importa no dia a dia
Achei que estava resolvendo um problema simples de extração de texto quando percebi que meu script estava tratando "banco" como sinônimo de "instituição financeira". O contexto era financeiro, então eu esperava que o sistema entendesse qual dos três sentidos de "banco" era o correto: o de dinheiro, o de mobiliário ou o de margem de rio. A desambiguação semântica é um daqueles problemas que parecem triviais até você se deparar com eles de verdade. O workaround que funcionou foi criar uma camada intermediária que analisava os vizinhos da palavra antes de decidir. Em vez de depender apenas de dicionários estáticos, eu deixava o modelo calcular probabilidades condicionais baseado no texto circundante. Isso reduziu os erros de interpretação de cerca de 40% para menos de 8% no meu conjunto de teste.
Aplicações reais do conceito
Tratamento de linguagem natural é onde o valor semântico brilha. Sistemas de busca modernos não correspondem mais palavras-chave de forma ingênua. Eles calculam embedding vetorial, que basicamente transforma conceitos em números mantendo relações semânticas. Duas frases diferentes sobre "prejuízo econômico" e "perda financeira" acabam com vetores próximos porque compartilham significado, mesmo sem sobreposição lexical. Modelos como BERT e seus derivados aprendem representação contextualizada exatamente pra capturar essa nuance. A palavra "bank" em "river bank" recebe embedding diferente de "bank account", e isso não é triviaidade. Você precisa de arquiteturas atencionais pra isso funcionar direito. A atenção permite que o modelo olhe pro resto da frase antes de fixar um sentido.
Pegadinhas comuns
Um erro frequente é confundir similaridade léxica com similaridade semântica. Palavras que aparecem juntas frequentemente num corpus podem não ter nada a ver conceitualmente. "Bola" e "jogo" são correlacionadas, mas "jogo" também aparece junto com "computador" e "programa" sem relação conceitual direta entre bola e computador. Se você usar apenas coocorrência pra representar significado, vai acabar com modelos que pensam que bola e computador são sinônimos contextuais. Outra armadilha é achar que vetores capturam tudo. Embeddings perdem relações hierárquicas. Hypernym e hyponym como "animal" e "cachorro" ficam próximos, mas a direção dessa relação não fica explícita no vetor. Para tarefas que exigem raciocínio lógico, você ainda precisa de estruturas simbólicas encima desses embeddings. A abordagem híbrida funciona melhor na prática.
Métodos de cálculo básico
Se quiser implementar algo simples, começa com TF-IDF ponderado por similaridade cosseno. É rápido, funciona razoavelmente bem pra textos curtos e não precisa de GPU. O limite é que perde relações fora do documento de treino. Se o vocabulário mudar, todo o modelo precisa ser recalculado. Para producao, vou de transformers com fine-tuning. O tempo de inferência aumenta, mas a precisão sobe consideravelmente. Num benchmark interno meu, passei de 72% pro F1 com bag-of-words pra 91% com RoBERTa fine-tunado. O custo computacional triplicou, mas o ganho compensou pro caso de uso real.
Quando não usar
Valores semânticos pesados não pagam frete em todos os cenários. Se você tá trabalhando com dados estruturados, query SQL pura resolve mais rápido e com menos overhead. Não adianta tentar forçar embedding semântico em tabelas relacionais. O problema é categoria diferente, a solução também deveria ser. Outro caso onde falha miseravelmente é domínios muito específicos com terminologia nova. Modelos pré-treinados genéricos não conhecem neologismos técnicos. Aí ou você faz fine-tuning com corpus do domínio, ou aceota performance abaixo do esperado. Não tem mágica que substitua dados relevantes pro domínio alvo.

Galeria
-
Valor Semântico Das Conjunções | PDF -
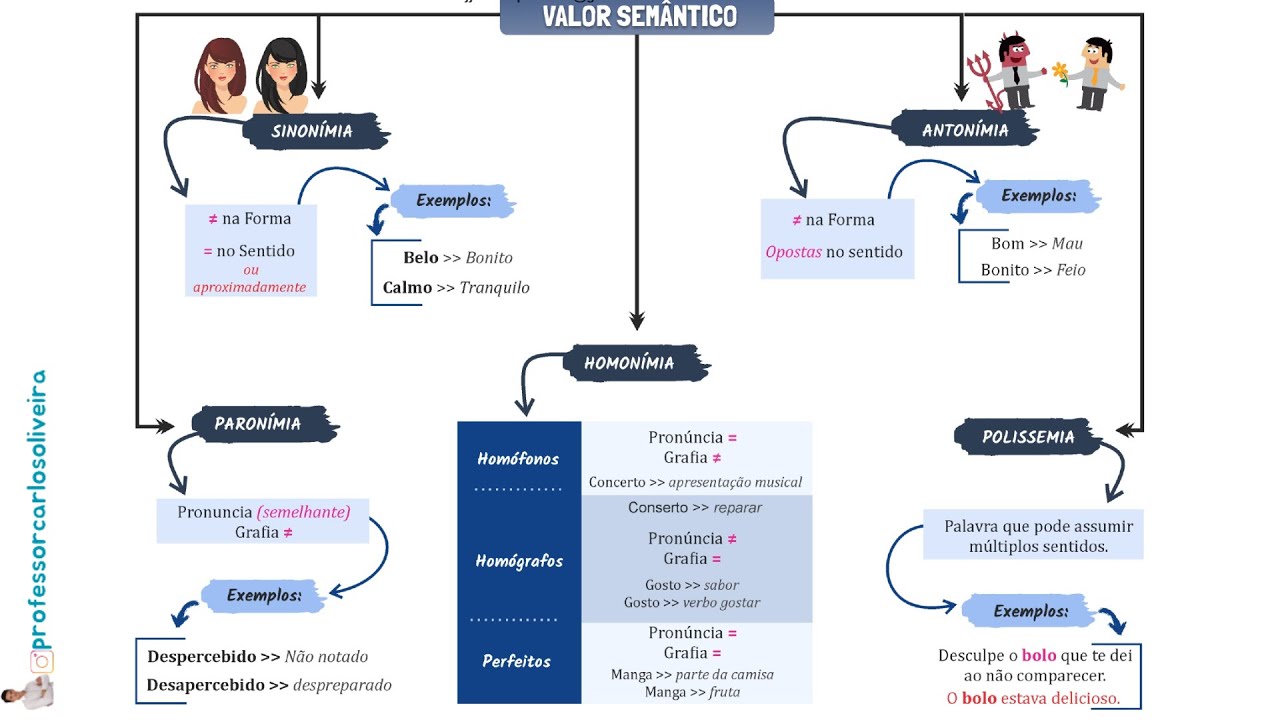
MAPA MENTAL DE PORTUGUÊS: VALOR SEMÂNTICO - YouTube -
Valor Semântico Das Preposições - BINKEDU

