O Que É Variação Diacrônica
Variação diacrônica é só isso: a língua mudando ao longo do tempo, sem romantismo.
Quando alguém pergunta o que é variação diacrônica, a resposta mais direta possível é que ela estuda como o português (ou qualquer língua) se transforma entre gerações. Ponto. Não tem mistério. A confusão geralmente surge porque as pessoas acham que variação é só coisa de sotaque ou gíria atual, mas a dimensão diacrônica olha para trás, para séculos, não para regiões. Em termos formais, variação diacrônica é o estudo das mudanças linguísticas em um eixo temporal. O eixo sincronônico, oposto, analisa o sistema num momento específico. Na prática, isso significa que quando você pega um texto do século XVI e compara com um do século XXI, está lidando com variação diacrônica. Não precisa ser um livro inteiro — uma única mudança morfológica ou lexical já basta para caracterizar o fenômeno. O que a maioria dos manuais não destaca é que variação diacrônica raramente é linear. As línguas não evoluem como uma reta que sobe. Elas ramificam, regredem, estabilizam, entram em colapso em certas regiões e se renovam em outras. Conheço linguistas que passaram anos rastreando a perda do caso oblíquo no português e descobriram que o processo não foi uniforme: em textos notariais do Alentejo, as marcas persistiram décadas a mais do que nos documentos da chancelaria real.
Se você está começando a mexer com isso, o primeiro erro comum é tratar o português medieval como umbloco homogêneo. Não é. O galego-português do século XIII já apresentava divergências regionais que ecoam até hoje. Ignorar isso leva a generalizações baratas sobre "como falávamos antigamente".
Como estudar variação diacrônica na prática
A primeira coisa que você faz é escolher um corpora. O ideal é um que tenha versões documentadas ao longo do tempo. Para o português, o CDB (Corpus do Português) do Mark Davies é o ponto de partida mais acessível, mas ele tem limitações sérias em termos medievais. Para aquele período, você precisa recorrer ao Corpus Trovadorista Galego-Português ou às edições críticas de documentos medievais digitalizados, como os do Arquivo Nacional da Torre do Tombo. Depois de selecionar o material, o processo básico é: 1. Definir o fenômeno — escolha uma variável específica. Pode ser a queda do pronome oblíquo átono, a perda do dual, a mudança na posição do adjetivo, a lexicalização de um neologismo. Quanto mais específica a variável, mais viável a análise. Tentar analisar "toda a gramática do português medieval" é uma receita para nunca terminar o projeto.

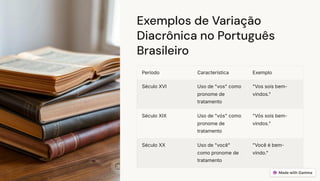
2. Coletar os dados — extraia ocorrência da variável em pelo menos três cortes temporais. Recomendo um mínimo de 500 tokens por período para ter confiabilidade estatística básica. Menos que isso e qualquer conclusão será especulação disfarçada. 3. Quantificar — calcule a frequência relativa, não absoluta. 20 ocorrências em um corpus de 1.000 tokens não equivalem a 20 ocorrências em um corpus de 100.000. Normalize por 1.000 ou 10.000 palavras para comparar adequadamente. 4. Contextualizar — aqui é onde a coisa fica interessante. Mudanças linguísticas não acontecem no vácuo. Se você está estudando a mudança no tratamento (tu/você/vossa mercê), precisa entender as dinâmicas de poder, contato linguístico e normas sociais da época. Dados sem contexto são apenas números bonitos.
Um problema real que eu enfrentei e como resolvi
Estava analisando a variação entre os dativos de clítica "me" e as formas perifrásticas com "a mim" em textos dos séculos XIV e XV. O padrão esperado era uma subida gradativa das formas analíticas. Mas os dados do corpus não mostravam isso de forma clara — havia oscilações aleatórias entre os períodos que não faziam sentido teórico. O problema era que o corpus que eu estava usando misturava registros. Textos jurídicos, cartas pessoais, crônicas, testemunhos orais transcritos — tudo junto. A variação que eu atribuía ao tempo era, na verdade, variação registral. O dativo perifrástico era muito mais frequente em documentos informais e testemunhais do que em textos notariais. A solução foi separar os gêneros textuais e analisar cada um individualmente. Isso aumentou o tempo de processamento em cerca de 40%, mas os resultados finalmente coerentes com a literatura. Lição: verifique sempre se a variável temporal não está confundida com a variável registral. É um problema quase universal em estudos diacrônicos com corpora desbalanceados.
O que ninguém te conta sobre variação diacrônica
Insight 1: Muitas "mudanças" que você vê nos manuais são na verdade artefatos de registro. O português "perdeu" certos traços não porque a língua mudou, mas porque os textos que sobrevivem são majoritariamente formais. Textos mais informais de épocas diferentes podiam mostrar padrões completamente distintos. Sempre triangule com fontes que tenham diversidade registral. Insight 2: A datação dos documentos é mais problemática do que parece. Muitos manuscritos medievos têm datações imprecisas ou disputadas. Um texto que você considera do século XV pode ser do final do XIV. Verifique a datação em múltiplas fontes antes de usar o documento. Gastei duas semanas num projeto descobrindo que três dos meus cinco textos-base tinham a datação contestada pela paleografia. Insight 3: Variação diacrônica e variação diatópica se cruzam constantemente. Uma mudança que parece generalizada pode ser regional. O que você interpreta como evolução diacrônica pode ser a expansão de um traço dialectal. Se possível, controle geograficamente sempre que os dados permitirem.
Limitações e onde o método falha
Variação diacrônica depende inteiramente da sobrevivência de documentos. A maioria da fala real não deixou rastro escrito. Isso significa que suas conclusões são enviesadas para as variedades literárias e administrativas — que, convenhamos, sempre foram faladas por uma minoria. Você pode reconstruction sólida sobre a língua escrita culta de determinado período, mas fazer afirmações sobre a língua falada pelo resto da população é especulação com vestes de ciência. Outro problema sério: corpora digitais muitas vezes têm erros de transcrição. Tokens corrompidos, palavras truncadas, variações ortográficas não padronizadas que confundem seus scripts de extração. Eu já perdi horas debugando porque uma query retornava resultados vazios e a causa era um caractere Unicode malcodificado em uma palavra do século XV. Sempre valide manualmente uma amostra dos seus resultados extraídos. Se o seu foco for português pré-moderno (antes do século XVI), considere que as ferramentas computacionais padrão são praticamente inúteis. A variação ortográfica é tão ampla que scripts baseados em regular expressions falham consistentemente. Nesse caso, o trabalho manual com edições críticas é mais confiável, apesar de mais lento — e muito mais lento mesmo, dependendo do volume.
Para análises quantitativas rigorosas, packages como o R com bibliotecas como quanteda ou tidytext funcionam bem para períodos modernos. Para medieval, você precisa de pipelines customizados que lidem com a variação gráfica. Há templates no GitHub de outros pesquisadores, mas adapte-os ao seu corpus específico — copiar e colar sem ajustar vai gerar ruído suficiente para invalidar qualquer análise. O campo tem avançado com abordagens híbridas que combinam análise computacional com validação filológica. Se você está começando, o caminho mais seguro é dominar os fundamentos da linguística histórica primeiro e só depois investir em automação. Ferramenta sem teoria por trás é só uma maneira mais rápida de produzir erro.
Galeria
-
Variação Diacrônica do Português | PDF | Português (idioma) | Linguística -
ADM- Variação Diacrônica | PDF -
Variação linguística 2


