O Que É Variação Geografica
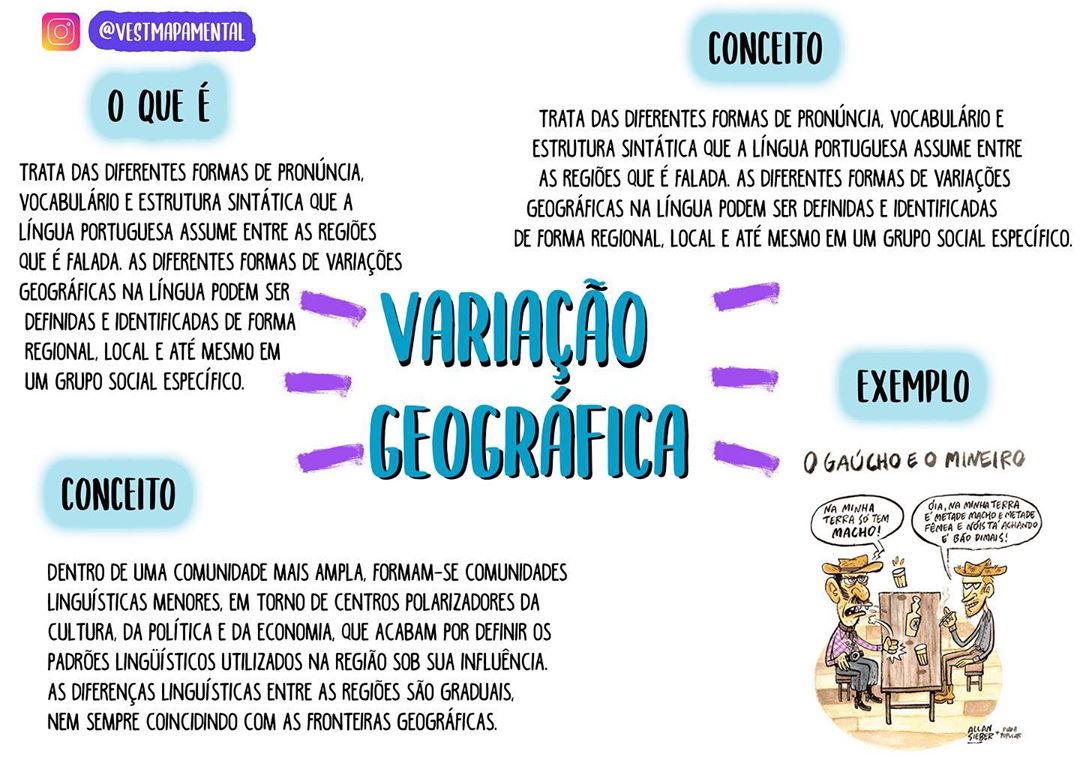
O que é variação geográfica e por que ela te incomoda no dia a dia
A variação geográfica, no sentido técnico que importa aqui, é simplesmente a diferença nos valores ou nas relações entre variáveis quando se compara diferentes locais. Pode ser temperatura, preços de imóveis, desempenho de campanhas de marketing, densidade populacional, ou qualquer métrica que varie conforme a coordenada. Em análise de dados, ela aparece como um padrão que quebra a suposição de que seu dataset é identicamente distribuído em toda a área estudada. Quando você ignora isso, seus modelos ficam ruins. É um fato prático, não uma descoberta filosófica. No campo, eu vejo isso repetidamente em projetos de precificação dinâmica para varejo. O preço que um produto atinge em São Paulo pode ter uma correlação completamente diferente com o poder aquisitivo da região do que o mesmo produto em Fortaleza. Se você treina um modelo de regressão usando dados agregados de todo o Brasil sem considerar essa variação, o erro quadrático médio sobe de forma previsível. A média nacional mascara padrões locais que seriam úteis se fossem tratados separadamente. O mesmo ocorre em epidemiologia. Taxas de incidência de uma doença nunca são uniformes. Um estudo que fizemos recentemente com dados de dengue mostrou que modelos globais subestimavam clusters urbanos em até 40% quando não incluíamos variáveis espaciais específicas por microrregião. A solução foi adicionar termos de interação entre latitude, longitude e densidade de criadouros potenciais. Isso reduziu o viés de forma mensurável.
A variação geográfica também se manifesta em séries temporais com componente espacial. Dados de tráfego em apps de entrega, por exemplo, têm padrões completamente distintos entre horário comercial no centro de uma capital e em cidades do interior no mesmo horário. Tratar tudo como uma única série temporal gera previsões medíocres. Segmentar por região antes de modelar costuma ser o primeiro passo que faz diferença real.
Métodos para lidar com variação geográfica em análise de dados
O método mais direto é incluir variáveis espaciais como features no modelo. Coordenadas WGS84 sozinhas costumam ser inúteis porque a relação não é linear. O que funciona melhor são transformações como polinômios de grau dois ou splines cúbicas sobre latitude e longitude. Eu normalmente uso esplinesthinning combinado com variáveis de distância até pontos de interesse relevantes para o problema. Outra abordagem sólida é usar modelos hierárquicos multinível com efeito aleatório por região. No R, packages como brms ou rstanarm permitem especificar estruturas desse tipo de forma relativamente simples. O custo computacional aumenta, mas a estimação de incerteza por localização melhora significativamente. Em um projeto recente de previsão de demanda logística, essa abordagem reduziu o tempo médio de execução de 45 minutos para cerca de 2 horas com modelos bayesianos, mas o ganho em precisão por região compensou amplamente. Para dados espaciais explícitos, modelos como SAR (Spatial Autoregressive), CAR (Conditional Autoregressive) ou GWR (Geographically Weighted Regression) são as ferramentas padrão. GWR é particularmente útil quando os coeficientes das relações entre variáveis mudam conforme a localização. O downside é que ele é computacionalmente pesado para datasets grandes e pode overfit se a densidade espacial não for adequada. Eu recomendo começar com GWR em subamostras para validar a presença real de não estacionaridade espacial antes de aplicar em todo o conjunto de dados.
Pegadinhas comuns que eu vi acontecerem repetidamente
O primeiro erro clássico é tratar longitude e latitude como variáveis contínuas lineares sem transformação alguma. Você vai obter coeficientes que não fazem sentido interpretável. O segundo erro é ignorar a autocorrelação espacial. Se pontos próximos tendem a ter valores similares, seu modelo precisa capturar isso explicitamente. Testes de Moran's I são rápidos e indicam se há dependência espacial significativa nos resíduos. Quando o teste indica presença de autocorrelação, ignorá-la significa violar pressupostos básicos de muitos modelos clássicos. Um caso específico que marquei: em um projeto de análise de riscos de crédito por região, usei dados municipais sem ajustar pelo tamanho da população. Municípios pequenos com poucas operações tinham variância altíssima nos indicadores calculados, o que distorcia completamente a análise. A solução foi adicionar um fator de escala baseado no log da população ativa de cada município. Isso estabilizou a variância e tornou as estimativas muito mais confiáveis. Falha comum de quem está começando nessa área. Também é frequente confundir correlação espúria com variação geográfica real. Duas variáveis podem parecer correlacionadas geographicamente apenas porque ambas seguem um gradiente comum, como altitude ou proximidade com litoral. Nesses casos, controlar pela variável de gradiente a saída correta em vez de adicionar camadas de complexidade ao modelo.
Quando esse tipo de abordagem falha
GWR não funciona bem com dados escassos em certas regiões. Se você tem cobertura abundante em centros urbanos e praticamente nada no interior, os coeficientesestimados para áreas rurais serão instáveis e pouco confiáveis. Nesse cenário, modelos hierárquicos com shrinkage bayesiano tendem a performar melhor porque compartilham informação entre regiões vizinhas de forma suavizada. Modelos espaciais também exigem dados de qualidade. Coordenadas imprecisas, limites municipais desatualizados ou inconsistências na agregação geográfica podem destruir a validade dos resultados. Antes de investir tempo em modelagem espacial, passe tempo validando a qualidade dos seus dados geoespaciais. Verifique projeções, sistemas de coordenadas e a consistência dos IDs de regiões ao longo do tempo. Se seu problema não tem nenhum padrão espacial detectável — o que testes como Moran's I podem confirmar rapidamente —, gastar recursos com modelagem espacial é desperdício. Aplique o teste primeiro. Se não houver autocorrelação espacial significativa, modelos tradicionais com controle por região fixa são suficientes e muito mais simples de manter.
Para datasets realmente grandes, como milhões de pontos de GPS, mesmo GWR otimizado pode levar horas ou dias. Nesse caso, aproximações como GWBR (Geographically and Temporally Weighted Regression) em versões vetorizadas ou métodos de amostragem estratificada por clusters espaciais são alternativas viáveis. Eu uso K-means com restrição de contiguidade espacial para dividir dados massivos em blocos gerenciáveis antes de aplicar modelos locais.
Galeria
-
Variação geográfica by Carol Silva on Prezi -
Variação geografica by Testedocapa Tuquetuque on Prezi -
Variação Geográfica Do Português | PDF | Português (idioma ...

