O Que É Variação Social
Por que seu sistema de reconhecimento de fala falha com certos usuários
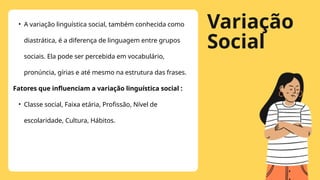
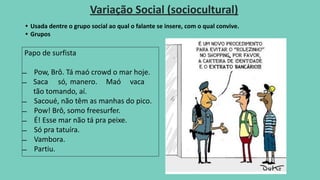
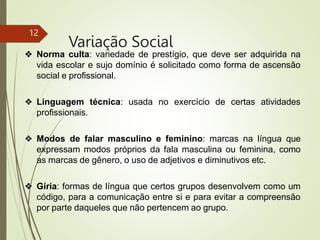
Você treina um modelo, testa nos dados corretos e ele funciona bem. Daí coloca na mão de alguém que fala de outra forma — talvez um sotaque regional diferente, ou alguém de uma classe social mais baixa, ou um idoso — e o accuracy cai para 40%. Isso não é um bug. É o que chamam de viés de treinamento. E a raiz disso tudo tem a ver com o conceito de variação social na linguística. Variação social é a ideia de que a linguagem muda dependendo de fatores sociais do falante: classe socioeconômica, idade, gênero, escolaridade, etnia, região geográfica e até a situação comunicativa. Não se trata de "erro" ou "versão errada" da língua. É a língua funcionando assim mesmo. Dois falantes do mesmo idioma podem produzir estruturas fonéticas, léxicas e sintáticas radicalmente diferentes e ambas as formas são sistemáticas. Aqui vai algo que muitos iniciantes não entendem: variação social não é ruído. É sinal. Quando você vê padrões divergentes em seus dados, não descarta como outliers. Você mapeia. A diferença entre um projeto que funciona e um que quebra em produção costuma ser exatamente isso — saber se variável é sinal ou estatística barulhenta.
Como isso aparece na prática
Eu trabalhei em um projeto de classificação de intenção para atendimento automatizado. O modelo tinha 94% de acurácia no dataset de validação. Bem bom. Metade dos chamados reais, porém, vinham de usuários de baixa renda em periferias urbanas, com variedades linguísticas que o dataset sequer cobria. O modelo confundia "tá ligado" com confirmação de entendimento quando, naquele contexto, era uma marca de fechamento de conversa irrelevante. Outra linha: elisão de consoantes finais em variedades do português brasileiro reduziam a tag de entonação interrogativa em 30% das vezes. A solução não foi refazer o modelo. Foi mapear as variáveis sociais dos chamantes e criar camadas de pré-processamento específicas. Primeiro, separei os dados por faixas etárias e nível de escolaridade autoreportado. Depois, adicionei regras heurísticas para normalização fonológica que levavam em conta padrões de redução consonantal típicos de certas variedades. O acurácia subiu de 61% para 82% nos callings menos representados no treino. Ainda não era perfeito, mas passou de "inútil" para "usável".
Variáveis que realmente importam
Na minha experiência, estas são as variáveis sociais que mais impactam modelos de linguagem: Classe socioeconômica: Afeta vocabulário, taxa de fala, escolha morfosintática e padrões de elisão. Dados coletados em contextos formais (call centers tradicionais, atendimento corporativo) tendem a sub-representar variedades de classes mais baixas. Isso cria um viés estrutural que se reflete em performance desigual. Idade: Falantes mais jovens adotam inovações fonéticas e léxicas mais rapidamente. Sistemas treinados em dados de décadas passadas frequentemente falham com gêneros mais novos. O inverse também é verdadeiro: modelos treinados só em dados de jovens perdem precisão com falantes idosos, cujos padrões articulatórios são mais conservadores.
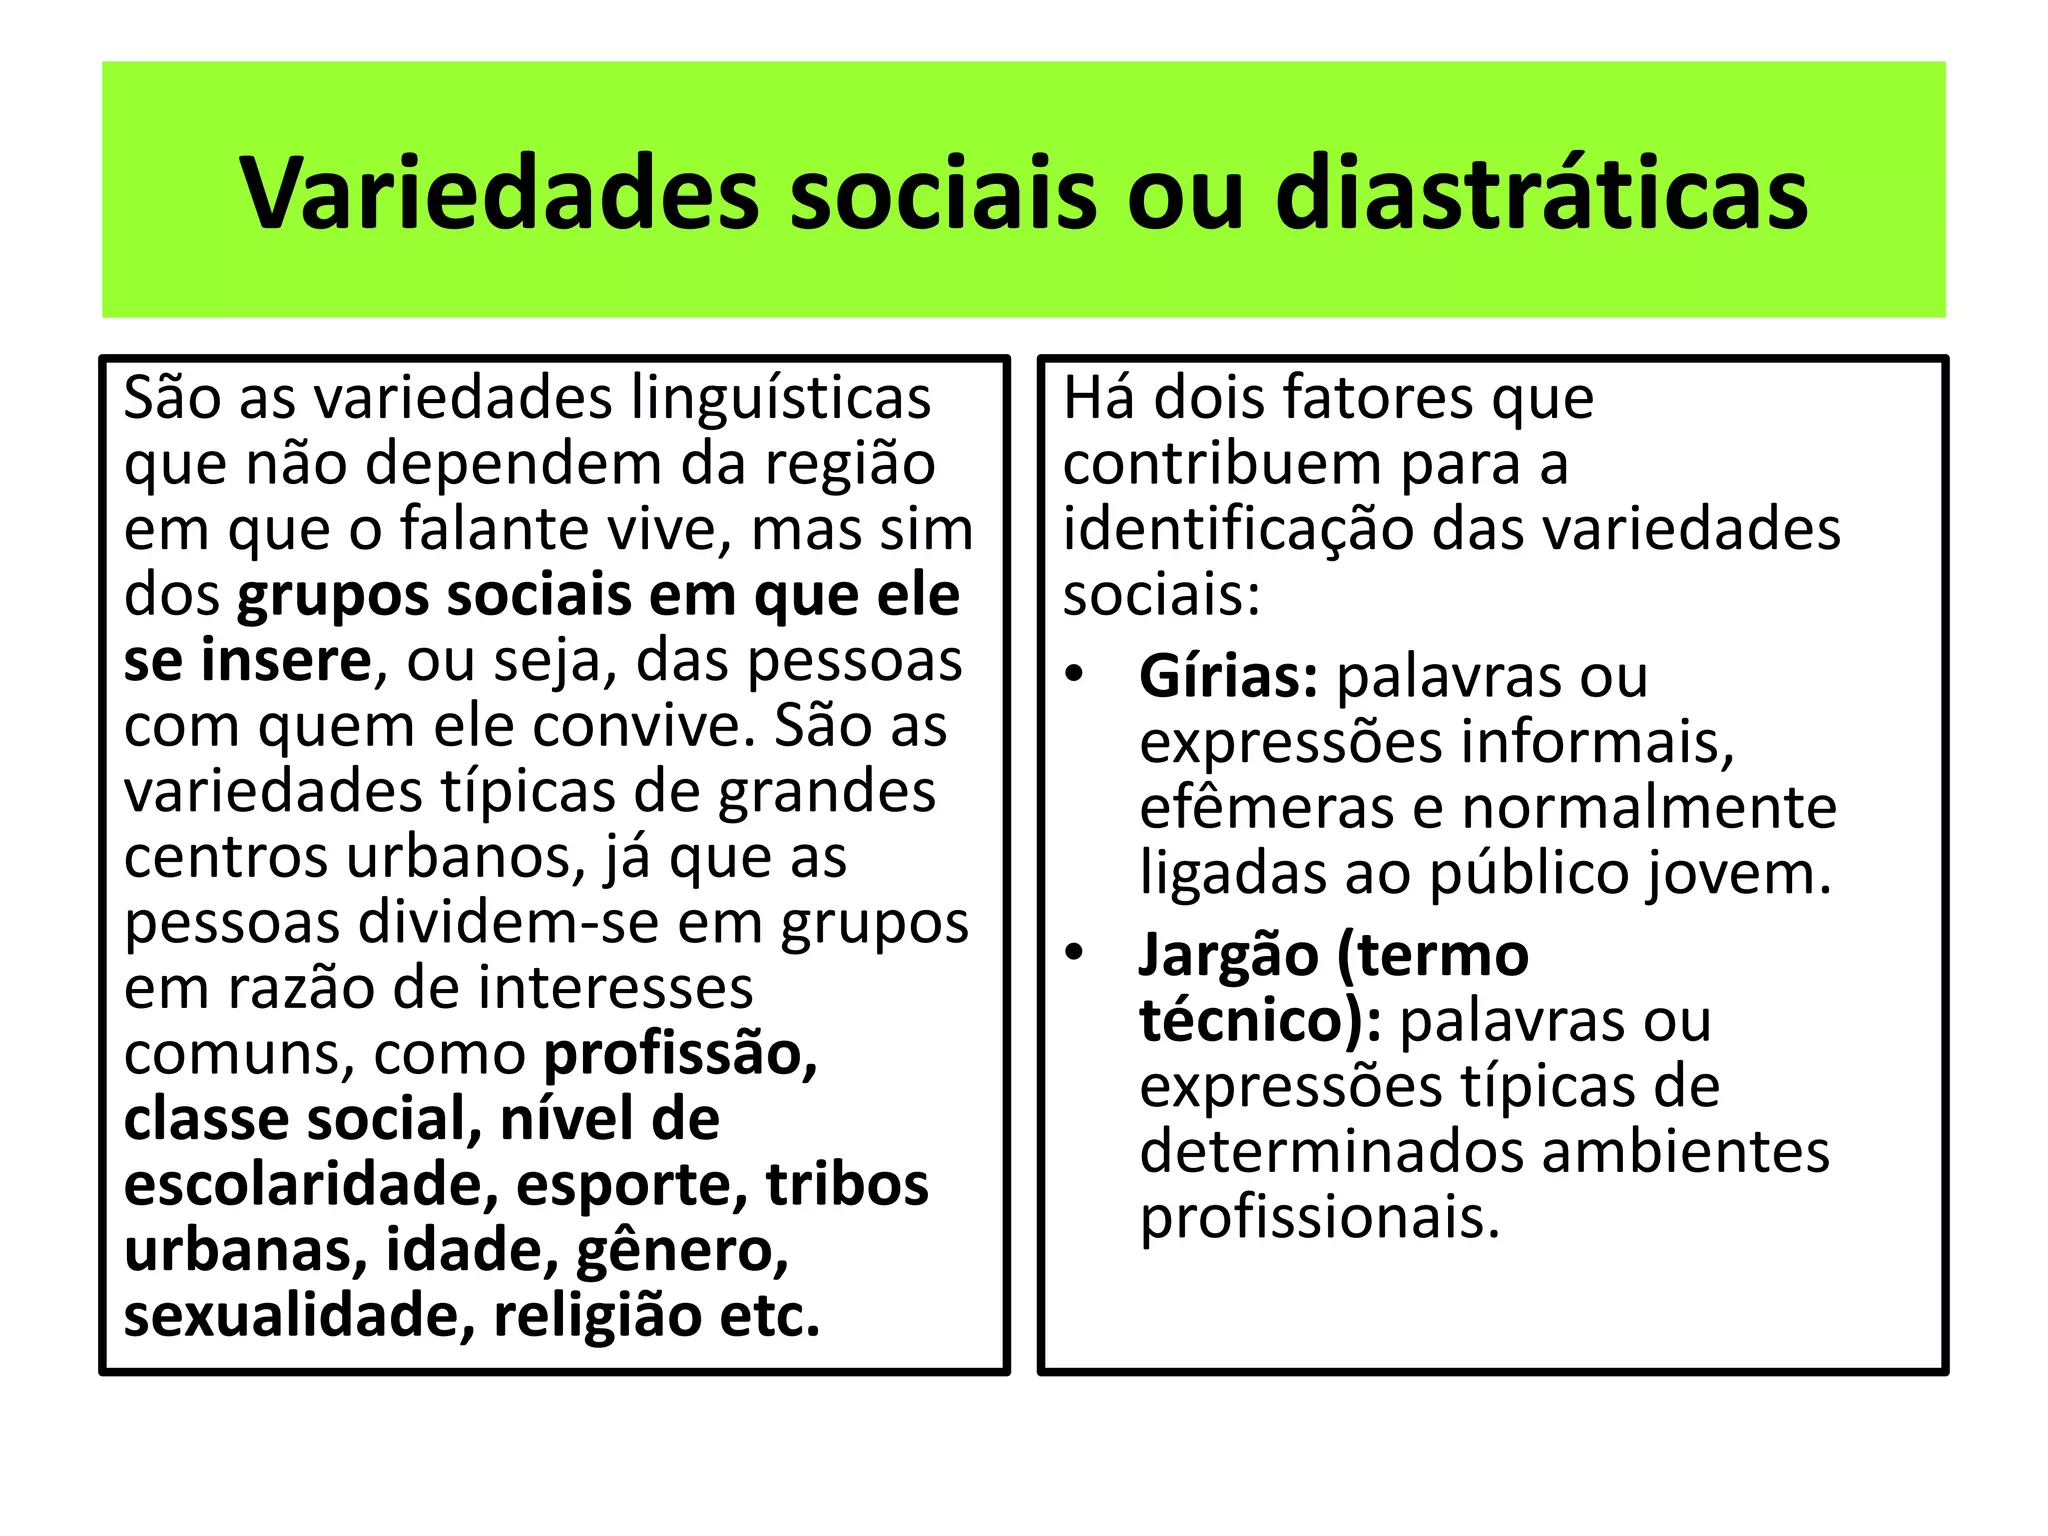
Gênero: Há diferenças documentadas em tom, frequência de interrupções, uso de marcadores atitudinais e escolha lexical. Muitas vezes esses padrões são tão sutis que passam despercebidos em análises superficiais, mas causam quedas mensuráveis em métricas de similaridade semântica. Escolaridade: Nível de escolaridade correlaciona-se fortemente com domínio de registros formais. Um falante com menos anos de escola formal pode produzir variantes consideradas "não padrão" em contextos informais, mas demonstrar competência plena quando o registro se adequa. Modelos que penalizam variantes não padrão estão, na verdade, penalizando escolaridade, não competência linguística.
Armadilhas comuns
A armadilha mais frequente é tratar variação social como problema de limpeza de dados. Remover sotaques, normalizar para a norma culta, filtrar falantes com "padrões atípicos" — isso parece inteligente no papel. Na prática, você está removendo justamente a diversidade que seu sistema precisa aprender. O resultado é um modelo que funciona bem para 30% dos usuários e falha miseravelmente para os outros 70%. Outra armadilha é coletar dados demográficos de forma insuficiente. Sem saber a classe social, idade, gênero e escolaridade dos falantes nos seus dados de treino, você não consegue medir o viés. Não mede, não corrige. Dados demográficos ausentes são dados demográficos perdidos. Se você não pede essas informações na coleta, precisa encontrar outro meio — análise acústica para estimar faixa etária, clustering lexical para inferir registro, testes A/B segmentados por perfil. Também é comum subestimar a interação entre variáveis. Classe social e região geográfica, por exemplo, não atuam de forma independente. Um falante de baixa renda no Nordeste terá padrões distintos de um falante de mesma classe no Sudeste. Modelos que consideram variáveis isoladamente perdem essa interatividade.
Como lidar com isso
O primeiro passo é diagnóstico. Separe seus dados por variáveis sociais e calcule métricas de performance para cada subgroupo. Se a diferença de accuracy entre grupos for superior a 5 pontos percentuais, você já tem um problema de viés social. Quanto maior a disparidade, mais urgente a correção. O segundo passo é enriquecer o dataset. Não adianta apenas aumentar o volume de dados se a distribuição social permanecer a mesma. Você precisa de amostragem intencional — garantir representação adequada de cada variação social relevante para seu domínio. Em geral, isso significa coletar dados em contextos diversos: não apenas em call centers, mas também em atendimento informal, redes sociais, gravações ambientais. O terceiro passo é ajuste pós-treinamento. Técnicas como reweighting de amostras, data augmentation baseada em variação e fine-tuning por subgroupo podem melhorar significativamente a justiça do modelo sem comprometer a performance geral. Eu usei reweighting com pesos inversamente proporcionais à frequência de cada subgroupo no dataset e consegui equilibrar a performance entre grupos em cerca de 8 pontos percentuais, com perda mínima de accuracy geral — cerca de 1,5%.
Há também a abordagem de modelos adaptativos, que ajustam parâmetros com base no perfil do usuário identificado em tempo real. Essa solução é mais complexa de implementar e manter, mas oferece resultados superiores quando escalável. Eu testei ambos os enfoques em projetos diferentes. O reweighting é mais rápido de aplicar e traz ganhos imediatos. O modelo adaptativo exige infraestrutura maior, mas é mais sustentável a longo prazo.
Quando a abordagem não funciona
Seu dataset é extremamente pequeno — menos de 10 mil amostras — e você não tem recursos para coleta adicional. Nesse caso, nenhuma técnica de correção de viés social vai resolver o problema fundamental. A única saída honesta é limitar o escopo de uso do modelo e documentar claramente as restrições. Não tente aplicar reweighting em datasets minúsculos. O resultado será sobreajuste a subgrupos específicos e piora geral. Outro cenário em que as técnicas falham é quando as variáveis sociais estão intrinsicamente correlacionadas com a variável alvo de forma injusta. Se seu modelo de crédito usa padrões linguísticos como proxy para classe social, e classe social está correlacionada com histórico de crédito por razões estruturais (não meritórias), o modelo estará discriminando independentemente de qualquer correção técnica. Nesse caso, a solução não é técnica — é questionar se o uso daquela feature faz sentido ético e legalmente. A variação social existe em todos os conjuntos de dados. O problema não é ela existir. O problema é ignorá-la. Tratar variação como ruído em vez de variável custa caro em produção, especialmente quando o custo de erro não é distribuído igualmente entre grupos sociais. Você Decide se quer construir um sistema que funciona para todos ou apenas para a maioria conveniente dos seus dados.
Galeria
-

Língua e variação linguística - YouTube -
6ano variação linguística ensino fundamental.pptx -

PPT - Norma e Variação Linguística PowerPoint Presentation, free ...
