O Que Não É Prescindível
O que é imprescindível quando o sistema cai às três da manhã
A maioria das pessoas acha que indispensable significa "coisa útil". Na prática, indispensável é o que te impede de ir dormir e lidar com uma ligação de um cliente às três da manhã. Vou falar de logstash, filebeat e elasticsearch, ou seja, o stack ELK de observabilidade. Não é novidade. É o que funciona. Quando eu cheguei em uma empresa no início dos anos 2020, tínhamos um serviço de pagamentos que tinha 47 logs espalhados por 12 containers. Sem estrutura. Quando a receita ficava lenta, ninguém sabia onde procurar. Eu passei três dias rastreando transações manual. Foi a melhor aula que tive sobre o que não é prescindível em monitoramento.
O que não é prescindível no stack ELK
Vamos direto. Você precisa de quatro coisas, nessa ordem. Se faltar uma, o resto não funciona direito. Primeiro: o filebeat como agente leve. O filebeat roda dentro do container ou na máquina hospedeira. Ele lê os logs de texto puro, adiciona metadados de contexto — nome do container, ID da instância, namespace do Kubernetes — e encaminha para o Elasticsearch ou para um Logstash intermediário. A diferença entre usar filebeat ou mandar direto pro ES é ridícula. O filebeat normaliza os campos. Sem normalização, você gasta mais tempo limpando dados do que analisando. Segundo: um índice com lifecycle gerenciado (ILM). Eu vi gente criar índices manualmente todos os dias. Isso é erro grave. O ILM move índices quentes para dados e depois para frio automaticamente. Configure uma política de rollover baseada em tamanho ou tempo. Um índice que cresce sem parar vai quebrar seu cluster quando passar de 50GB. Eu perdi dois nós de dados num estouro assim. Desde então, rollover a cada 20GB ou 24 horas é regra.
Terceiro: dashboards que respondem perguntas reais. Não adianta ter dados se ninguém sabe o que olhar. Um dashboard de latência p99 de requisições externas já resolve 80% dos incidentes. A métrica p99 é mais honesta que a média. A média esconde caudas longas que matam produção. Quarto: alertas com sensatez. O maior erro que eu vejo é configurar alertas para tudo. Seu time vai saturar e começar a ignorar. Defina um threshold de 4 horas de atraso no envio de logs do filebeat como critério de alerta, não o volume de requisições por segundo. Se o log para de chegar, algo está errado. Se o volume sobe, pode ser normal.

Como configurar na prática
Vou dar um exemplo concreto. Suponha que você tenha um serviço Node.js rodando em Kubernetes e quer enviar logs para o Elasticsearch. Crie o deployment do filebeat como daemonset no cluster. O daemonset garante que uma instância rode em cada nó. No arquivo de configuração do filebeat, defina os inputs para ler os arquivos de log do container pelo path /var/log/containers/*.log. Adicione os processors do kubernetes para enriquecer automaticamente com labels e namespace. Isso elimina a necessidade de injetar variáveis de ambiente em cada serviço. No Elasticsearch, crie o index pattern com base no campo @timestamp. Configure o ILM policy com as fases hot, warm, frozen e delete. Um cluster de três nós master, cinco dados e dois ingest funciona bem para volumes até 2TB por dia. Acima disso, considere separar os nós de ingest do cluster de dados.
Uma coisa que ninguém conta: o Elasticsearch usa Lucene por baixo. Lucene não gosta de campos com muitas palavras únicas em text mapping. Se você enviar headers HTTP brutos como campo texto, seu índice vai inflar rápido e as queries vão ficar lentas. Filtre os headers antes de indexar ou use keyword mapping com limitação de tamanho.
A parte que ninguém gosta de ouvir
O stack ELK não é solução mágica. Ele consome recursos significativos. Cada GB de logs por dia exige cerca de 10GB de disco diário no Elasticsearch, sem contar replicação. Armazenar logs por mais de 90 dias em alta granularidade é gasto desnecessário na maioria dos casos. O custo de armazenamento em nuvem com ES gerenciado (AWS OpenSearch, Elastic Cloud) pode sair entre 800 e 2500 dólares mensais para middle-scale. Se seu volume é baixo e sua necessidade é apenas debug, considere alternatives como Loki do Grafana. O Loki é mais barato porque não indexa o conteúdo dos logs, apenas metadados. Ele indexa labels e busca por texto usando chunking. A desvantagem é que queries complexas de agregação são mais lentas. Para análise de padrões, o ES ainda vence. Também tem o caso específico que me pegou desprevenido: logs em JSON com campos aninhados. O Elasticsearch mapeia automaticamente campos aninhados como flattened por padrão em versões recentes, o que quebra buscas por campos específicos. Você precisa definir o mapeamento manualmente ou usar o ILM com template dinâmico para forçar object mapping nos campos que realmente importa. Perdi meio dia debugando queries que retornavam zero resultados porque o campo estava flattened sem eu saber.

O que realmente não é prescindível
O básico funciona. Filebeat coleta, Elasticsearch armazena e indexa, Kibana mostra. O resto é refinamento. Comece com isso. Meça o volume real de logs por semana antes de dimensionar o cluster. Um erro comum é provisionar para pico e pagar ocioso por meses. Eu scalei um cluster de 12 nós para 4 e reduzi custo em 60% sem perder visibilidade. O que eu aprendi na prática é que a complexidade aparece depois, não antes. Implemente simples. Adicione complexidade só quando um incidente real justificar. A maioria dos times adiciona complexidade por medo e depois não consegue manter. Logs não mentem. A infraestrutura que os carrega também não deveria.
Galeria
-
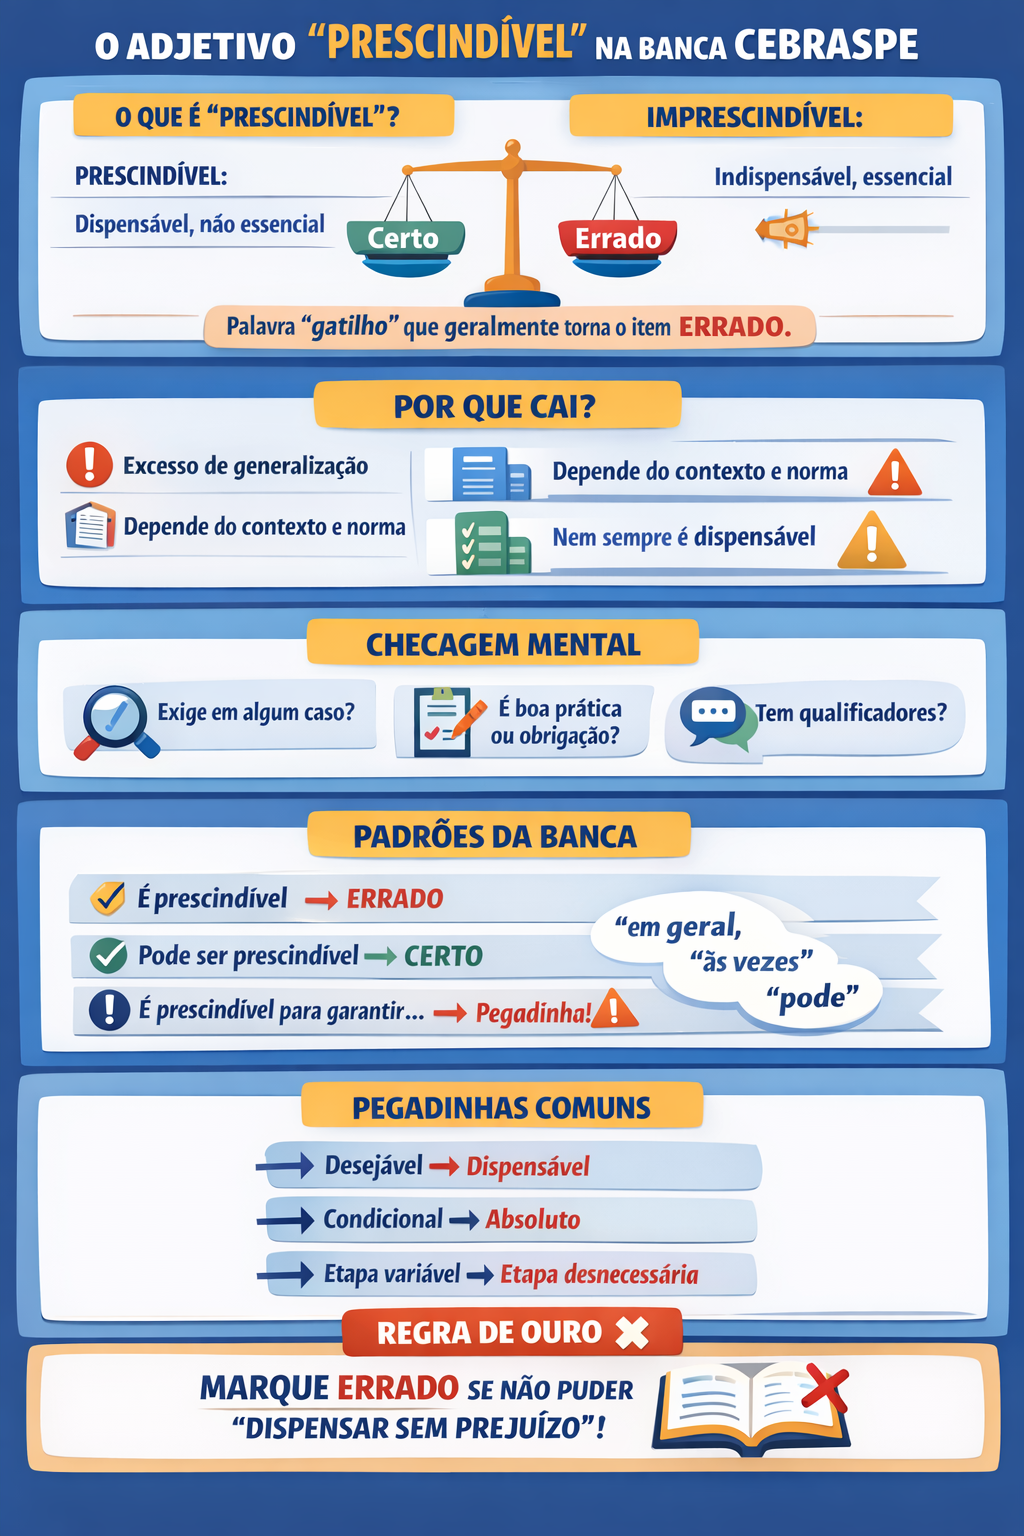
CEBRASPE e o adjetivo prescindível | Professor Rogerão Araújo -

Prescindível x Imprescindível #gramática #português #palavras # ... -
Significado de Prescindível - Diciteca
