O Que O Recurso Divisão De Ia Faz

Entendendo o recurso de divisão por IA
O recurso de divisão de IA é uma funcionalidade que usa modelos de inteligência artificial para automatizar a separação, segmentação ou distribuição de dados, conteúdos, tarefas ou recursos. Em vez de depender de regras manuais ou divisões rígidas definidas por humanos, o sistema analisa padrões e toma decisões sobre como dividir automaticamente. Isso aparece com frequência em ferramentas de processamento de dados, plataformas de educação, softwares de gestão de projetos e editores de conteúdo. O princípio básico é o mesmo: ingestão de material bruto, classificação por critérios que o modelo aprende, e saída organizada em grupos ou partes distintas.
O que o recurso divisão de ia faz na prática
Vou direto ao ponto. Quando você ativa a divisão por IA, o sistema processa seu material de entrada — possa ser um conjunto de dados, textos longos, imagens ou até mesmo arquivos de áudio — e o divide em segmentos baseados em similaridade, temas, complexidade ou qualquer critério que o modelo reconheça. A saída costuma vir em formato de grupos, subarquivos ou seções rotuladas automaticamente. Em plataformas educacionais, por exemplo, o recurso pode pegar um curso inteiro e dividi-lo em módulos ou lições menores com base na carga cognitiva percebida de cada trecho. Em processamento de dados, pode separar um dataset grande em lotes de treino, validação e teste de forma mais inteligente do que uma divisão aleatória simples, respeitando a distribuição das classes. Já trabalhei com isso em um projeto onde tínhamos cerca de 40 mil registros de atendimento ao cliente e precisávamos segmentá-los por tipo de problema para treinar um modelo de classificação. A divisão manual levaria dias. Com o recurso de divisão por IA, o sistema agrupou os registros por similaridade semântica em cerca de 12 categorias coerentes, e o processo inteiro levou aproximadamente 20 minutos em vez de dois dias de trabalho manual.
O funcionamento técnico por trás costuma envolver embeddings gerados por um modelo de linguagem ou rede neural, clustering (como K-means ou DBSCAN) aplicado a esses embeddings, e depois a atribuição de cada item a um cluster ou faixa específica. Alguns sistemas mais avançados ainda permitem ajuste fino dos parâmetros de divisão — número de grupos, sensibilidade ao critério de similaridade, e pesos para diferentes características. Uma coisa que poucos explicam e que causou problema pra mim é o efeito de cluster desbalanceado. No projeto mencionado, uma das categorias acabou com 60% dos registros porque os dados de entrada tinham uma distribuição naturalmente enviesada. A divisão tecnicamente funcionou, mas o resultado não era útil para o treinamento do modelo. A solução foi ajustar o parâmetro de balanceamento do clustering e aplicar oversampling selecional nos grupos menores depois. Sem esse ajuste, a divisão por IA sozinha gera grupos que refletem viés existente nos dados, não uma divisão justa ou equilibrada. Outro ponto importante é que o recurso não substitui a definição dos critérios de divisão. A IA decide como agrupar com base no que ela entende dos dados, mas quem define o que faz sentido dividir — seja por tema, por dificuldade, por tamanho, por período — continua sendo o operador humano. Colocar um lote de arquivos e esperar que a ferramenta faça a segmentação perfeita sem nenhuma orientação prévia raramente funciona na prática.

Se você está avaliando usar esse recurso, aqui vão algumas observações diretas. Verifique se a ferramenta permite exportar os critérios usados na divisão, caso contrário você fica com grupos prontos mas sem saber o porquê de cada separação. Teste com um subconjunto pequeno dos seus dados antes de rodar o lote completo — o tempo de processamento varia bastante dependendo do volume, e em datasets grandes pode levar de 30 minutos a várias horas dependendo da infraestrutura disponível. E sempre revise manualmente pelo menos 5% dos grupos resultantes para validar se a lógica de divisão faz sentido para o seu caso específico. A divisão por IA também tem limitações claras. Funciona mal quando os dados de entrada são muito heterogêneos ou quando há sobreposição significativa entre as categorias pretendidas. Se você tentar dividir textos jurídicos junto com receitas de culinária esperando que o sistema crie grupos coesos, o resultado será confuso. A IA não tem contexto do domínio a menos que você o forneça explicitamente. Para casos onde a divisão automática não entrega resultados satisfatórios, uma alternativa viável é combinar a divisão por IA com regras manuais pós-processamento. Você deixa o modelo fazer o trabalho pesado de agrupamento inicial e depois ajusta os limites dos clusters conforme a necessidade real do projeto. Isso geralmente produz resultados melhores do que confiar 100% na automação ou fazer tudo manualmente desde o início.
Em resumo, o recurso é útil quando você tem volume suficiente de dados para justificar a automação e critérios de classificação razoavelmente claros. Não é bala de prata, mas economiza tempo significativo na etapa de preparação que normalmente consome a maior parte do ciclo de qualquer projeto que envolva segmentação.
Galeria
-

O que é IA agêntica? Veja como funciona a IA focada em tomada de ... -
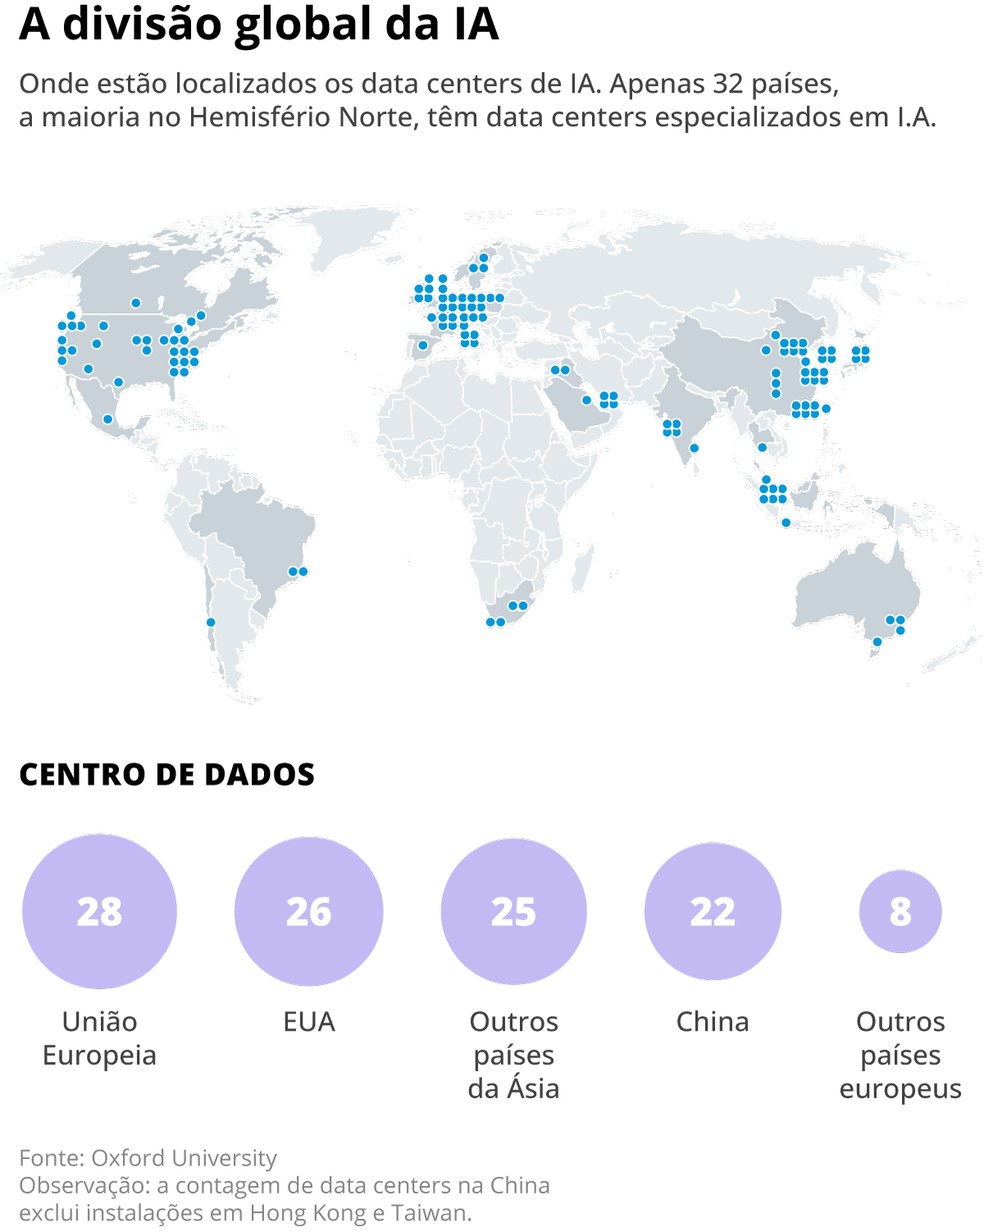
Corrida pela IA provoca nova divisão no mundo: os que têm acesso à ... -
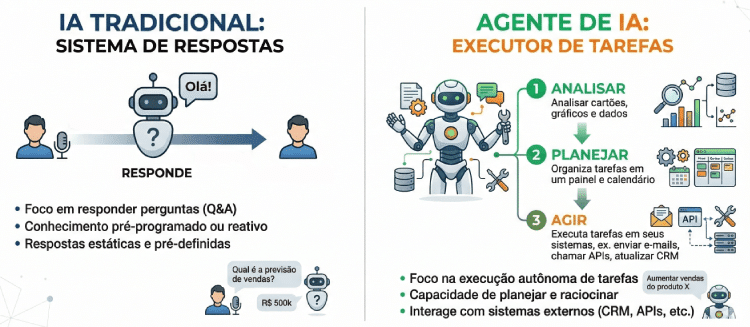
Agentes de IA: o que são, exemplos e como otimizar sua equipe -
🚨 17 novas funções de IA que todos deveriam estar discutindo Estamos ...

