O Que Pode Ter Acontecido

Investigando o que pode ter acontecido: um guia prático de debugging
Quando algo quebra em produção e você precisa descobrir o que pode ter acontecido, o processo não é mágica. É uma sequência de eliminação sistemática, coleta de evidências e, muitas vezes, uma dose razoável de frustração. Vou explicar como isso funciona na prática, com exemplos reais e armadilhas que eu vi gente cair repetidamente. A primeira coisa que a maioria das pessoas faz errado é começar a alterar código ou configs no escuro. Isso só piora. O correto é congelar o estado atual, tirar snapshots ou backups, e só aí começar a investigator. Eu vi times inteiros perderem dias Porque alguém reiniciou um serviço sem antes capturar o estado dos processos e logs ativos. A memória volátilSome, os arquivos temporários vão embora, e você perde a única evidência que poderia ter mostrado o que causou o problema. O que pode ter acontecido raramente é a causa óbvia. Na minha experiência, as raízes mais comuns envolvem dependências silenciosas: uma biblioteca que fez update automático, uma configuração de timeout que mudou por padrão em uma versão nova, ou um limite de recursos do servidor que foi atingido de forma gradual ao longo de semanas até que um evento específico disparou a falha.
Método prático: reconstrução cronológica dos eventos
O método que eu uso sempre segue estes passos, na ordem: 1. Coleta de linha do tempo. Reúna todos os logs relevantes (app, sistema, rede, banco de dados), metricas de performance nos minutos antes e durante a falha, e mudanças recentes no ambiente. Anote os horários exatos. Uma planilha simples com timestamp, fonte do log, e tipo de evento já é suficiente para começar. 2. Isolamento do ponto de ruptura. Identifique o primeiro sintoma anômalo. Não o primeiro erro que o usuário vê — esse geralmente é consequência, não causa. Vá até o log mais baixo na stack que mostra algo fora do normal. Tempo de resposta subindo abruptamente, conexão sendo rejeitada, requisições ficando em estado pendente. Esse é seu marco zero.
3. Hipóteses e teste de eliminação. Para cada possibilidade plausível, busque evidência que confirme ou refute. Não tente provar que sua hipótese está certa. Tente provar que ela está errada. Se você não consegue refutar uma hipótese com os dados disponíveis, anote como incerta e siga para a próxima. 4. Reprodução controlada. Se possível, reproduza o problema em ambiente isolado. Isso é diferente de simular — você quer que o sintoma apareça de novo, exatamente como aconteceu, para poder observar o que está acontecendo durante o evento.

Um caso real que demorou três dias para resolver
Um serviço nosso começou a responder com timeout aleatoriamente, apenas em certas horas do dia. Os logs de aplicação não mostravam nada anormal. O banco de dados parecia estar respondendo dentro do esperado. Monitoramento de CPU e memória também estava dentro da norma. Por três dias, rodamos em círculos. A causa raiz foi um job de backup que rodava diariamente às 2h da manhã e travava discos com I/O prioritário, afetando as queries do serviço principal. O backup não deixava erro nenhum — funcionava perfeitamente. Só consumia 100% de I/O write por cerca de 15 minutos, e nesse período as requisições do app morriam nos timeouts configurados no load balancer. Como o problema era intermitente e só ocorria nessa janela, ninguém estava olhando para I/O do disco na análise inicial. A solução foi ajustar a prioridade de I/O do processo de backup e mudar seu horário para um período de menor tráfego. O diagnóstico leve três dias porque nenhuma ferramenta padrão de monitoramento de aplicação mostra I/O pressure como primeiro indicador. Leva três dias porque eu não pensei em verificar isso logo de início. A lição prática: quando o app parece saudável mas falha de forma intermitente, olhe para fora da aplicação primeiro. Disco, rede, sistemas externos.
Pegadinhas que todo mundo comete
Existem alguns erros recorrentes que atrapalham a investigação mais do que ajudam. O principal é confiar cegamente em ferramentas de monitoramento que agregam dados em médias. Um pico de latência de 5 segundos que dura 30 segundos pode aparecer como um aumento de 200ms na média horária e passar totalmente despercebido. Sempre olhe os dados brutos, não os agregados. Dashboards bonitos escondem problemas. Outro erro comum é assumir que porque algo "sempre funcionou", não poderia ser a causa. Mudanças sutis em dados, volume crescente, comportamentos de usuários diferentes — tudo isso pode fazer um sistema que sempre rodou bem parar de funcionar sem nenhuma mudança aparente no código ou configuração. Volume de dados é particularmente traiçoeiro porque cresce devagar o suficiente para ninguém notar até o dia em que uma query que levava 50ms passa a levar 8 segundos.
Ferramentas úteis e suas limitações
Para coleta de logs, FLS e GoAccess são sólidos para análise rápida. Para tracing distribuído, strongJaeger e Zipkin cobrem bem a maioria dos casos, mas têm overhead significativo em ambientes de alta carga — meu conselho é usá-los em ambientes de staging primeiro para calibrar o impacto antes de colocar em produção. Para análise de sistema, eBPF via ferramentas como bpftrace ou bcc é extremamente poderoso mas tem curva de aprendizado íngreme; para investigação rápida de production issues, strace e wracking continuam sendo mais práticos apesar de menos elegantes. Nenhuma dessas ferramentas é suficiente sozinha. O valor está em cruzar dados de múltiplas fontes. Um log de erro isolado pode não dizer nada. O mesmo log correlacionado com um pico de connections no banco, um spike de I/O e uma deploy recente na mesma janela de tempo conta uma história clara.

Quando desistir e chamar alguém mais especializado
Às vezes o problema não está no que você tem acesso. Kernel patches, bugs em drivers de rede, problemas de hardware intermitente em discos ou memória — esses cenários exigem profissionais com acesso a ferramentas que times de aplicação normalmente não possuem. Se você já percorreu os quatro passos do método acima e ainda não encontrou a causa, o tempo que passa insistindo sozinho é tempo perdido. Documente tudo o que investigou, encaminhe as evidências coletadas, e deixe que especialistas em infraestrutura ou SRE avancem a partir daí. Manter um registro de cada incidente resolvido — com a causa raiz, o que levou ao diagnóstico correto, e o que foi distração — constrói um knowledge base que reduz drasticamente o tempo de resolução nos próximos incidentes. Eu mantenho um documento simples com data, sintomas, hipóteses descartadas, e causa final. Depois do quinto ou sexto incidente documentado, você começa a reconhecer padrões que antes passavam despercebidos.
Galeria
-

Meu Deus O Que Pode Ter Acontecido Karen Bachini GIF - Meu Deus O Que ... -

O que pode ter acontecido com baleia encalhada que surpreendeu ... -
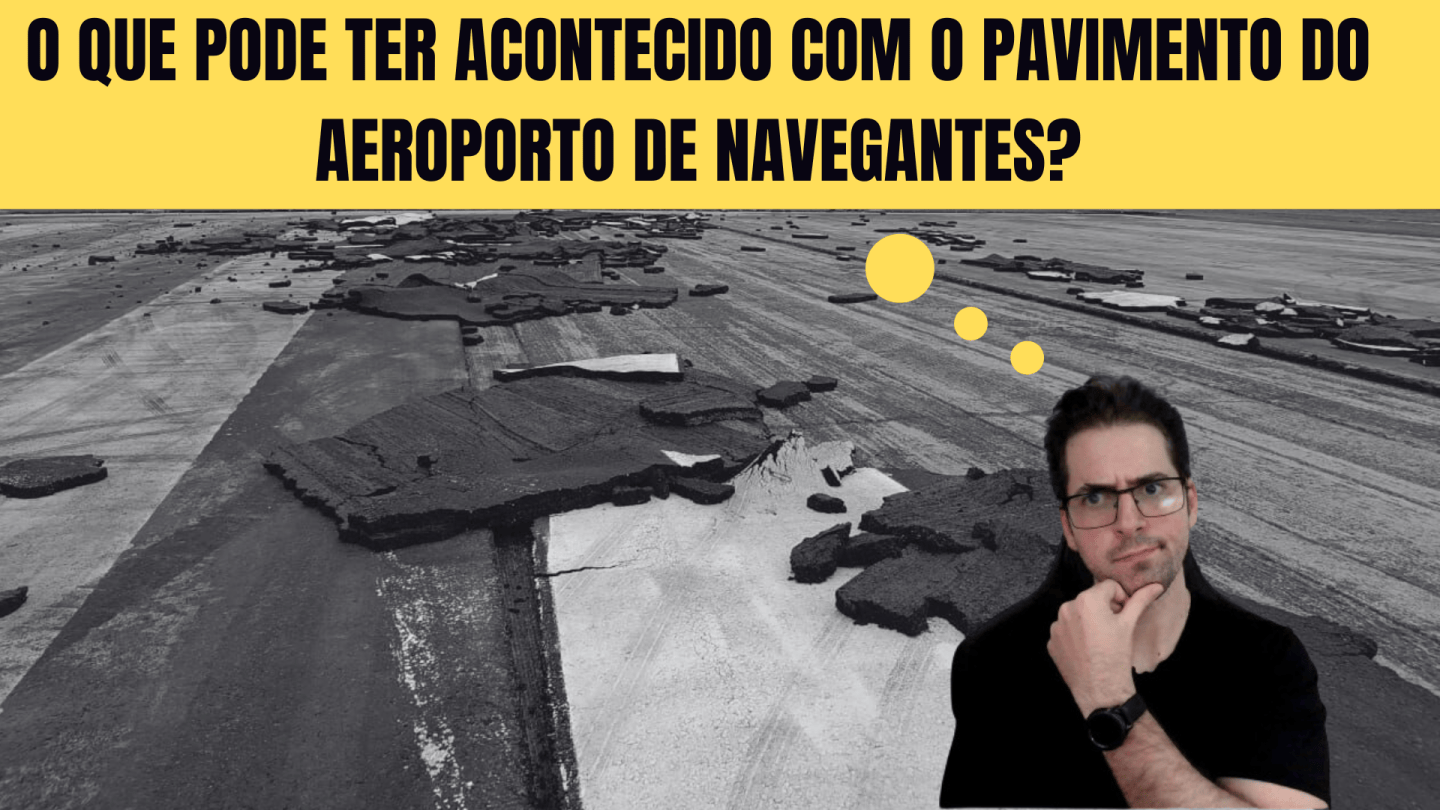
Entenda o que pode ter acontecido com o pavimento no Aeroporto de ...
