O Que São Árvores Filogenéticas

Como interpretar e construir árvores filogenéticas na prática
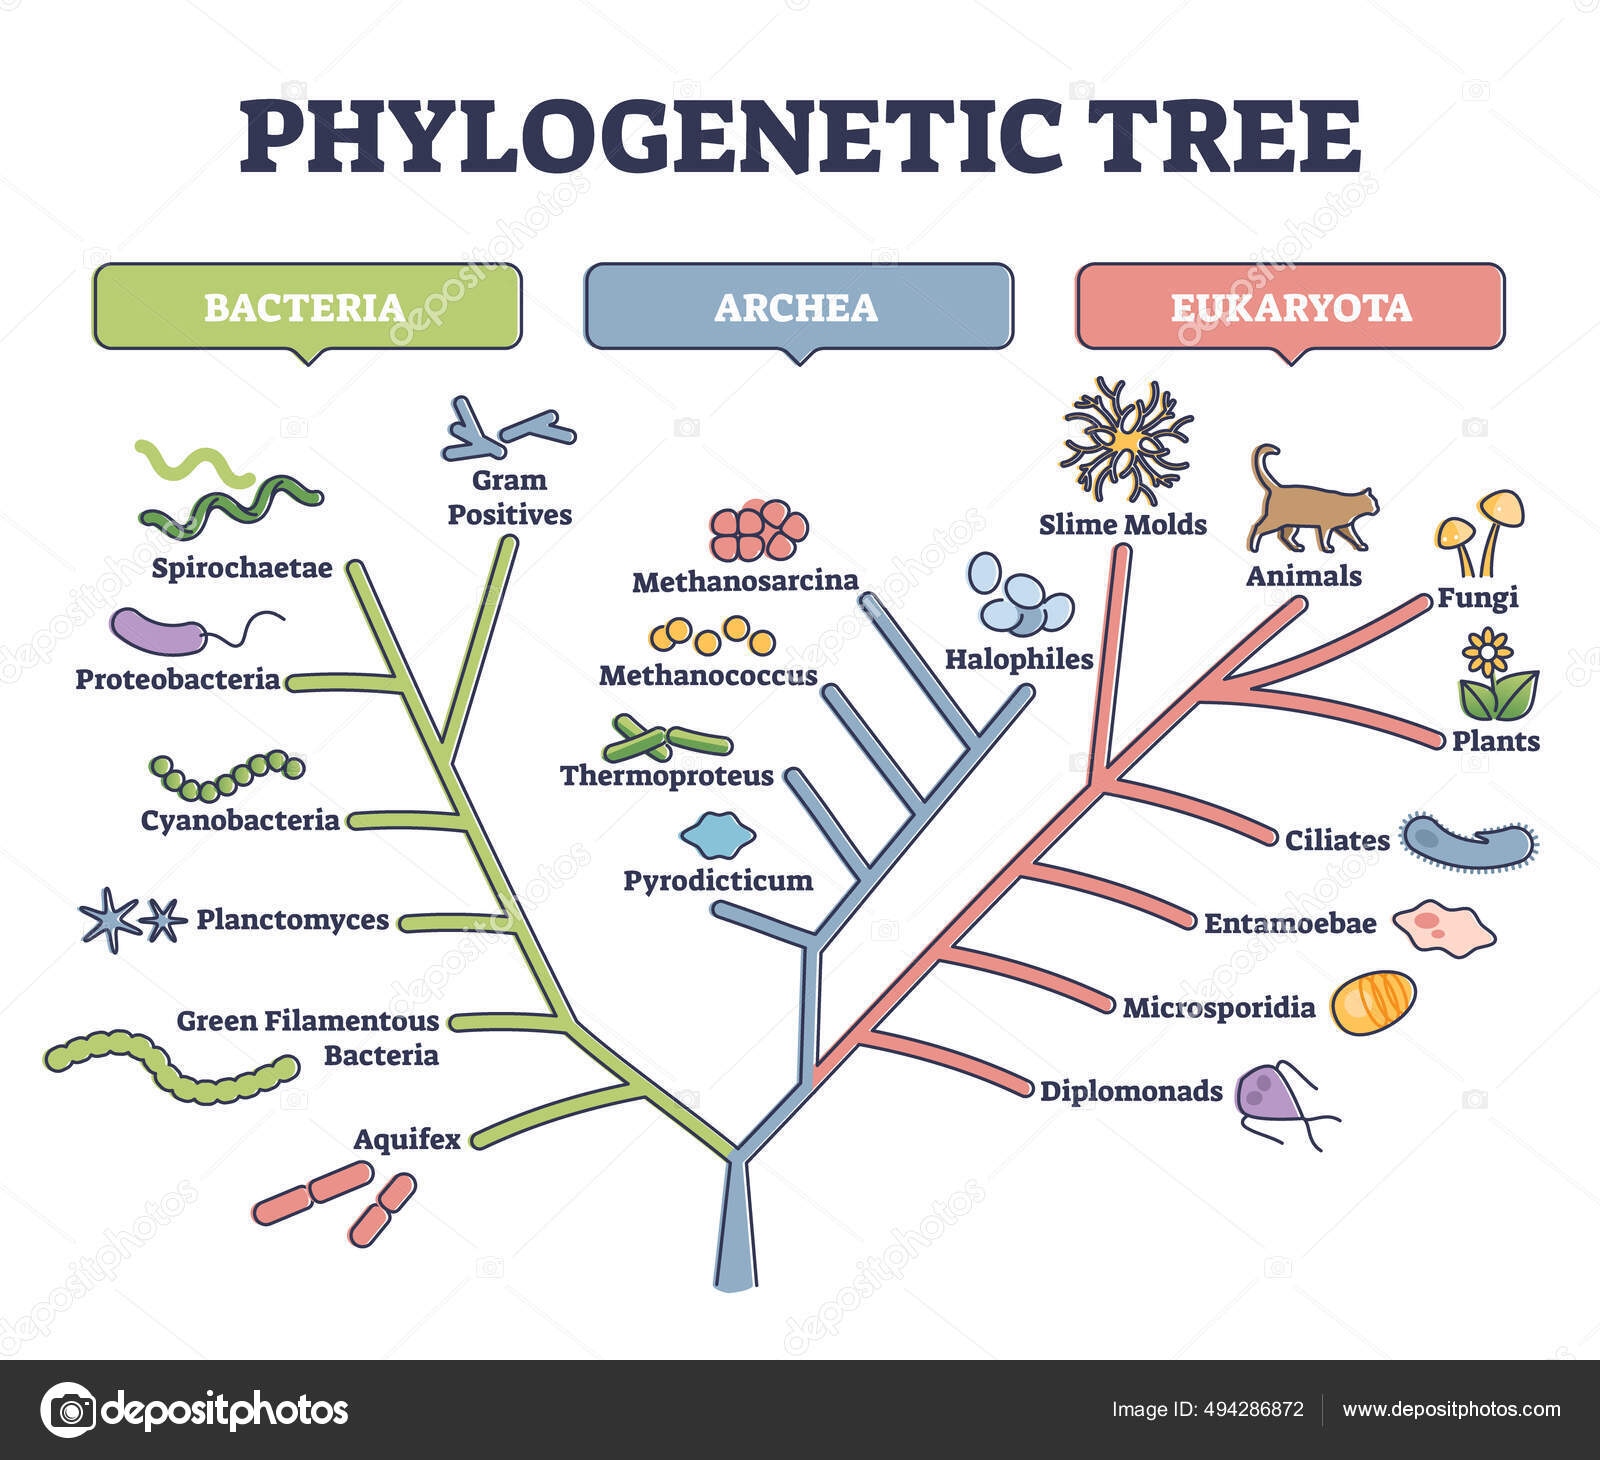
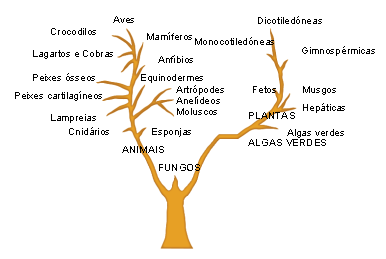
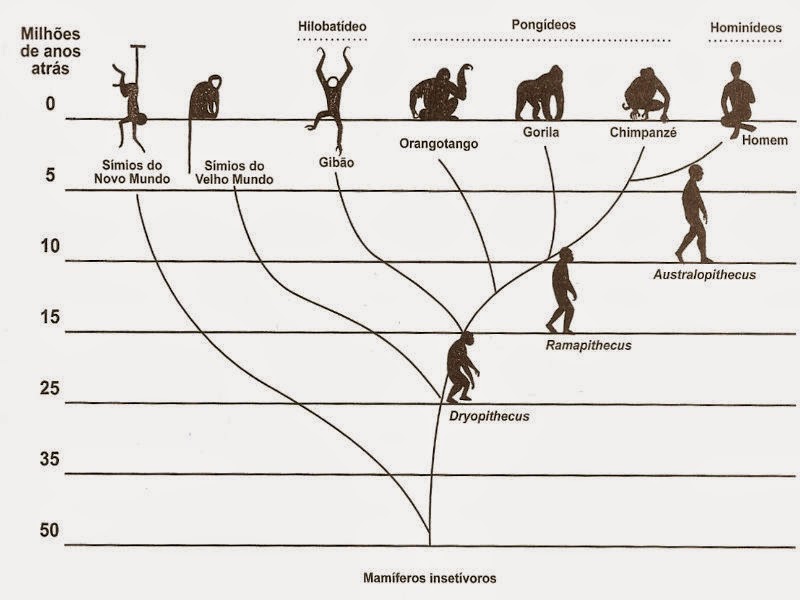
Quando você abre um artigo de sistemática e vê aquela diagrama ramificado com espécies e valores de bootstrap, a primeira reação é tentar traduzir tudo de uma vez. Eu já levei horas pra entender que a árvore não é um retrato da natureza, é uma hipótese estatística construída a partir de dados que muitas vezes são incompletos. O ponto de partida certo é perguntar o que são árvores filogenéticas antes de qualquer coisa, mas a resposta real está em como elas são geradas, não no dicionário. Uma árvore filogenética é uma representação gráfica das relações evolutivas entre organismos ou sequências. Os nós representam ancestrais hipotéticos, os ramos indicam linhagens e o comprimento das arestas pode corresponder à quantidade de mudança evolutiva, seja em substituições por sítio ou em tempo estimados. Isso parece simples até você tentar reconstruir algo com dados reais. Aí percebe que existem pelo menos três modelos de caráter, cinco algoritmos de inferência e meia dúzia de criticidades que todo mundo ignora no começo. O método mais comum ainda é a máxima verossimilhança (ML). Você pega um alinhamento, escolhe um modelo de substituição — GTR+G+I costuma ser um ponto razoável de partida, mas não é universal — e deixa o programa iterar. Tempo de processamento varia muito: com 50 sequências e 1500 sítios em um notebook decente, fica pronto em minutos; com 500 sequências, vira questão de horas ou dias dependendo da arquitetura.
O problema que ninguém conta
Eu passei três semanas tentando resolver uma árvore de fungos com dados ribossomais. O algoritmo agrupava duas linhagens que sabíamos, por fisiologia e ecologia, que não eram próximas. A raiz caía em um lugar completamente errado. O problema não era o software, era a composição base desbalanceada: uma linhagem tinha riqueza de GC bem maior que as outras, e o modelo padrão de substituição tratava tudo como se fosse homogêneo. A solução foi rodar uma análise com modelo CAT-GTR no PhyloBayes, que lida com heterogeneidade composicional, e a topologia finalmente fez sentido biológico. Sem esse ajuste, a árvore parecia boa nos valores de suporte, mas estava enganosa. Esse é um erro clássico. Bootstrap alto não significa verdade. Pode significar apenas consistência interna dentro de um modelo inadequado. Valores de 95% ou mais são confortáveis, sim, mas se o modelo está errando pressupostos fundamentais, o suporte é falso positivamento confiável.
Passo a passo operacional
O fluxo real funciona assim. Primeiro você reúne as sequências e faz o alinhamento. Tools como MAFFT ou MUSCLE entregam resultados decentes na maioria dos casos, mas alinhamentos mal feitos contaminam tudo que vem depois. Eu costumo revisar manualmente com AliView, cortando regiões de baixa confiança que geram ruído nas branches. Isso gasta tempo, mas evita artefatos topológicos que aparecem só porque o algoritmo tentou forçar compatibilidade onde não existia informação. Depois vem a escolha do modelo. ModelFinder do IQ-TREE faz isso automaticamente com base no BIC. Leva segundos e é confiável na maior parte das vezes. Se você está trabalhando com dados de transcriptoma ou genoma completo, talvez queira rodar também com o AICc pra comparar. A diferença entre BIC e AICc pode alterar o modelo escolhido, e isso muda o resultado final em analyses sensíveis. A inferência em si roda no IQ-TREE, RAxML-NG ou PhyML. Para bootstrap, use pelo menos 1000 réplicas. Menos que isso dá números instáveis; mais que 1000 melhora pouco a estabilidade e custa proporcionalmente mais tempo computacional. Se o orçamento de hardware for apertado, uma opção válida é o SH-aLRT, que é mais rápido e costuma ter boa correlação com bootstrap tradicionais, embora não seja equivalente.

Visualização vem por último. FigTree e iTOL são os mais usados. Eu prefiro iTOL quando preciso gerar imagens para publicação porque permite sobreposição de metadados, cores customizadas por grupo e exportação em alta resolução sem perder qualidade. O FigTree é mais rápido pra visualização exploratória, mas limitações de customização aparecem rapidamente quando você precisa de algo específico.
O que esperar de erros comuns
Long branch attraction é o problema mais frequente. Espécies com taxas evolutivas aceleradas tendem a se agrupar artificialmente, mesmo sem relação próxima. A correção passa por usar modelos mais complexos, remover ou recodificar sítios saturados, e quando possível, adicionar táxons que quebrem os ramos longos com sequência intermediária. Isso nem sempre é viável se os dados estão fixos no banco, mas vale tentar antes de aceitar a topologia como fato. Saturação de substituições é outro gatilho de erro. Se os sítios já trocaram nucleotídeos várias vezes ao longo da história, o sinal filogenético original se perde e sobra ruído. Testes de saturação com plot de transições versus transversões revelam isso facilmente. Quando a curvada achata, os dados não carregam informação suficiente pra profundidades maiores. Nesses casos, recodar aminoácidos em vez de nucleotídeos, ou usar genes mais conservados, resolve parcialmente. Nem sempre resolve completamente.
Alternativas quando a árvore não resolve
Se os dados são incompatíveis entre si de forma consistente — o que aparece como conflito topológico entre genes — uma árvore única pode não ser a melhor representação. Redes de vizinhança (neighbor-net) no SplitsTree mostram isso de forma visual. Conflitos não são necessariamente falha sua; podem indicar hybridização, transferência horizontal ouIncomplete Lineage Sorting. Cada um exige abordagem diferente. Ignorar o conflito e forçar uma árvore bifurcante é comum, mas simplifica demais a realidade. Para dados genômicos amplos, métodos coalescentes como ASTRAL ou SVDquartets calculam árvores de espécie a partir de árvores gênicas individuais. Isso trata a discordância entre genes de forma explícita, o que árvores concatenadas não fazem. A vantagem é real quando há história gênica heterogênea; a desvantagem é que exige árvores gênicas bem resolvidas como entrada, e se cada gene individual tiver pouca informação, o método propaga o erro.
Um insight que muda a leitura
A posição da raiz define tudo. Árvore não-roots é apenas um cladograma sem direção evolutiva. Rootear com um outgroup é o padrão, mas a escolha do outgroup importa muito. Se o outgroup for muito distante, introduz problemas de alinhamento e atração de ramos longos. Se for muito próximo, pode não quebrar o ramo corretamente. Eu já vi gente usar outgroups que estavam no mesmo clado interno por erro de taxonomia, e a árvore inteira invertia. Verificar a posição do outgroup com múltiplos genes antes de confiar num único marcador economiza retrabalho. Também vale notar que o formato Newick é extremamente simples, mas limitado. Ele não carrega metadados, incertezas multiníveis nem suporte pra redes. Quando o projeto cresce, migrar pra formatos como PhyloXML ou NDEx evita dor de cabeça posterior. A troca não é trivial, mas previne refeitura completa no futuro. O que eu aprendi depois de bastante tempo é que árvore filogenética é ferramenta, não destino. Ela resume hipóteses testáveis, não verdades absolutas. Dados melhores, modelos mais adequados e consciência dos limites metodológicos fazem mais diferença que qualquer opção de software. Se você conseguir manter isso em mente enquanto trabalha, os resultados ficam mais confiáveis e o tempo gasto com retrabalho diminui consideravelmente.
Galeria
-

o que são árvores filogenéticas? desenhe uma - brainly.com.br -
BIOLOGIA EREM PBMELO: Árvores Filogenética e cladograma: o que são isso? -
Blog de Biologia: Filogenias ou árvores filogenéticas
