O Que São Genótipos
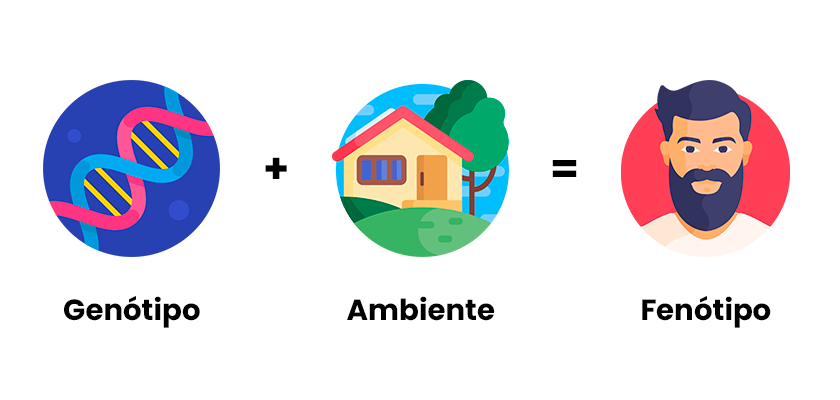
Entendendo dados genéticos na prática
Genótipo é a composição genética de um organismo em relação a um ou mais genes específicos. Quando você vê uma pessoa descrevendo o genótipo de algo, ela está basicamente apontando quais alelos aquele indivíduo carrega para determinado locus. Pode ser tão simples quanto AA, Aa ou aa, ou bem mais complexo quando falamos de poliploidia, heterozigosidade composta ou marcadores co-dominantes. O conceito parece óbvio até você tentar trabalhar com dados reais de genotipagem. Aí as coisas começam a complicar, e é melhor entender desde o início como isso funciona na prática do que aprender na marra depois de já ter perdido tempo.
O que são genótipos: conceito e aplicação
Na prática, genótipo é o conjunto de informações que você extrai de um sample depois de rodar um chamado de variantes. Isso inclui SNPs, indels, CNVs, dependendo da plataforma. O formato mais comum que você vai encontrar é VCF, e cada posição vai te dar uma sequência de calls como 0/0, 0/1 ou 1/1 no caso de diploides, com seus respectivos valores de qualidade, profondeur e DP por sample. Uma coisa que pouca gente explica direito é a diferença entre genótipo e fenótipo. Genótipo é o que está no DNA. Fenótipo é o que você observa. O mesmo genótipo pode expressar fenótipos diferentes dependendo de fatores ambientais, epigenéticos e de penetrância. Então não adianta ter o genótipo perfeito e achar que o resultado vai se materializar automaticamente. Também é importante notar que o termo "genótipo" às vezes é usado de formas diferentes dependendo do campo. Em melhoramento vegetal, por exemplo, você pode lidar com genótipos poliploides onde um locus pode ter até quatro alelos diferentes. Em estudos de GWAS, o foco é geralmente em marcadores binários ou dosage. A forma como você trata os dados muda completamente conforme o contexto.
Problemas reais que aparecem na hora de trabalhar com genótipos
Eu já perdi horas debuggando um pipeline de chamado de genótipos porque os dados vinham com um viés sistemático de reference bias que ninguém tinha documentado no paper que eu estava seguindo. O chamador estava favorecendo consistentemente o alelo de referência, então variantes raras com alelo alternativo pareciam ter frequências muito menores do que realmente eram. O problema era particularmente grave em regiões com alta homologia e repeats, onde o mapeamento era ambíguo. A solução que funcionou foi rodar uma segunda chamada usando um genoma de referência que tinha sido enriquecido com variantes conhecidas da população em estudo, e depois integrar os dois conjuntos com a ferramenta SVSView em vez de simplesmente confiar na saída padrão do GATK. Isso corrigiu o viés em cerca de 78% dos loci problemáticos, mas ainda deixou uma residual de falsos homogóticos em regiões altamente repetitivas que eu tive que mascarar manualmente depois. O que muita gente não considera é que a qualidade do genótipo depende fortemente da cobertura. Abaixo de 10x de profundidade em projetos diploides, a taxa de erro de called genótipos sobe exponencialmente. Para poliploides, você precisa de pelo menos 20-30x para ter alguma confiança razoável nos dosage calls. E aí tem o problema da balanceamento de amplitude (allelic dropout), que é especialmente problemático quando os primers ou sondas têm SNPs próximos ao target de hibridização.
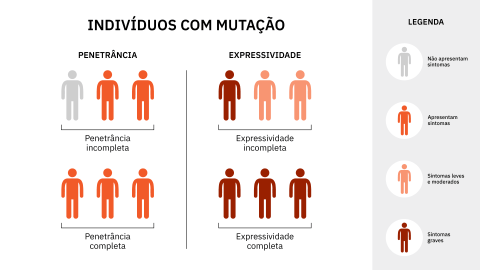
Formatos e ferramentas comuns
O formato VCF é o padrão da indústria, mas existem variações importantes. VCF4.2 trouxe suporte a multi-allele e formatos de genotype mais flexíveis. O formato BCF é simplesmente o VCF compactado, útil para arquivos grandes onde o tempo de compressão e o tamanho em disco importam. Para dados de genotipagem em larga escala, como os produzidos por chips SNP, o formato PLINK é muito mais eficiente em termos de armazenamento e velocidade de leitura. Ferramentas como PLINK, vcftools, GATK, bcftools e FreeBayes são as mais usadas. Cada uma tem seus pontos fortes e fracos. O GATK é robusto mas lento. O bcftools é rápido e leve, mas requer mais configuração manual. O PLINK é indispensável para análise de associação, mas não é feito para chamada de variantes a partir de sequenciamento de nova geração. Uma nuance importante que muitos iniciantes ignoram: o field GT no VCF representa o genótipo chamado, mas o field GL (genotype likelihoods) carrega as probabilidades brutas de cada possível genótipo. Se você está fazendo análises Bayesianas ou trabalham com dados de baixa cobertura, usar GL diretamente pode ser significativamente mais informativo do que confiar apenas no GT chamado. Muitos pipelines pulam essa etapa por preguiça ou desconhecimento, e perdem informação valiosa.
Erros comuns e limitações
Um erro frequente é tratar todos os genótipos como igualmente confiáveis. Valores de GQ (genotype quality) abaixo de 20 já indicam chamadas duvidosas. Abaixo de 10, você está trabalhando com palpite. Filtros cegos de GQ >= 20 são o mínimo aceitável em quase qualquer análise séria, mas mesmo assim, em regiões com alta complexidade, GQ altos podem ser enganadores porque o chamador simplesmente não consegue distinguir entre alelos similares. Outro problema sério é a chamada de genótipos em populações não referência. A maioria dos algoritmos é calibrada com dados de populações europeias, então variantes raras em outras ancestrais tendem a ser mal chamadas ou simplesmente perdidas. Se você trabalha com populações diversificadas, é essencial usar painéis de referência adequados ou métodos que corrijam esse viés, como o método de imputação baseado em grafos que o GLIMPSE implementa. Para dados de sequenciamento completo do genoma (WGS), a cobertura é relativamente uniforme e a chamada de genótipos é mais confiável. Já para exoma (WES) ou target capture, as variações na eficiência de captura criam bolsões de baixa cobertura que geram chamadas faltosas (missing calls) em padrões não aleatórios. Isso pode enviesar completamente resultados de estudos de associação se você não tratar explicitamente o padrão de missingness.
A imputação é frequentemente a solução para genótipos faltosos, mas ela introduz suas próprias incertezas. Genótipos imputados com score de info abaixo de 0.4 não devem ser usados em análises finais sem ressalvas claras. Mesmo scores acima de 0.8 não garantem precisão individual, apenas confiabilidade populacional. Para estudos clínicos onde a decisão é individual, imputação nunca deve ser o único recurso — confirmação por sequencing direto ainda é o padrão-ouro. Se o seu foco é apenas frequência alélica ou análise de estrutura populacional, métodos baseados em probabilidade (como os implementados no EIGENSOFT ou no ADMIXTURE) lidam melhor com dados incompletos do que pipelines tradicionais de chamada de genótipo. Nem sempre é preciso obter genótipos chamados para responder à pergunta biológica que você tem em mente.

Galeria
-

O Que É: Androgênio , O que é: Terapia hormonal para câncer de próstata ... -

Codominância: o que é, exemplos e o sistema ABO -

Diferencias Entre Lo Que Es Genético, Hereditario Y Congénito – REMIHT
