O Que Se Entende Por Diferença Individual

Entendendo a diferença individual na prática
Muita gente confunde diferença individual com variabilidade aleatória. São coisas diferentes, e tratar como iguais gera erros sérios em análises estatísticas, especialmente quando se trabalha com pequenos grupos ou estudos longitudinais. A diferença individual refere-se às variações consistentes e mensuráveis entre indivíduos dentro de uma população. Esses padrões não desaparecem com repetição – eles são estruturais. Diferença individual não é ruído. É sinal. Quando você mede a mesma variável em múltiplas pessoas ao longo do tempo, parte da variação que você observa vem de fatores que tornam cada pessoa única. Genética, história de vida, exposições ambientais anteriores, características fisiológicas estáveis – tudo isso contribui para diferenças individuais persistentes. O problema é que muitos analistas tratam essas diferenças como erro a ser removido, quando na verdade são exatamente o que importa estudar. Na minha experiência, o erro mais comum é poolar dados de indivíduos sem considerar essa variação. Já vi pesquisa com sessenta participantes onde o analista tratou todas as observações como independentes, ignorando que cinco medições de cada pessoa eram correlacionadas. O resultado? Intervalos de confiança absurdamente estreitos e valores-p inflados. A correção envolvia modelos de efeitos mistos com interceptos aleatórios por sujeito, mas já estava tarde para aquela análise.
Como identificar diferença individual nos seus dados
O primeiro passo é visualizar. Um gráfico de linhas com cada indivíduo representado por uma cor diferente mostra imediatamente se existem perfis distintos. Se todas as linhas seguem o mesmo padrão com apenas variações mínimas, provável que a diferença individual seja desprezível. Se algumas linhas ficam consistentemente acima ou abaixo das outras, ou se têm trajetórias diferentes ao longo do tempo, aí você tem sinal de diferença individual real. Depois da visualização, o teste intraclass correlation (ICC) é útil para quantificar quanto da variância total vem de diferenças entre indivíduos versus diferenças dentro dos indivíduos. Valores de ICC acima de 0,5 sugerem que a diferença individual é substancial e merece modelagem explícita. Abaixo de 0,2, provavelmente o ruído domina e os esforços devem ser voltados para outros fatores. A armadilha é que o ICC só funciona bem com dados balanceados e suficientes observações por indivíduo. No meu caso, trabalhei com dados de monitoramento contínuo onde alguns participantes tinham trinta dias de registro e outros apenas quatro devido a abandono. O ICC calculado com métodos tradicionais superestimou a confiabilidade porque o software assumia estrutura balanceada. A solução foi usar estimação por máxima verossimilhança com tratamento explicito dos tempos desiguais.
Metodologias para analisar diferença individual
Modelos de efeitos mistos são a ferramenta padrão, mas não a única. Eles permitem estimar simultaneamente efeitos fixos (o que acontece em média) e efeitos aleatórios (como os indivíduos variam em torno dessa média). O formato básico inclui um termo de intercepto aleatório por sujeito, capturando diferenças individuais na linha de base. Quando a variação individual também afeta a tendência temporal, adiciona-se uma inclinação aleatória. Isso é mais complexo de estimar e requer mais dados, mas reflete melhor a realidade quando indivíduos respondem de formas qualitativamente diferentes ao longo do tempo. Em um projeto com dados de sono, descobri que o efeito de cafeína variava drasticamente entre participantes: alguns dormiam pior com cafeína, outros não mostravam alteração significativa. Um modelo com inclinação aleatória captou isso; um modelo com apenas intercepto aleatório teria perdido completamente esse padrão. Outra abordagem, menos comum mas às vezes mais adequada, são modelos de trajetórias latentes. Em vez de modelar indivíduos como efeitos aleatórios, você presume que a população contém subclasses latentes de indivíduos com trajetórias similares. Isso é útil quando a diferença individual não é contínua mas sim categorial – por exemplo, quando existem subtipos distintos de respondedores a um tratamento.

Pegadinhas que quebram análises
A primeira é insuficiência de observações por indivíduo. Modelos de efeitos mistos com muitos parâmetros aleatórios precisam de pelo menos cinco a dez observações por sujeito para funcionar razoavelmente bem. Com menos, as estimativas de variância dos efeitos aleatórios ficam instáveis e tendem a zero artificialmente. Nesse caso, modelos Bayesianos com priors informados podem ajudar, mas exigem expertise adicional. A segunda pegadinha é confundir diferença individual com heterogeneidade não observada. Diferença individual deve ser modelada como variação aleatória estruturada; heterogeneidade não observada muitas vezes aparece como viés em modelos tradicionais. A distinção é sutil mas importante: diferença individual é algo que você pode (idealmente) medir e incorporar; heterogeneidade não observada é aquela que escapa e contamina seus coeficientes. Já perdi uma análise inteira porque negligenciei essa distinção. Estava modelando efeito de intervenção em saúde mental com dados agrupados por clínico. A variância entre clínicos era enorme, mas eu a tratei como diferença individual dos pacientes. Na verdade, o efeito do terapeuta dominava completamente, e os pacientes dentro do mesmo terapeuta se comportavam de forma mais semelhante do que a diferença individual justificaria. O modelo corrigido mostrou que quase toda a variância explicável vinha do nível clínico, não do paciente.
Quando diferença individual não existe (ou é irrelevante)
Nem todo estudo precisa modelar diferença individual. Variáveis biológicas altamente conservadas, como temperatura corpórea em condições controladas, frequentemente mostram pouca variação entre indivíduos. Variáveis coletadas sob protocolos rigorosos de padronização também tendem a reduzir diferença individual a níveis baixos. Nesses casos, forçar um modelo complexo apenas adicionaNoise e reduz poder estatístico. O teste de razão de verossimilhança comparando modelo com e sem efeitos aleatórios é a forma padrão de decidir. Se o modelo com efeitos aleatórios não melhorar significativamente o ajuste, simplifique. O mesmo vale para modelos com inclinações aleatórias – muitas vezes o intercepto já captura toda a diferença individual relevante. A limitação mais séria é que diferença individual, mesmo quando identificada, não explica causalidade. Ter variância entre indivíduos não significa que fatores mensuráveis expliquem essa variância. Muitos pesquisadores param na estimação dos efeitos aleatórios e tratam o assunto como resolvido. A etapa seguinte, que é explorar quais características predizem essas diferenças individuais, é onde a análise realmente se torna útil. Modelos multiníveis com covariáveis no nível individual permitem testar isso explicitamente.
Se você trabalha com dados repetidos ou agrupados, investir tempo em entender diferença individual evita erros de especificação que contaminam todas as inferências subsequentes. Comece visualizando, calcule ICC, modele com efeitos mistos adequados, e sempre questione se a variância restante tem estrutura ou é apenas ruído.
Galeria
-
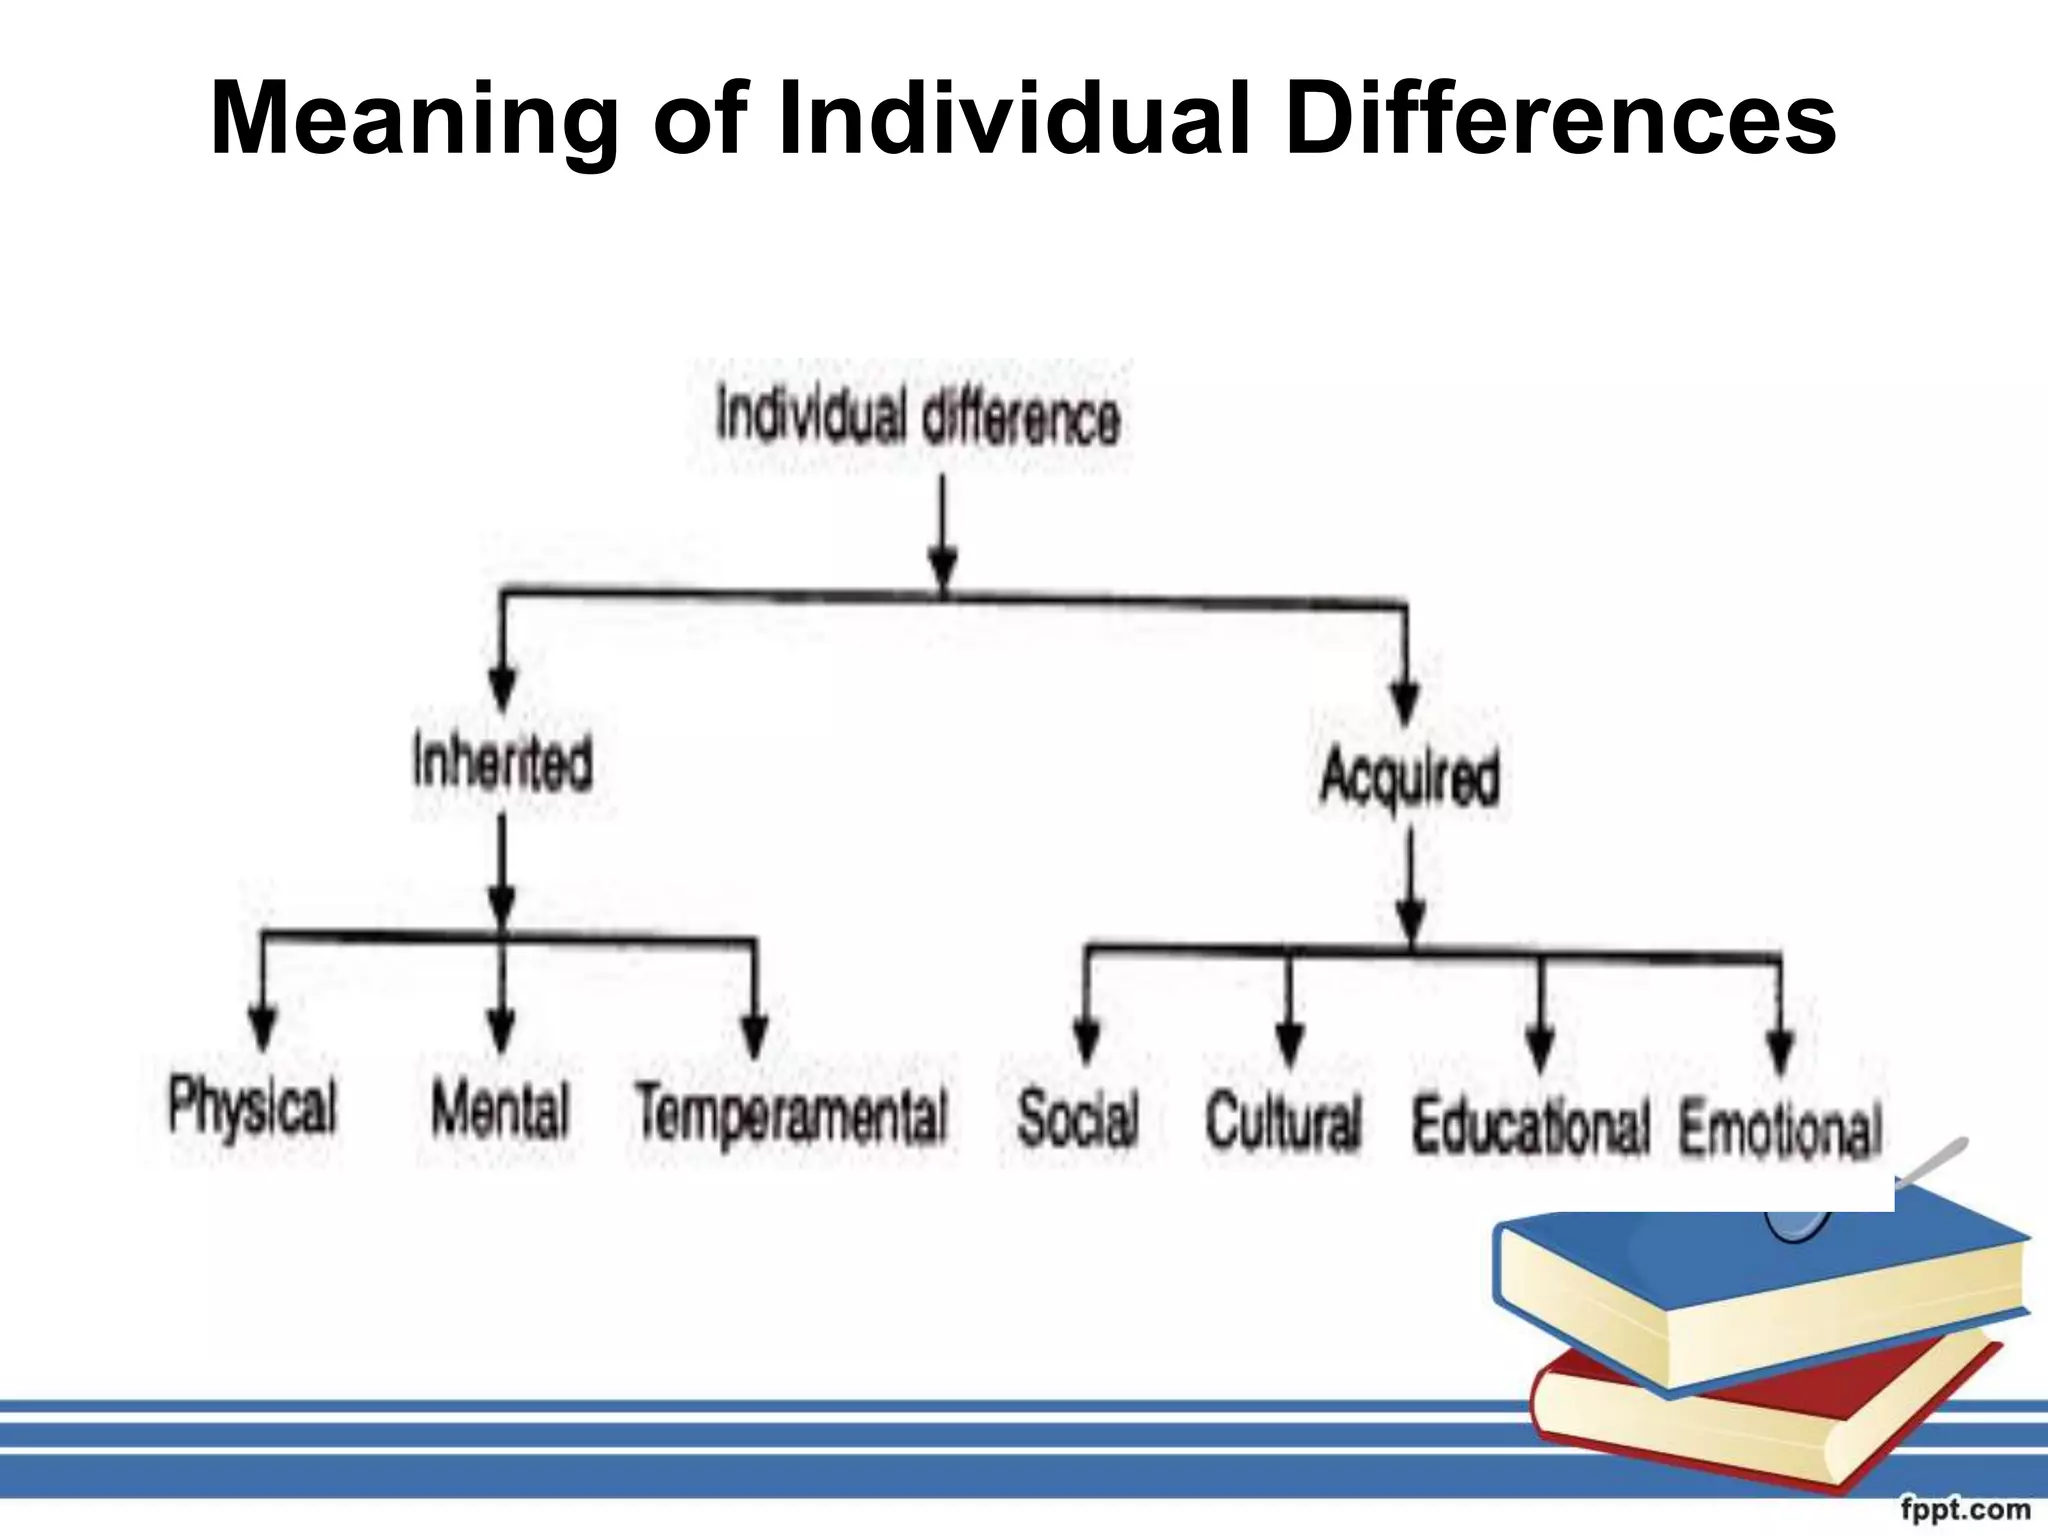
Individual difference | PPTX -
Como entender las diferencias individuales cun | PPT -
Características e Diferenças Individuais | PDF | Emoções | Ciência ...

