O Que Significa Log
Log no contexto de computação
A gente costuma confundir as coisas quando começa a mexer com sistemas. Tem o logaritmo da matemática, que é aquilo que você via no ensino médio, e tem o log mesmo, que é o registro de eventos que os programas geram o tempo todo. Quando alguém pergunta o que significa log, na maioria das vezes está se referindo ao arquivo de texto que fica guardado na sua máquina dizendo o que aconteceu com um software. Eu trabalhei com infraestrutura por muitos anos e já passei por situações em que precisei mergulhar em logs pra entender por que um serviço caía no meio da madrugada. O problema é que muito material pela internet mistura os dois conceitos, então fica confuso pra quem tá começando.
A diferença entre log de evento e logaritmo
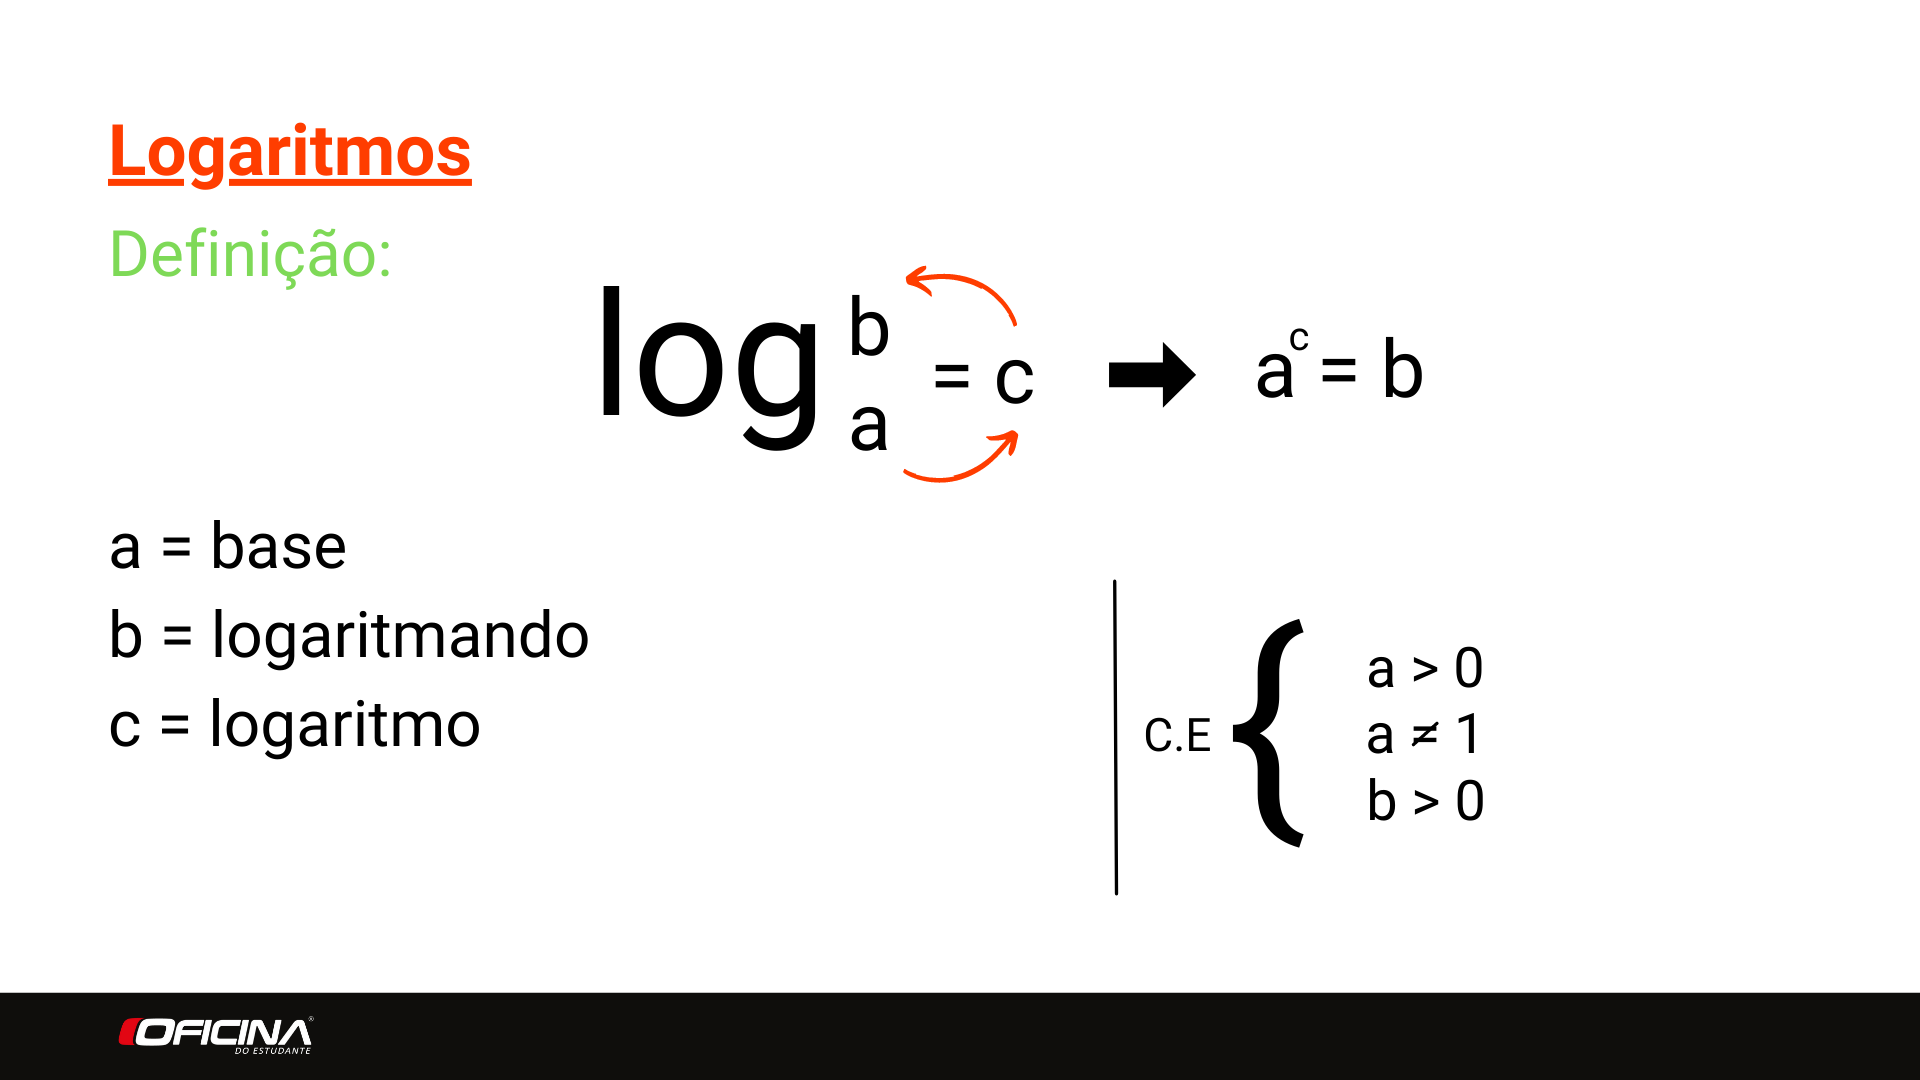
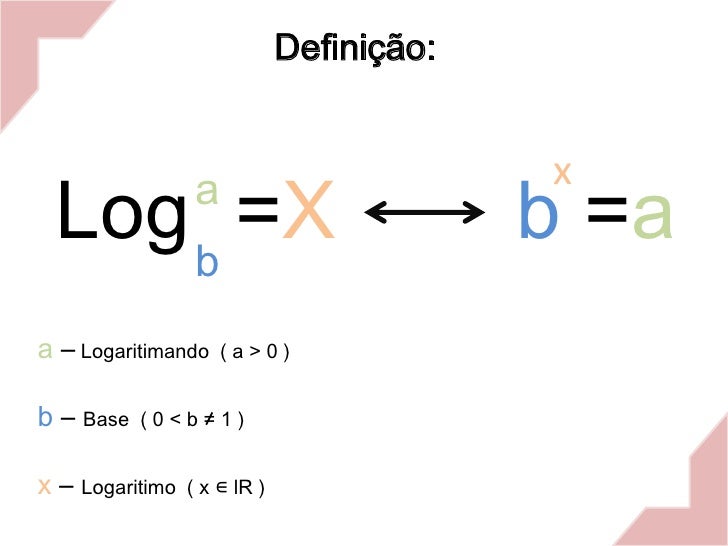
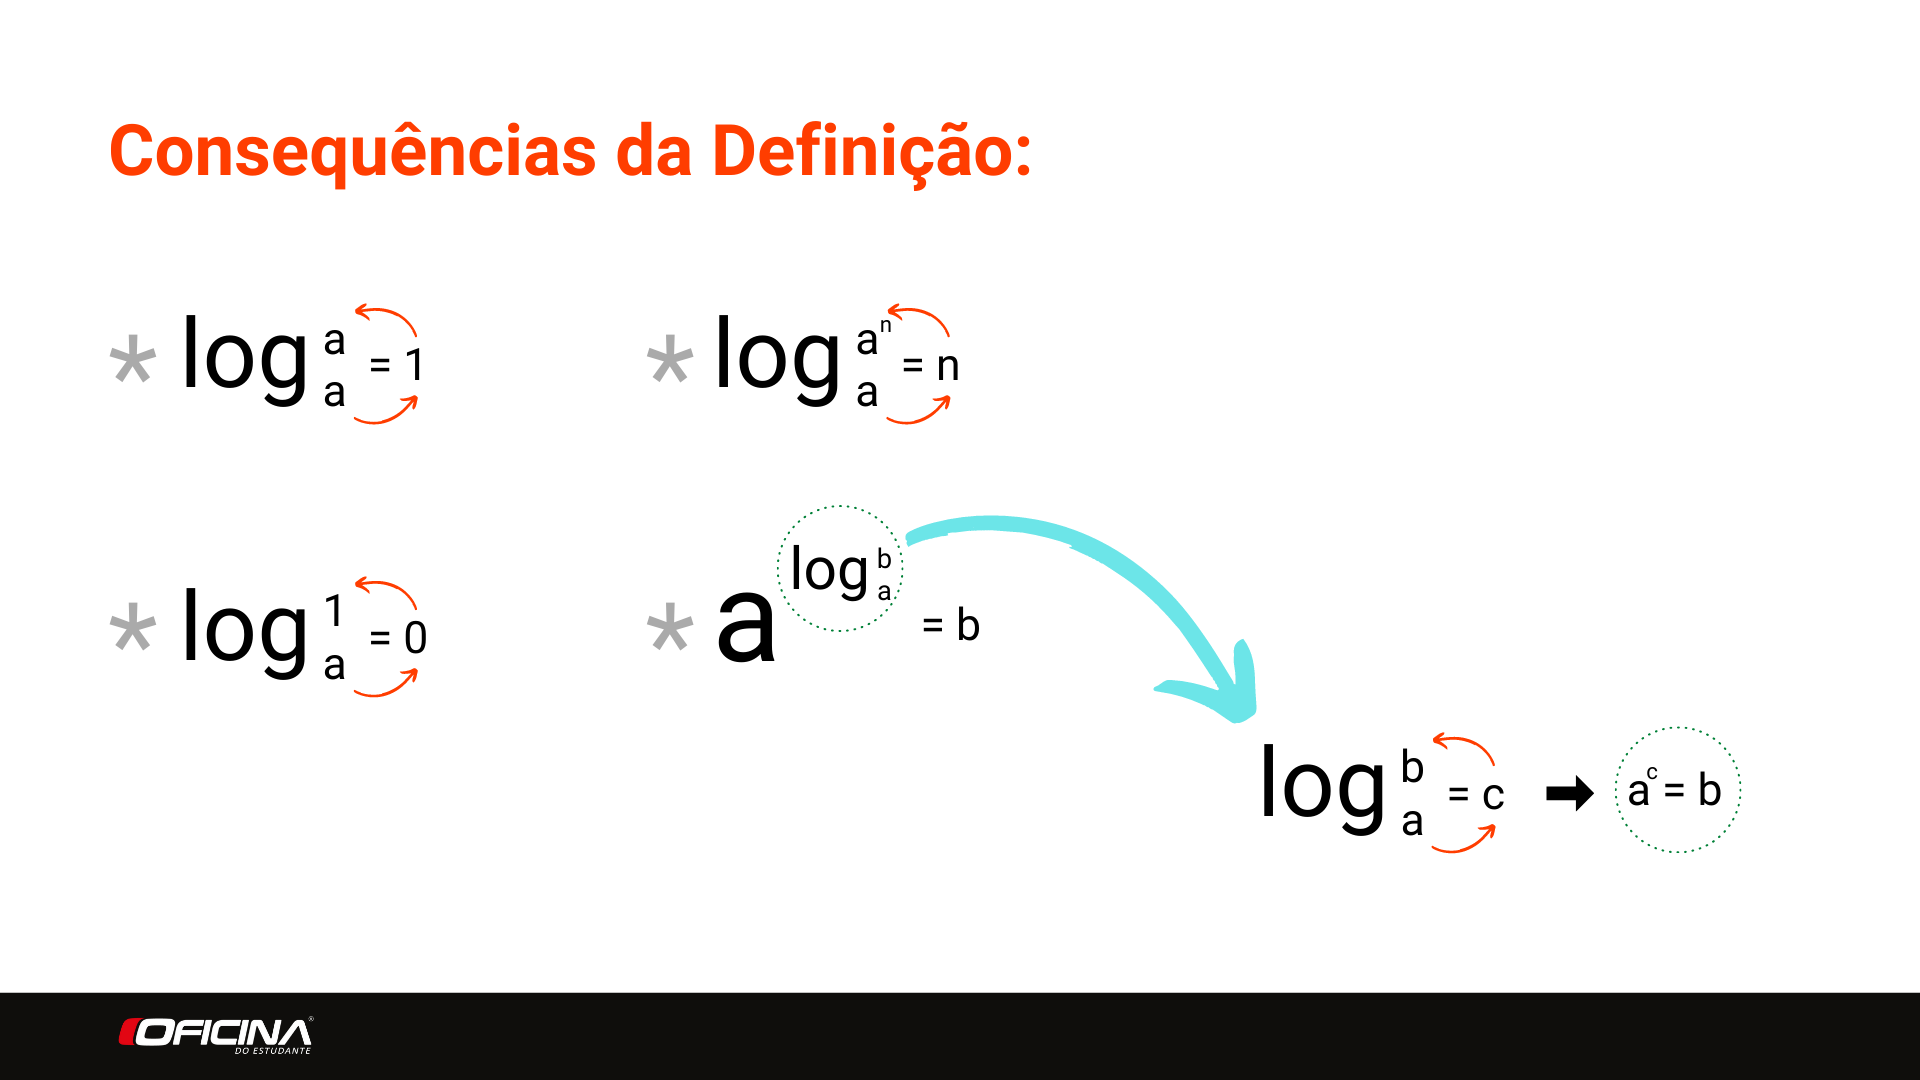
O logaritmo é uma operação matemática. Se você tem 1000 e quer saber quantas vezes precisa multiplicar o 10 por si mesmo pra chegar nesse número, a resposta é 3. Isso é log base 10. Já o log de computador é literalmente um diário. Todo sistema gera registros do que acontece nele. Quando você instala um programa, fecha uma conta num site, ou algo dá errado num servidor, isso vai pra um arquivo de log. Na prática, esses arquivos têm extensões como .log, .txt, ou às vezes ficam em diretórios específicos do sistema. No Linux, por exemplo, o diretório /var/log/ contém os logs do sistema inteiro. No Windows, você acha muitos deles em C:\Windows\Logs\. Cada um desses arquivos é uma linha do tempo do que aconteceu com aquela aplicação.
Como ler e interpretar logs na prática
Muita gente trava na hora de abrir um arquivo de log porque ele parece um monte de texto sem sentido. A realidade é que existe um padrão, mas os iniciantes não aprendem isso na maior parte das vezes. Um log bem formado tem timestamp, nível de severidade, e a mensagem em si. O timestamp te diz quando aconteceu. O nível de severidade te avisa se foi um aviso, um erro, ou algo crítico. A mensagem explica o que aconteceu. Eu lembro de uma vez em que um cliente tinha um servidor rodando uma API em Python que parava de responder aleatoriamente. O problema era que o log estava sendo truncado. O serviço gravava apenas as últimas 100 linhas antes de sobrescrever. Eu configurei o logrotate certinho e adicionei um sistema de rotação que mantinha os últimos 30 dias de histórico. Aí conseguimos ver que havia um erro de conexão com o banco de dados que ocorria toda quarta-feira às 3h da manhã, quando uma tarefa agendada rodava. Se você quer começar a ler logs hoje, o comando mais útil no Linux e no macOS é o tail. Ele mostra as últimas linhas de um arquivo. Com tail -f você acompanha em tempo real. No Windows, você pode usar o PowerShell com Get-Content -Tail 50 -Wait. Essas ferramentas economizam horas de trabalho em comparação com abrir o arquivo num editor de texto comum.
Níveis de severidade que todo log carrega
Os logs organizados usam níveis padronizados. DEBUG é o mais detalhado, geralmente desligado em produção porque gera muito volume. INFO registra eventos normais do funcionamento. WARNING indica algo fora do padrão que não impediu a operação. ERROR significa que algo falhou, mas o sistema continua rodando. CRITICAL é quando o serviço todo está comprometido. Aqui vai uma informação que poucos mencionam: many applications log errors but don't actually fix the root cause. O log mostra que houve um erro de memória, mas o código continua vazando memória. Eu já vi isso em sistemas Java onde o garbage collector não conseguia limpar objetos porque havia referências pendentes em variáveis estáticas. O log registrava OutOfMemoryError a cada duas horas, mas o desenvolvedor só via o erro e reiniciava o serviço, sem resolver o problema de fundo. Outro detalhe importante é o formato do timestamp. Alguns logs usam UTC, outros usam horário local. Se você trabalha com equipes distribuídas, isso causa confusão. Eu recomendo sempre converter tudo pra UTC nas primeiras etapas de análise. Uma diferença de fuso horário pode fazer você achar que dois eventos são relacionados quando na verdade estão horas apartados.
Log rollover e gestão de arquivos
Um dos problemas mais comuns que eu vejo é o crescimento descontrolado dos arquivos de log. Um serviço mal configurado pode gerar centenas de gigabytes em poucos dias. O log rollover resolve isso dividindo o arquivo em partes menores ou apagando os antigos automaticamente. No Python, você usa o RotatingFileHandler ou o TimedRotatingFileHandler do módulo logging. No Java, o Log4j2 tem o RollingFileAppender. No Node.js, o winston e o pino oferecem opções similares. A configuração básica define o tamanho máximo do arquivo e quantas cópias manter. Eu uso sempre no mínimo 7 cópias rotacionadas, porque um bug intermitente pode demorar uma semana pra se repetir. Existe uma armadilha comum aqui. Se você configurar o logrotate sem cuidado, pode acabar descartando logs importantes. Eu já perdi evidências de um ataque porque o script de rotação estava executando antes do backup noturno dos logs. A solução foi separar os diretórios de log ativo e log arquivado, e criar um cronjob que copiava os arquivos antes de qualquer rotação.
Centralização de logs em ambientes reais
Quando você tem mais de uma máquina, ler logs localmente não funciona mais. Você precisa de centralização. As opções vão desde soluções simples até plataformas caras. O ELK Stack (Elasticsearch, Logstash, Kibana) é o mais citado, mas exige bastante recurso. O Loki, da Grafana, é mais leve e tem crescido muito. Para times pequenos, o Papertrail ou o Loggly oferecem planos gratuitos razoáveis. A grande vantagem da centralização é a correlação. Você consegue ver num mesmo painel o que aconteceu no serviço A e no serviço B no mesmo intervalo de tempo. Sem isso, você gasta horas tentando sincronizar informações de múltiplas máquinas manualmente. Uma limitação séria que poucas pessoas discutem abertamente: logs centralizados custam dinheiro. Cada gigabyte enviado pra plataforma externa é um custo recorrente. Em ambientes de alta carga, isso pode chegar a milhares de dólares por mês. A solução é ser seletivo. Configure os serviços críticos com verbose logging e os menos importantes com apenas ERROR e acima. Reduz o custo em até 80% sem perder visibilidade real.
Ferramentas úteis para trabalhar com logs
Além dos comandos básicos de terminal, existem ferramentas gráficas e especializadas. O glogg é bom pra visualizar logs grandes sem travar. O GoLess é mais moderno e permite buscas em tempo real. Para Windows, o Event Viewer funciona, mas é limitado. O DebugView captura logs de aplicação em nível de sistema, o que é útil pra depuração profunda. Se você trabalha com containerização, o docker logs é essencial. Ele mostra o stdout e stderr dos containers. Com docker-compose logs -f você acompanha todos os serviços de uma vez. O problema é que por padrão o Docker não mantém histórico após o container ser destruído. Se você precisa de persistência, precisa configurar um log driver externo como o json-file com size e max-file limitados. Uma dica prática que pouca gente conhece: o journalctl no systemd permite filtrar logs por serviço, por nível de severidade, e por período de tempo. Com journalctl -u nome-do-servico --since "2 hours ago" você encontra rapidamente o que precisa sem vasculhar arquivos inteiros. Isso economiza muito tempo em incidentes.
Erros comuns ao analisar logs
O primeiro erro é ler o log inteiro linha por linha. Ninguém consegue fazer isso eficientemente. Use busca. grep para texto simples, regex para padrões complexos. O segundo erro é ignorar o contexto. Um erro isolado pode ser irrelevante. Uma sequência de warnings idênticos pode indicar um problema grave. Olhe o padrão, não apenas o evento único. O terceiro erro é não levar em conta a ordem dos eventos. Logs podem chegar fora de ordem em sistemas distribuídos devido a latência de rede. Se você assume que a ordem no arquivo é a ordem real dos eventos, pode construir uma cadeia causal errada. Em sistemas que usam message queues, o tempo de processamento pode ser significativamente maior que o tempo de recebimento. Outro ponto importante: logs não são perfeitos. Eles podem ter gaps, linhas truncadas, caracteres corrompidos. Eu já vi logs de aplicativos Windows em português com acentos que chegavam completamente ilegíveis em servidores configurados com locale padrão C. A solução era forçar o UTF-8 na geração dos logs ou usar filtros de decodificação antes de processar.
Segurança e logs
Logs são ativos de segurança tão importantes quanto qualquer dado do negócio. Eles registram acessos, tentativas de login, mudanças de configuração, e tudo mais que um atacante pode deixar pra trás. Por outro lado, se alguém compromis um sistema, os logs são o primeiro alvo pra apagar evidências. Por isso a integridade dos logs importa. Assinatura digital, forwarding em tempo real pra um servidor separado, e imutabilidade são práticas recomendadas. O syslog RFC 5424 define formatos padronizados que facilitam a auditoria. Ferramentas como OSSEC e Wazuh fazem monitoramento de integridade de logs automaticamente. Uma prática simples que resolve muito problema: nunca armazene logs apenas localmente. Sempre envie uma cópia pra um servidor central ou pro cloud assim que o log é gerado. Se o servidor local for comprometido ou formatado, você ainda terá o histórico completo em outro lugar.
Logs e conformidade regulatória
Dependendo do setor, você é obrigado por lei a manter logs por determinado período. LGPD no Brasil, GDPR na Europa, HIPAA nos EUA, PCI-DSS pra cartões de crédito. Cada uma tem requisitos diferentes sobre retenção, criptografia, e acesso. Ignorar isso pode gerar multas pesadas. Eu trabalhei num projeto onde a empresa precisava manter logs de acesso por cinco anos por exigência do PCI-DSS. A solução foi um sistema de arquivamento em disco com retenção automática e replicação pra fita. O custo de armazenamento era alto, mas era necessário. Não adianta reclamar da regulamentação, você precisa se adaptar. O básico pra quem quer aprender é entender que log é informação estruturada sobre o comportamento de um sistema. Saber ler isso economiza horas de debugging. Saber gerenciar isso evita dor de cabeça com armazenamento. Saber proteger isso é essencial pra segurança. Se você dominar esses três pilares, já está à frente da maioria das pessoas que mexem com tecnologia no dia a dia.
Galeria
-

Regras De Logaritmo Criar Regras De Alerta De Pesquisa De Log Do Azure -
Que Es Un Logaritmo Y Sus Partes Y
