Organizar Por Ordem Alfabetica

Como organizar por ordem alfabética funciona na prática
Organizar por ordem alfabética parece simples até você tentar fazer isso com mais de mil registros e descobrir que a ferramenta que você está usando não está fazendo o que você acha que está fazendo. Vou explicar como isso realmente funciona e onde as coisas costumam dar errado. O conceito em si é direto. Você pega um conjunto de strings e as compara caractere por caractere, do início ao fim, usando a tabela de codificação do sistema. Em português, a ordem padrão segue o colacion da sua locale: A, B, C, D, E, F, G, H, I, J, K, L, M, N, O, P, Q, R, S, T, U, V, W, X, Y, Z. Mas ai é que mora o problema, porque "ordem padrão" varia drasticamente dependendo de onde você está rodando o código. No Excel, por exemplo, o sort default é case-sensitive em algumas versões e insensible em outras. Isso significa que nomes como "Silva" e "silva" podem terminar em posições diferentes dependendo do seu setup. Eu passei duas horas num projeto de migração de dados descobrindo que os sobrenomes dos clientes estavam ordenados de forma inconsistente porque metade vinha de planilhas do Excel 2016 e a outra metade do Google Sheets. As duas ferramentas usam algoritmos de ordenação diferentes por padrão.
A maneira mais confiável de garantir uma ordenação consistente é forçar a locale explicitamente. Em JavaScript, você usa String.prototype.localeCompare() passando 'pt-BR' como segundo argumento. Em Python, usa-se a biblioteca PyICU ou a key com locale.strxfrm(). Em SQL, depende do collation da sua coluna — MySQL, por exemplo, deixa você escolher entre utf8mb4_general_ci e utf8mb4_unicode_ci, e a diferença pratica entre eles é significativa para textos em português com acentos.
O problema que ninguém conta
Vocês já se depararam com a letra "Ç"? Porque eu sim. Quando eu estava limpando uma base de dados com cerca de 15 mil nomes portugueses e brasileiros, a maioria dos sistemas ignorava o Ç e tratava como se fosse um C normal. Isso gerava empates na ordenação que quebravam a lógica de apresentação. A solução que funcionou foi usar uma regra customizada no collation: mapear Ç para a sequência "C" + "S" durante a classificação, mantendo o valor original na exibição. Outro problema recorrente é a acentuação. Letras acentuadas como Á, É, Õ, Ã costumam ser Tratadas como variantes das letras base em colações case-insensitive, mas em many implementations elas acabam indo para o final da lista ou sendo ignoradas completamente. No SQLite, por exemplo, a ordenação padrão coloca "São Paulo" depois de "Zé", o que não faz sentido nenhum em português. A workaround é usar COLLATE UNICODE ou aplicar uma função de normalização Unicode (NFC) antes de ordenar. Também vale mencionar que espaços, hifens e caracteres especiais afetam a ordenação. Um nome como "O'Brien" vai terminar antes de "Obrien" em quase todas as implementações porque o apóstrofo tem um código ASCII menor que a letra. Eu tive que decidir se mantinha essa ordenação "tecnicamente correta" ou se normalizava os dados removendo pontuação antes de classificar. Normalizar foi a escolha mais pragmatica.

Quando organizar por ordem alfabetica falha
A principal limitação é que a ordenação alfabética pura não funciona bem com nomes próprios, títulos ou qualquer coisa que não siga um padrão consistente. Sobrenomes compostos, partículas nobiliárquicas ("van", "de", "von"), e nomes com múltiplos elementos geram resultados que parecem errados para usuários humanos mesmo quando estão tecnicamente corretos segundo o algoritmo. Uma alternativa que eu recomendo em casos assim é usar a ordenação natural (natural sort), que tenta entender o contexto dos dados. Numa lista de arquivos como "documento1.pdf", "documento10.pdf", "documento2.pdf", a ordenação clássica coloca "documento10" entre "documento1" e "documento2", o que é incorreto do ponto de vista humano. Ferramentas como o strnatcmp no PHP ou bibliotecas como natural-sort no npm resolvem isso. Se você precisa de algo mais robusto e está lidando com volumes grandes, considere usar um motor de busca como o Elasticsearch com um analyzer específico para português. Ele trata acentos, stop words e stemming de forma muito mais inteligente do que qualquer sort nativo de planilha ou query SQL simples.
Para a maioria dos casos do dia a dia, forçar a locale, normalizar acentos com NFC e tratar caracteres especiais manualmente resolve 95% dos problemas. O resto é ajuste fino dependendo do seu caso específico.
Galeria
-

Como Organizar Uma Tabela Em Ordem Alfabetica -
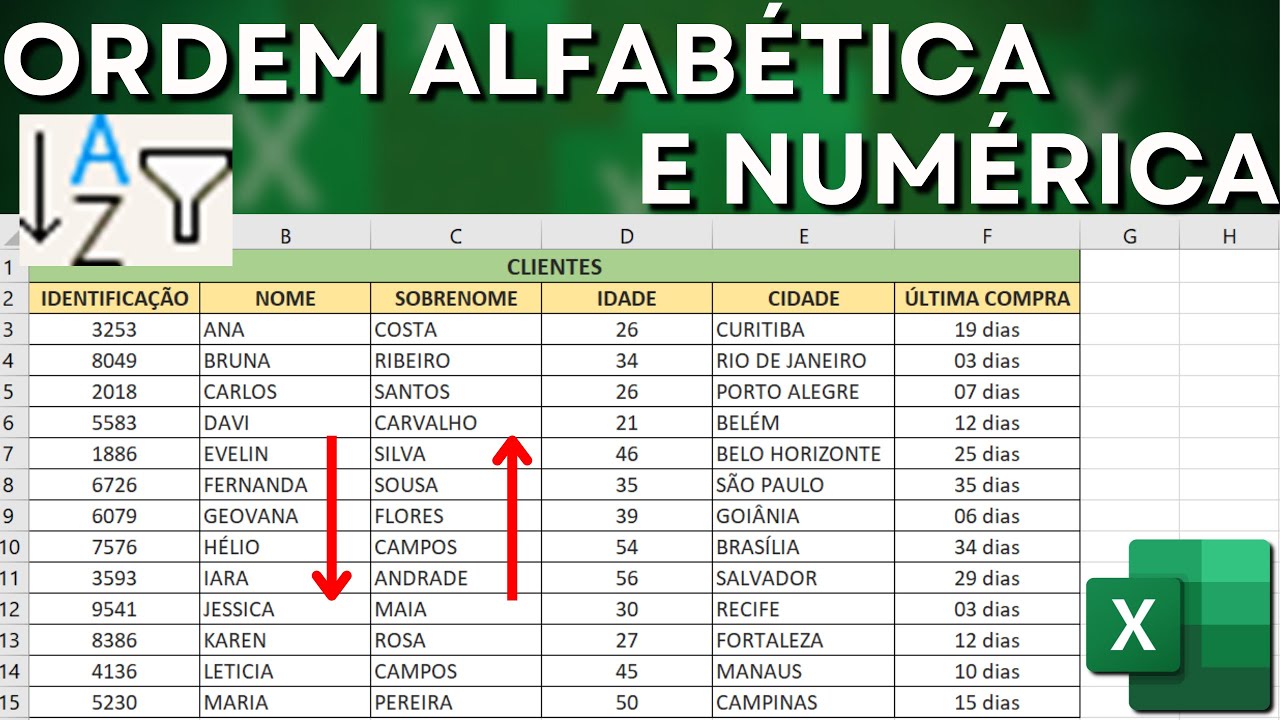
Por Em Ordem Alfabetica - FDPLEARN -
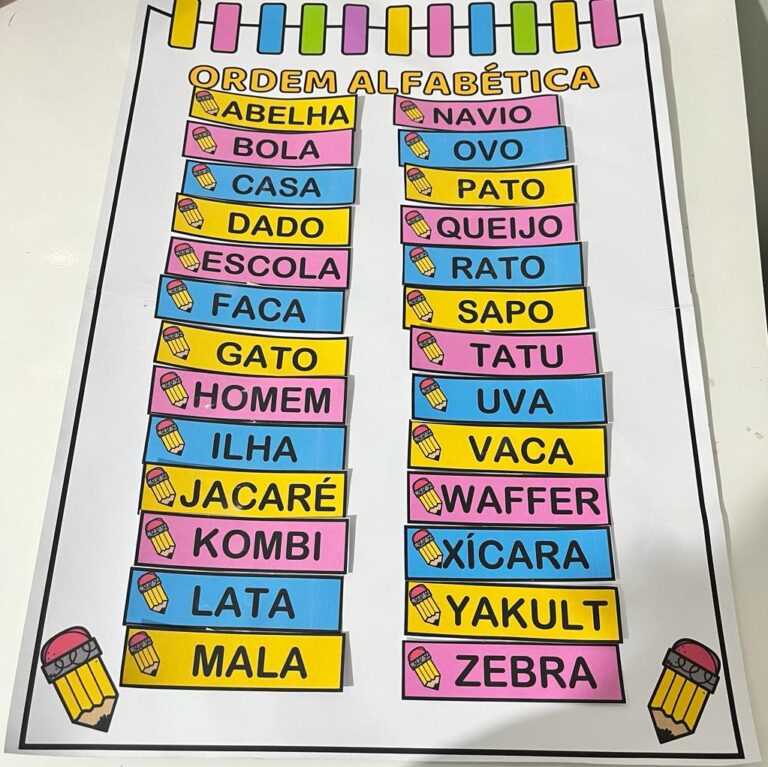
RECURSO ORDEM ALFABÉTICA – Loja de recursos pedagógicos Professora Michelle -

Atividades de Ordem Alfabética para Imprimir
