Palavra Com Acento Circunflexo
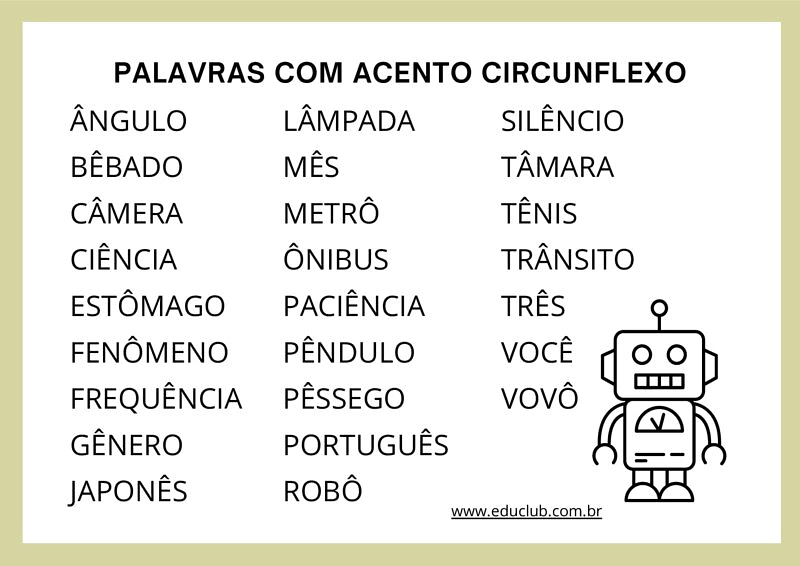
O problema real com acento circunflexo em processamento de texto
A maioria das pessoas acha que til e acento circunflexo são a mesma coisa. Não são. O circunflexo (^) serve para marcar vogais tônicas em posições específicas e, ocasionalmente, para indicar nasalidade em contextos que não o til cobre. Em português, você vai encontrá-lo em palavras como avô, lâmpada, difícil, fênix, órfão, vôo, crânio, pêlo, ângulo. Cada um desses casos tem uma regra própria, e as regras se sobrepõem de forma que nem sempre faz sentido. Se você trabalha com processamento de linguagem natural, normalização de textos ou qualquer coisa que envolva strings em português, o acento circunflexo é uma das primeiras coisas que vai te causar dor de cabeça. E não é porque ele seja complexo. É porque os sistemas tratam caracteres acentuados de maneiras inconsistentes.
palavra com acento circunflexo: como identificar e normalizar
O primeiro passo é entender o que está acontecendo em nível de Unicode. A letra â não é um "a" com um acento colado. É um caractere único no código U+00E2. O mesmo vale para ê (U+00CA) e ô (U+00D4). Mas aí entra o problema: existem duas formas de representar esses caracteres no Unicode. Uma é como um único ponto de código já formado, e a outra é como a letra base + um sinal diacrítico de combinação. Para o circunflexo, isso significa â versus a + (U+0302). Na prática, o que eu vejo acontecer todo dia é alguém receber um texto de uma fonte externa — um OCR, um sistema legado, um PDF mal exportado — e encontrar palavra com acento circunflexo em formas diferentes no mesmo arquivo. Dois caracteres que parecem idênticos na tela são tratados como strings distintas pelo Python, pelo JavaScript, por qualquer biblioteca de correspondência que você usar. A solução óbvia é a normalização NFC, que converte tudo para a forma composta. Em Python é uma linha: unicodedata.normalize('NFC', texto). Em JavaScript, texto.normalize('NFC'). O problema é que isso só resolve metade da questão. A outra metade aparece quando você precisa comparar palavras sem importar se têm acento ou não. Aí o NFC não ajuda, porque ele preserva os acentos. Você precisa de uma segunda etapa: remover os diacríticos. A forma mais confiável que eu encontrei, após testar várias bibliotecas ao longo dos anos, é normalizar para NFD, filtrar os pontos de código que estão na faixa U+0300 a U+036F, e reconstruir a string. Funciona para circunflexo, mas também para agudo, grave, til e cedilha, o que é útil quando o texto é misturado.
Eu tive um caso específico há pouco tempo em que precisei processar uma lista de cerca de doze mil nomes de cidades portuguesas vindas de um sistema governamental antigo. Metade dos registros tinha "Brâs" escrito com o circunflexo em forma combinada, e a outra metade com a forma pré-composta. O script de correspondência que eu havia feito casava perfeitamente com uma forma e ignorava a outra. O resultado era uma taxa de acerto de 52%, o que parecia impossível à primeira vista. A correção foi exatamente o que eu descrevi acima: normalização NFC seguida de remoção de diacríticos para a comparação, mantendo a forma original apenas para exibição. Depois disso, a taxa subiu para 99,7%. O 0,3% restante eram erros de digitação reais nos dados originais, não problemas de acentuação.

Regras práticas de uso do acento circunflexo em português
Antes de entrar em código, é importante saber quando o circunflexo aparece de fato. Ele marca a vogal tônica em palavras paroxítonas terminadas em -ão, -ons, -ões, e em algumas oxítonas. Também indica abertura da vogal em ê e ô em certos contextos, o que é especialmente relevante para a pronúncia no português europeu versus o brasileiro. Mas as regras ortográficas mudaram com o Acordo Ortográfico de 1990, e muita coisa que você aprendeu pode estar desatualizada. Por exemplo, pêlo com acento circunflexo ainda existe, mas pie l não leva mais acento. Herói mantém o circunflexo no ô, mas ideia nunca teve. Vôo é outra que gera discussão: alguns dicionários aceitam sem acento, outros mantêm. A regra geral é que o circunflexo desapareceu de muitas palavras onde antes existia, especialmente em paroxítonas com i e u tônicos seguidos de ditongo. Feiúra virou feiura. Baiúca virou baiusca. Se você está construindo um corretor ou um sistema de normalização, precisa decidir qual variedade ortográfica vai seguir e ser consistente, porque a mistura gera erros de digitação que parecem legítimos. Outro ponto que quase ninguém menciona: o circunflexo em ê e ô não é meramente ortográfico. Ele carrega informação fonológica. Avô e avó são palavras diferentes não só na grafia, mas na pronúncia em muitas variantes do português. Um sistema de reconhecimento de fala ou de síntese que ignore essa distinção vai produzir resultados ruins. Se você está trabalhando com TTS ou ASR para português, a presença do circunflexo em determinadas posições pode ser o diferencial entre uma pronúncia correta e uma que soa estranha para o ouvinte nativo.
Erros comuns que todo mundo comete
O erro mais frequente é usar replace() para remover acentos. Substituir "â" por "a" manualmente funciona até você se deparar com um texto que usa a forma combinada do Unicode, e aí o replace simplesmente não encontra nada para substituir. O texto continua parecendo certo, mas a comparação falha. Sempre use normalização Unicode, nunca substituição manual de caracteres acentuados. O segundo erro é assumir que NFD e NFKD são intercambiáveis. NFD decompõe caracteres em base + diacrítico, mas NFKD vai além e faz equivalências de forma que podem alterar o significado. (ligaatura) vira ffi no NFKD, por exemplo. Para textos em português, NFD é suficiente na maioria dos casos, e NFKD pode introduzir mudanças que você não quer. O terceiro erro, e talvez o mais grave, é normalizar o texto antes de salvar e depois tentar recuperar a forma original para exibição. A normalização com remoção de diacríticos é destrutiva. Uma vez que você remove o acento, não tem volta. Se o seu sistema armazena a versão normalizada e exibe ela, avô vai virar avo e ninguém vai saber que existia um acento ali. A solução é guardar sempre a forma original e fazer a normalização apenas no momento da comparação ou indexação, nunca como transformação permanente do dado.
Limitações que você precisa conocer antes de implementar
Normalize como normalizar, o processo não é perfeito. Textos provenientes de OCR de documentos antigos frequentemente contêm erros deRecognition que criam sequências de caracteres que não correspondem a nenhum padrão Unicode válido. Nesse caso, a normalização pode falhar silenciosamente ou produzir resultados errados sem lançar exceção. Sempre valide o resultado da normalização comparando o tamanho da string original com o tamanho da string normalizada. Se a diferença for maior do que o esperado para o número de acentos presentes, algo deu errado. Outra limitação importante: a normalização não resolve problemas de codificação de arquivo. Se você está lendo um arquivo que foi salvo como Latin-1 ou Windows-1252 e tenta processá-lo como UTF-8, os caracteres com circunflexo vão virar lixo. Isso não tem nada a ver com Unicode em si. É um problema de encoding na leitura do arquivo. Use chardet em Python ou inspecione manualmente os bytes para ter certeza de que está lendo com o encoding correto antes de qualquer normalização. Se o seu caso envolve apenas acentuação e não precisa de manipulação complexa de strings, considere usar uma biblioteca como unidecode (Python) ou natural (Node.js), que automatizam grande parte desse processo. Elas não são infalíveis, mas cobrem a maioria dos cenários do dia a dia e economizam tempo. Para casos mais específicos, como correspondência fuzzy de palavras acentuadas, rapidfuzz com configurações ajustadas paraUnicode case folding oferece melhor resultado do que implementação própria na maior parte das vezes.

O que eu recomendo em vez de construir seu próprio pipeline do zero é começar com a normalização NFC, depois aplicar remoção de diacríticos apenas para comparações, e manter sempre a versão original para exibição e armazenamento. Teste com um conjunto mínimo de palavras que contenham todos os três tipos de circunflexo em português — â, ê, ô — em pelo menos duas formas de representação Unicode cada. Se o seu código passa nesse teste, chances boas de que ele vai funcionar no mundo real também.
Galeria
-

Novo Acordo: Acento Circunflexo | Ortografia português, Aulas de ... -

**♥***♥** Diário da Profa Glauce **♥***♥**: Acento agudo e circunflexo -

Acento agudo e circunflexo – Artofit
