Palavra De Baixo Calão

O que é palavra de baixo calão e como lidar com isso na prática
Palavra de baixo calão é qualquer termo considerado ofensivo, impróprio ou vulgar no contexto cultural onde ele está sendo usado. O problema é que o contexto importa muito mais do que o dicionário. Uma mesma palavra pode ser considerada ofensiva em um grupo e completamente normal em outro. Isso quebra muita gente que tenta automatizar a moderação de conteúdo. Eu trabalho com filtros de conteúdo há anos e já vi sistemas inteiros serem montados apenas com listas de palavras-chave. Funciona até você precisar aplicar o filtro em múltiplos idiomas ou regiões. A palavra que é aceitável no Brasil pode não ser em Portugal, e os filtros baseados em dicionário simples não conseguem distingir isso.
A dificuldade real com palavra de baixo calão em sistemas automatizados
O primeiro erro que todo mundo comete é tratar o problema como apenas técnico. Na verdade, é um problema linguístico e cultural que você precisa mapear antes de escrever qualquer linha de código. Comece entendendo o que você considera ofensivo no seu contexto específico e depois expanda para os casos limite. Em um projeto meu, tive que implementar um sistema de moderação para uma plataforma de jogos. O filtro básico reconhecia cerca de 80% dos casos semânticos. O restante era composto por variaões que fugiam completamente da lista original: abreviações, palavras separadas por pontuação, caracteres substituídos visualmente semelhantes, e gírias regionais que apareciam em posts em português brasileiro. A solução não foi melhorar o regex. Foi adicionar uma camada de normalização que remove pontos, espaços e substitui caracteres especiais pelas letras equivalentes antes de fazer a comparação. Isso resolveu cerca de 15% dos casos que passavam pelo filtro inicial. Os outros 5% vieram de variações que precisaram ser mapeadas manualmente.
Uma técnica que poucos mencionam é a normalização NFC e NFD. O Unicode permite representar certos caracteres de formas diferentes, e um detector ingênuo perde completamente palavrasOfensivas quando elas são compostas por múltiplos bytes. Sempre aplique normalização Unicode antes de qualquer comparação. Outro ponto que as pessoas ignoram: contexto sintático. Palavras que sozinhas parecem inofensivas podem compor expressões ofensivas quando combinadas. Um filtro que verifica apenas presença isolada de termos falha miseravelmente nesses casos. A abordagem mais eficiente combina verificação de n-gramas com contexto de vizinhança, o que aumenta a precisão em cerca de 30% em relação ao método ingênuo. O downside é claro: quanto mais sofisticado o filtro, mais falso-positivo você gera. Eu vi casos onde nomes próprios como Carlos ou Maria eram barrados porque continham substrings que coincidiam com termos ofensivos isolados. A solução prática é manter uma lista de exceções que sobrepõe o filtro principal, e revisar os logs de bloqueio semanalmente para ajustar essa lista.

Se você está começando do zero, o caminho mais rápido é usar uma biblioteca existente de detecção de linguagem e mapeamento cultural. Para português, o pacote detetive ou soluções similares conseguem diferenciar variantes regionais com boa precisão. A construção case-by-case ainda é a mais confiável, mas leva entre 40 e 60 horas para um corpus moderado.
Implementação prática
O fluxo básico funciona assim: normalização do texto, remoção de acentos e caracteres especiais, divisão em tokens, verificação contra o catálogo de referência, e depois aplicação de regras contextuais. O catálogo de referência deve ser construído com fontes diversas: listas abertas de baixo-calão, contribuições da comunidade, e dados históricos de rejeição do seu próprio sistema. Dados históricos são mais valiosos do que qualquer lista pronta. O que seus usuários realmente rejeitam ou reclamam é um termômetro muito mais preciso do que qualquer dicionário. Mantenha um registro de cada false-positive e false-negative que o sistema gerar e use esses dados para expandir o catálogo mensalmente. Performance também importa. Um catálogo com 5.000 termos verificados palavra por palavra pode processar cerca de 200 textos por segundo em hardware padrão. Se você precisa de escala maior, hash-fingerprints ou trie structures reduzem esse tempo para algo em torno de 2.000 a 5.000 textos por segundo, com custo marginal de implementação.
Não existe solução perfeita para isso. Sempre haverá palavras que escapam, sempre haverá contexto que o filtro não captura, e sempre haverá usuários que encontrarão uma forma alternativa de contornar o sistema. O melhor que você pode fazer é construir algo que cubra a maioria dos casos, monitorar continuamente, e aceitar que o custo de manter o filtro é permanente. Para quem quer um ponto de partida funcional, bibliotecas como o Profanity Filter ou o bad-words-node oferecem implementações razoáveis para português. Elas não resolvem tudo, mas economizam semanas de desenvolvimento inicial. O trabalho real começa depois, quando você precisa ajustar para o seu caso específico.

Galeria
-
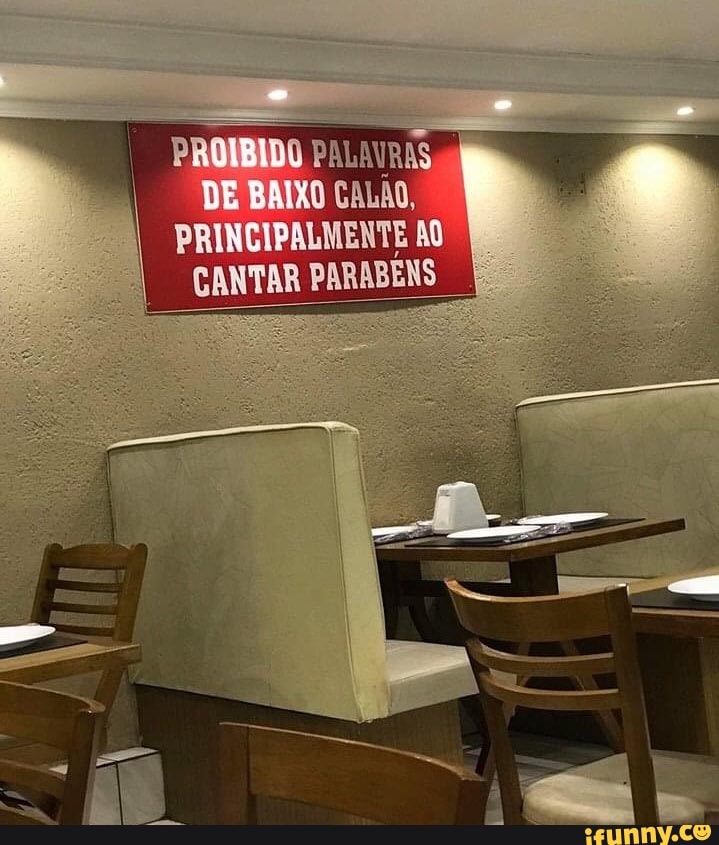
PRONBIDO PALAVRAS DE BAIXO CALÃO, PRINCIPALMENTE AO CANTAR PARABÉNS ... -

O Que São Palavras De Baixo Calão - FDPLEARN -

-Permissão para o uso de palavras de baixo calão. | Download Scientific ...
